
大模型原理与训练 / 系统课时
配置批处理与上下文长度
配置批处理与上下文长度
这一节要把“能启动”的量化模型调到“能稳定承载真实流量”。核心不是把上下文、批量和并发全部拉满,而是在固定显存下分配权重、激活与 KV Cache 预算,再用真实请求长度逐步找到吞吐、尾延迟和 OOM 风险都可接受的区间。
学习目标
- 理解最大上下文、并发序列、批内 Token 上限与 KV Cache 的联动关系
- 能用 vLLM 配置一组可验证的初始参数,并根据显存与延迟逐步调优
- 能区分“吞吐提升”和“单请求更快”,避免只看 QPS 做错误判断
先看清显存预算
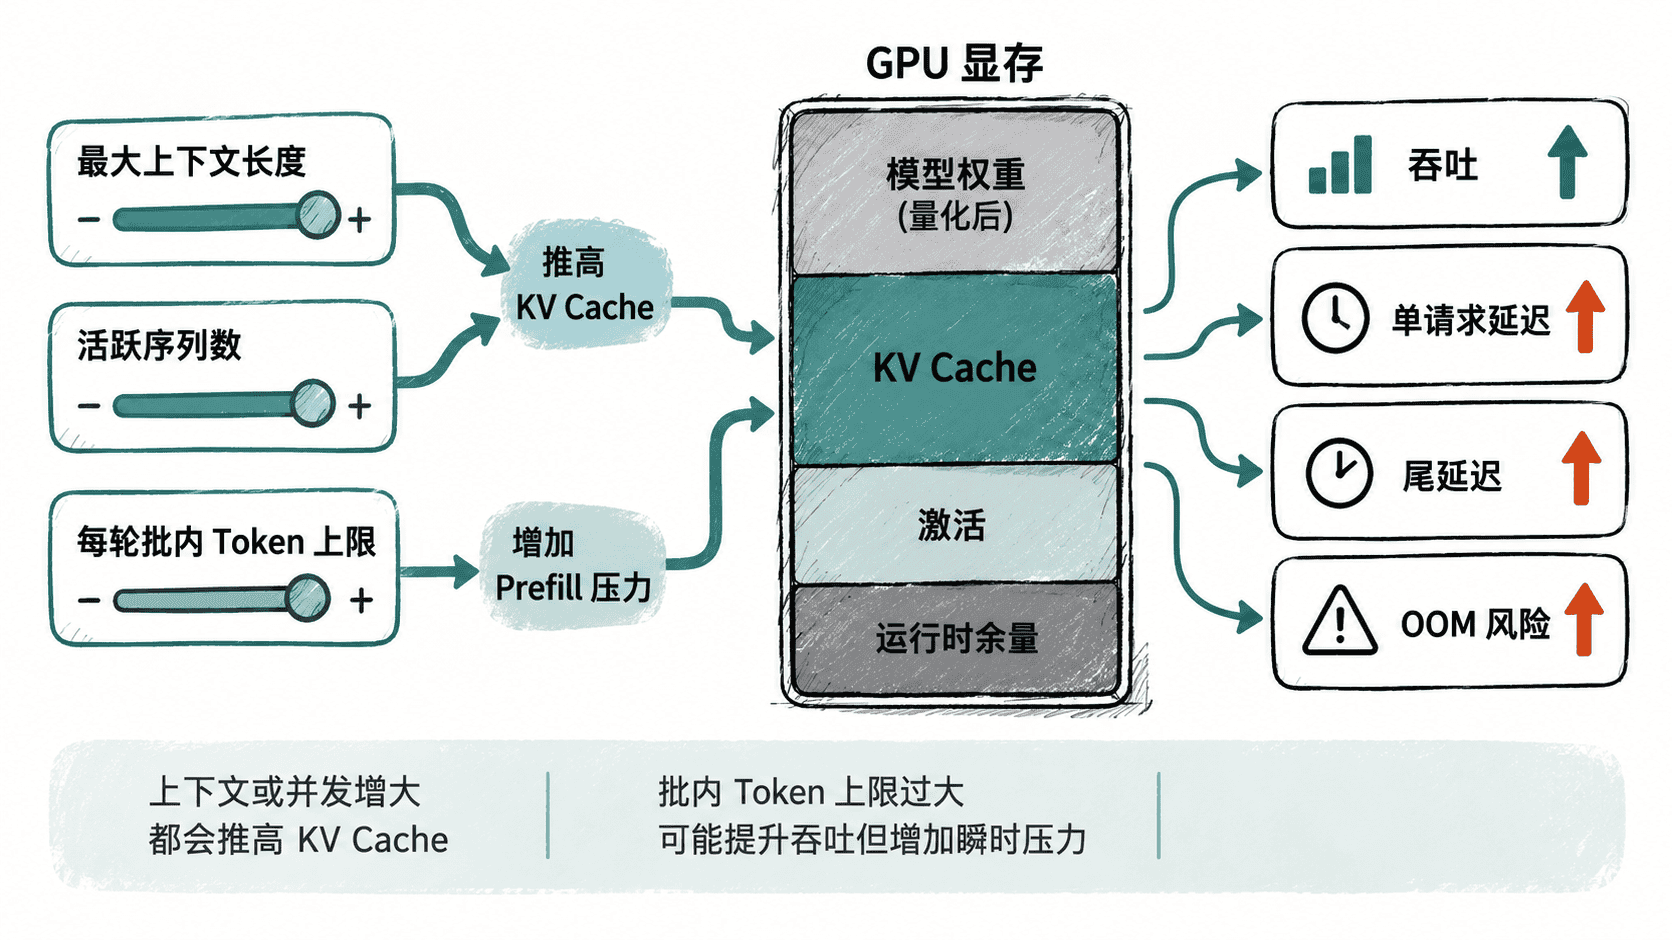
量化主要减少模型权重占用,但推理显存并不只放权重。长上下文和高并发会持续扩大 KV Cache;Prefill 阶段还需要激活与临时工作区。因此,同一份 4-bit 权重在 2K 上下文、8 路并发时稳定,并不代表在 16K 上下文、64 路并发时仍能运行。
KV Cache 的规模可以先用“与有效 Token 数近似成正比”来理解:单请求越长、同时存活的序列越多,缓存越大。权重量化也不会自动把 KV Cache 一并量化,除非推理引擎明确启用了对应的 KV Cache 数据类型。
用一组保守参数启动
下面用 vLLM 演示可落地的起点。运行前把 <PATH> 替换为量化模型目录,把 <PORT> 替换为实际端口。--max-model-len 限制单序列最大长度,--max-num-seqs 限制同时参与调度的序列数量,--max-num-batched-tokens 控制一次调度批次可处理的 Token 上限。
MODEL_PATH="<PATH>"
PORT="<PORT>"

vllm serve "$MODEL_PATH" \
  --served-model-name quantized-model \
  --host 0.0.0.0 \
  --port "$PORT" \
  --max-model-len 4096 \
  --max-num-seqs 16 \
  --max-num-batched-tokens 8192 \
  --gpu-memory-utilization 0.90
预期结果
服务成功进入运行态;实际启动日志会随 vLLM 版本和硬件不同。
/v1/models 可访问,并能看到模型名 quantized-model。
这里的 0.90 不是“显存一定用到 90%”的业务目标,而是给引擎的显存预算边界。若机器还要同时运行监控、其他 CUDA 任务或同卡多进程,应主动留出更大余量。
按真实请求长度逐步放大
调优时一次只改变一个维度,否则很难判断收益来自哪里。先统计真实请求的输入 Token 分布和期望输出长度,再把 max-model-len 设到能够覆盖业务高分位请求的值,而不是机械使用模型声明的最大上下文。
接着固定上下文长度,逐步提高 max-num-seqs。如果吞吐上涨但 P95/P99 延迟恶化明显,说明调度排队与资源竞争已经开始抵消收益。最后再调整 max-num-batched-tokens,观察 Prefill 较长请求出现时是否导致尾延迟尖峰。
找到稳定区间
稳定区间不是某个固定参数组合,而是一段“再增加负载就开始明显恶化”的边界。判断时可以按以下顺序收敛:
- 先保证最长业务请求不会因为
max-model-len被拒绝。 - 在不 OOM 的前提下提高
max-num-seqs,找到吞吐收益开始变小的位置。 - 调整
max-num-batched-tokens,让长 Prefill 不至于长期挤压短请求。 - 做持续压测而不是短时冒烟测试,确认显存没有缓慢逼近上限,尾延迟也没有持续抬升。
如果一提高并发就 OOM,优先降低并发或上下文,而不是继续提高 GPU 显存利用率;如果显存充足但尾延迟升高,则问题更可能来自排队和批处理策略。最终要保留的是可复现的安全余量,而不是实验室里刚好不报错的极限值。