
大模型原理与训练 / 系统课时
区分对称与非对称量化
区分对称与非对称量化
对称量化和非对称量化都把浮点值映射为整数,但它们对可表示区间和零点的安排不同。本节用同一组数据分别计算两种编码方式,比较量化步长、零点和误差,再结合权重、激活分布与硬件后端选择方案。
学习目标
- 能说明对称量化与非对称量化在 Scale、Zero Point 和数值范围上的区别
- 能用同一组数据比较两种方案的编码效率与误差上界
- 能结合权重、激活分布和推理后端支持选择量化方式
两种方案的核心差异
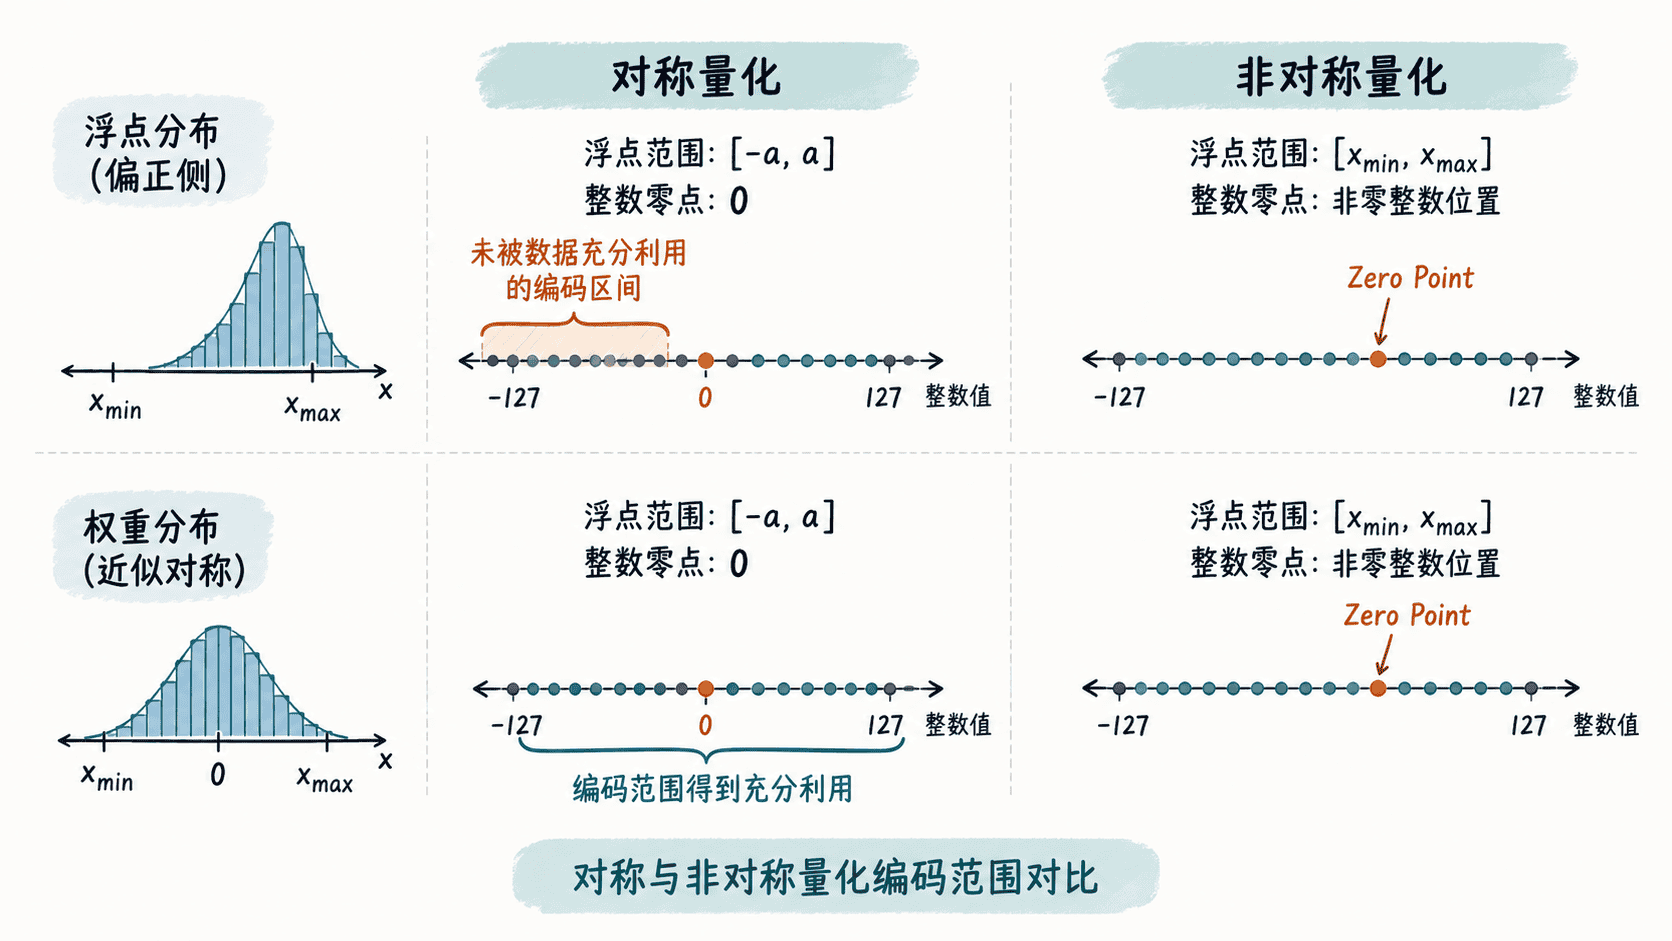
对称量化先取绝对值最大的边界,把浮点范围扩成以零为中心的 [-a, a]。Zero Point 通常固定为 0,正负数共享相同尺度。以常见的对称 INT8 表示为例,可以使用 [-127, 127],Scale 为:
非对称量化不要求区间围绕零对称,而是直接让 [xmin, xmax] 对齐到完整整数范围。例如映射到 [-128, 127] 时:
因此它的 Zero Point 往往不是 0。这样可以避免为了保持对称而给数据实际不会出现的区域预留大量编码。
用同一组数据比较编码效率
假设一组待量化数据的范围是 [-0.9, 1.8]。如果采用对称 INT8,需要先把范围扩成 [-1.8, 1.8],并使用 [-127, 127]:
Zero Point 为 0。由于真实最小值只有 -0.9,从 -1.8 到 -0.9 的一部分整数编码几乎不会被实际数据使用。
如果采用非对称 INT8,并直接把 [-0.9, 1.8] 映射到 [-128, 127]:
对应的 Zero Point 约为 -43。同样覆盖这些真实数据时,非对称方案获得了更小的 Scale,也就是更密的量化格点。
| 项目 | 对称量化 | 非对称量化 |
|---|---|---|
| 实际数据范围 | [-0.9, 1.8] |
[-0.9, 1.8] |
| 用于量化的浮点范围 | [-1.8, 1.8] |
[-0.9, 1.8] |
| Zero Point | 0 | 约 -43 |
| Scale | 约 0.01417 | 约 0.01059 |
更小的 Scale 意味着理论上的舍入误差上界更小,但不代表每一个具体样本都一定比另一种方案误差小。量化后的误差还取决于样本恰好位于哪个格点附近,因此应比较整体误差或任务指标,而不是只检查单个数值。
权重和激活为什么常采用不同选择
神经网络权重通常同时包含正值和负值,而且不少层的分布大致围绕零展开。这样的数据使用对称量化时,不需要明显扩大范围,Z=0 也能简化整数乘加中的零点处理,所以许多推理内核优先为对称权重量化提供高效实现。
激活的情况更依赖算子。例如经过 ReLU 后的数据通常从 0 开始并向正方向延伸,如果强行使用以零为中心的对称范围,负数一侧的大量编码不会被使用。允许 Zero Point 偏移的非对称量化可以更充分利用有限编码,但具体收益还取决于后端是否高效支持相应的零点补偿。
按数据分布和硬件做选择
选择量化方式时,可以依次检查四个问题:
- 数据是否大致以零为中心。如果正负范围接近,对称量化通常能充分使用编码。
- 数据是否明显偏向一侧。如果大量取值集中在非负区间或整体存在偏移,非对称量化往往能减少范围浪费。
- 零点处理是否会增加计算成本。某些高性能内核对
Z=0的权重量化支持更直接,而非零 Zero Point 需要额外补偿。 - 后端真正支持什么。即使离线误差更低,如果目标推理引擎不支持对应位宽、粒度或零点形式,也无法按预期部署。
不要把“权重一定对称、激活一定非对称”当成固定规则。实际模型可能出现明显偏移的权重,也可能存在天然对称的激活分布。更稳妥的流程是先看校准分布和量化误差,再用目标硬件上的真实 kernel 验证延迟、吞吐与精度。对称与非对称量化的选择,本质上是在编码利用率、数值误差和硬件执行成本之间取平衡。