
大模型原理与训练 / 系统课时
用 8 位权重降低加载显存
用 8 位权重降低加载显存
本节把同一因果语言模型分别以 FP16 与 bitsandbytes 8 位方式加载,用一致提示词记录运行时权重占用、加载峰值显存、生成峰值显存和输出文本,最终得到一套可复用的 A/B 测量方法,而不是只凭“8 位约等于减半”做容量判断。
学习目标
- 用
BitsAndBytesConfig(load_in_8bit=True)与device_map="auto"完成 8 位加载。 - 区分检查点文件大小、模型运行时 footprint 与 CUDA 峰值显存三个指标。
- 用同一提示词比较 FP16 与 INT8 的显存、速度和生成结果,并识别后端限制。
先分清 8 位加载压缩了什么
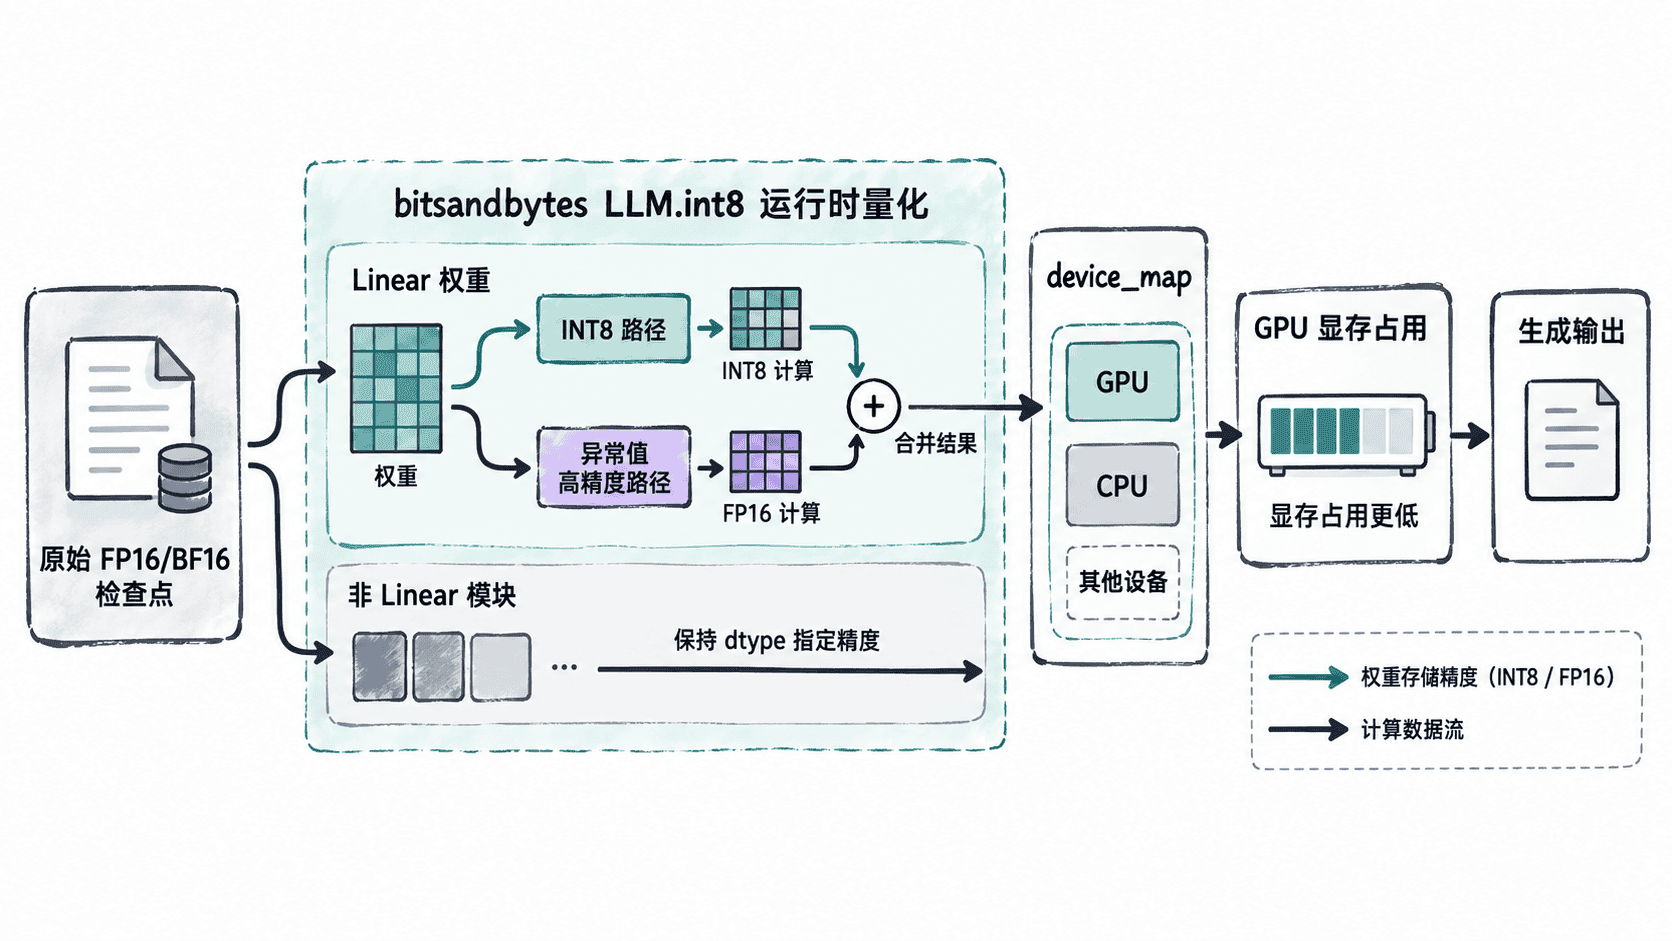
bitsandbytes 的 LLM.int8() 主要替换模型中的线性层计算与权重表示。普通权重走 INT8 路径,异常值会保留更高精度处理,再合并计算结果,因此它不是“把模型里每个张量都粗暴改成 int8”。LayerNorm 等非线性层仍由 dtype 等加载参数决定精度。
运行时量化也不等于原始 Hub 检查点文件自动变小。model.get_memory_footprint() 反映模型当前驻留内存,而 torch.cuda.max_memory_allocated() 记录当前进程在 CUDA 上的峰值分配;两者回答的是不同问题。若需要比较磁盘体积,应把量化模型另存后再统计保存目录。
用同一脚本做 FP16 与 INT8 A/B
实验环境需要已安装兼容的 PyTorch、Transformers、Accelerate 与 bitsandbytes。下面脚本默认运行 INT8;把 --mode 改为 fp16 即可用同一模型、提示词和生成参数复测。为让显存指标可直接比较,本实验要求 NVIDIA CUDA,并汇总所有可见 GPU 的峰值分配。
import argparse
import time

import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig

MODEL_ID = "facebook/opt-125m"
PROMPT = "Machine learning deployment is"

def total_peak_mib():
    total = 0
    for index in range(torch.cuda.device_count()):
        total += torch.cuda.max_memory_allocated(index)
    return total / 1024**2

def reset_peaks():
    for index in range(torch.cuda.device_count()):
        torch.cuda.reset_peak_memory_stats(index)

def synchronize_all():
    for index in range(torch.cuda.device_count()):
        with torch.cuda.device(index):
            torch.cuda.synchronize()

def load_model(mode):
    kwargs = {
        "device_map": "auto",
        "dtype": torch.float16,
    }
    if mode == "int8":
        kwargs["quantization_config"] = BitsAndBytesConfig(load_in_8bit=True)
    return AutoModelForCausalLM.from_pretrained(MODEL_ID, **kwargs)

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--mode", choices=["fp16", "int8"], default="int8")
    args = parser.parse_args()

    if not torch.cuda.is_available():
        raise SystemExit("This benchmark requires CUDA for VRAM measurement.")

    tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
    torch.cuda.empty_cache()
    reset_peaks()

    model = load_model(args.mode)
    load_peak = total_peak_mib()
    footprint = model.get_memory_footprint() / 1024**2
    inputs = tokenizer(PROMPT, return_tensors="pt").to(next(model.parameters()).device)

    # 先预热一次,避免把首次 kernel 初始化混入吞吐测量。
    with torch.inference_mode():
        model.generate(**inputs, max_new_tokens=32, do_sample=False)
    synchronize_all()
    reset_peaks()

    started = time.perf_counter()
    with torch.inference_mode():
        output = model.generate(**inputs, max_new_tokens=32, do_sample=False)
    synchronize_all()
    elapsed = time.perf_counter() - started

    new_tokens = output.shape[-1] - inputs["input_ids"].shape[-1]
    print(f"mode={args.mode}")
    print(f"runtime_footprint_mib={footprint:.1f}")
    print(f"load_peak_allocated_mib={load_peak:.1f}")
    print(f"generate_peak_allocated_mib={total_peak_mib():.1f}")
    print(f"new_tokens={new_tokens}")
    print(f"tokens_per_second={new_tokens / elapsed:.2f}")
    print("text=" + tokenizer.decode(output[0], skip_special_tokens=True))

if __name__ == "__main__":
    main()
预期输出
mode=int8
runtime_footprint_mib=<MIB>
load_peak_allocated_mib=<MIB>
generate_peak_allocated_mib=<MIB>
new_tokens=<TOKENS>
tokens_per_second=<TOKENS_PER_SECOND>
text=<TEXT><MIB>、<TOKENS>、<TOKENS_PER_SECOND> 和 <TEXT> 会随 GPU、驱动、库版本与模型缓存而变化;验收重点是字段齐全,并用同一环境再跑一次 fp16 后比较差值。首次运行还可能出现模型下载进度,它不属于脚本的稳定输出。
怎么读这些数字
先看 runtime_footprint_mib,它最接近“量化后模型本体在内存里多大”;再看 load_peak_allocated_mib,它决定加载阶段是否会 OOM;最后看 generate_peak_allocated_mib,其中还会包含生成期间的激活、临时工作区与 KV Cache,所以不会简单等于权重大小。
8 位通常能明显降低权重相关显存,但不要期待所有模型都严格减半。Embedding、LayerNorm、缓存和运行时缓冲区不会按同一比例缩小,小模型还容易被固定开销淹没。速度也不保证更快:量化核、反量化、批大小和 GPU 架构都会改变吞吐。
质量比较必须固定提示词、解码参数和最大新 Token 数。贪心解码下,如果 FP16 与 INT8 文本一致,只能说明这个样例没有暴露差异;上线前仍应在真实验证集上比较任务指标、拒答率或人工评分,而不能把单条生成当成质量证明。
后端与设备映射的边界
bitsandbytes 的可用后端、驱动和功能支持会随版本变化,因此部署前应核对目标硬件对应的支持矩阵。本实验采用 CUDA,是为了用 torch.cuda 统一测量显存;换到其他后端时,应保留同样的 A/B 方法,但改用该平台可靠的内存统计接口。
device_map="auto" 适合快速判断模型能否装入现有设备,但多 GPU 或显存紧张时,最终层放置可能与单卡假设不同。生产部署应记录实际设备映射,不要只记录一个总显存数字。若额外启用 CPU offload,还要把 CPU 内存成本一起计入容量评估。
完成 A/B 后,只有在峰值显存满足容量目标、吞吐没有不可接受的回退、真实验证集质量仍在阈值内时,8 位加载才算真正可上线。