
游戏引擎 / 系统课时
按需使用 Deep Profile
按需使用 Deep Profile
CPU Usage 出现脚本耗时尖峰时,直接开启 Deep Profile 可能让游戏变得更卡,甚至掩盖原本的性能特征。本课比较普通采样、Call Stacks 与 Deep Profile 的记录粒度和额外开销,演示如何先缩小问题范围,再短时间启用深度分析,最终用低开销采样验证真正的优化收益。
学习目标
- 区分普通 Profiler 样本、Call Stacks 调用栈与 Deep Profile 方法插桩的用途。
- 使用 Call Stacks 和
ProfilerMarker定位问题,判断何时需要开启 Deep Profile。 - 在 Unity 6.3 LTS 中完成深度采样,并排除插桩开销造成的性能误判。
区分三种采样粒度
Unity Profiler 默认依赖已经存在的 Profiler Marker 记录 CPU 活动。它能显示 MonoBehaviour.Update 等入口、Unity API 中已插桩的调用,以及开发者主动添加的标记,但不会自动把所有 C# 方法展开为完整调用树。
例如,EnemyAI.Update() 调用了 FindTarget(),后者又调用 ScoreCandidate()。普通 Profiler 可能只能看到外层 Update 及已标记的内部操作,无法直接知道未插桩的两个 C# 方法各耗时多少。
Unity 6.3 提供以下定位手段:
| 定位方式 | 能看到的内容 | 额外开销 | 适用情况 |
|---|---|---|---|
| 普通 CPU Usage | 已有 Marker、线程活动和时间线 | 相对较低 | 首次确定长帧和耗时区域 |
| Call Stacks | 指定事件发生时的完整调用链 | 增加采集开销,通常低于 Deep Profile | 追踪分配或同步等待来源 |
| 自定义 ProfilerMarker | 开发者指定代码区间的耗时 | 通常较低,取决于标记频率 | 已知可疑模块,需要细分耗时 |
| Deep Profile | 托管方法内部的细粒度调用样本 | 很高,可能显著增加 CPU 和内存消耗 | 常规标记不足以解释 C# 调用热点 |
这里有一个容易混淆的区别:Call Stacks 记录特定事件发生时的方法调用链,而 Deep Profile 为大量托管方法插入计时探针。 前者用于回答事件从哪里触发,后者用于观察脚本时间花在哪些方法中。二者不能互相替代。
Unity 6.3 的 Call Stacks 可选择记录 GC.Alloc、UnsafeUtility.Malloc 的特定分配及 JobHandle.Complete 等样本的调用栈。它不会因为打开开关,就把所有普通 CPU 样本转换成完整的 C# 方法调用树。
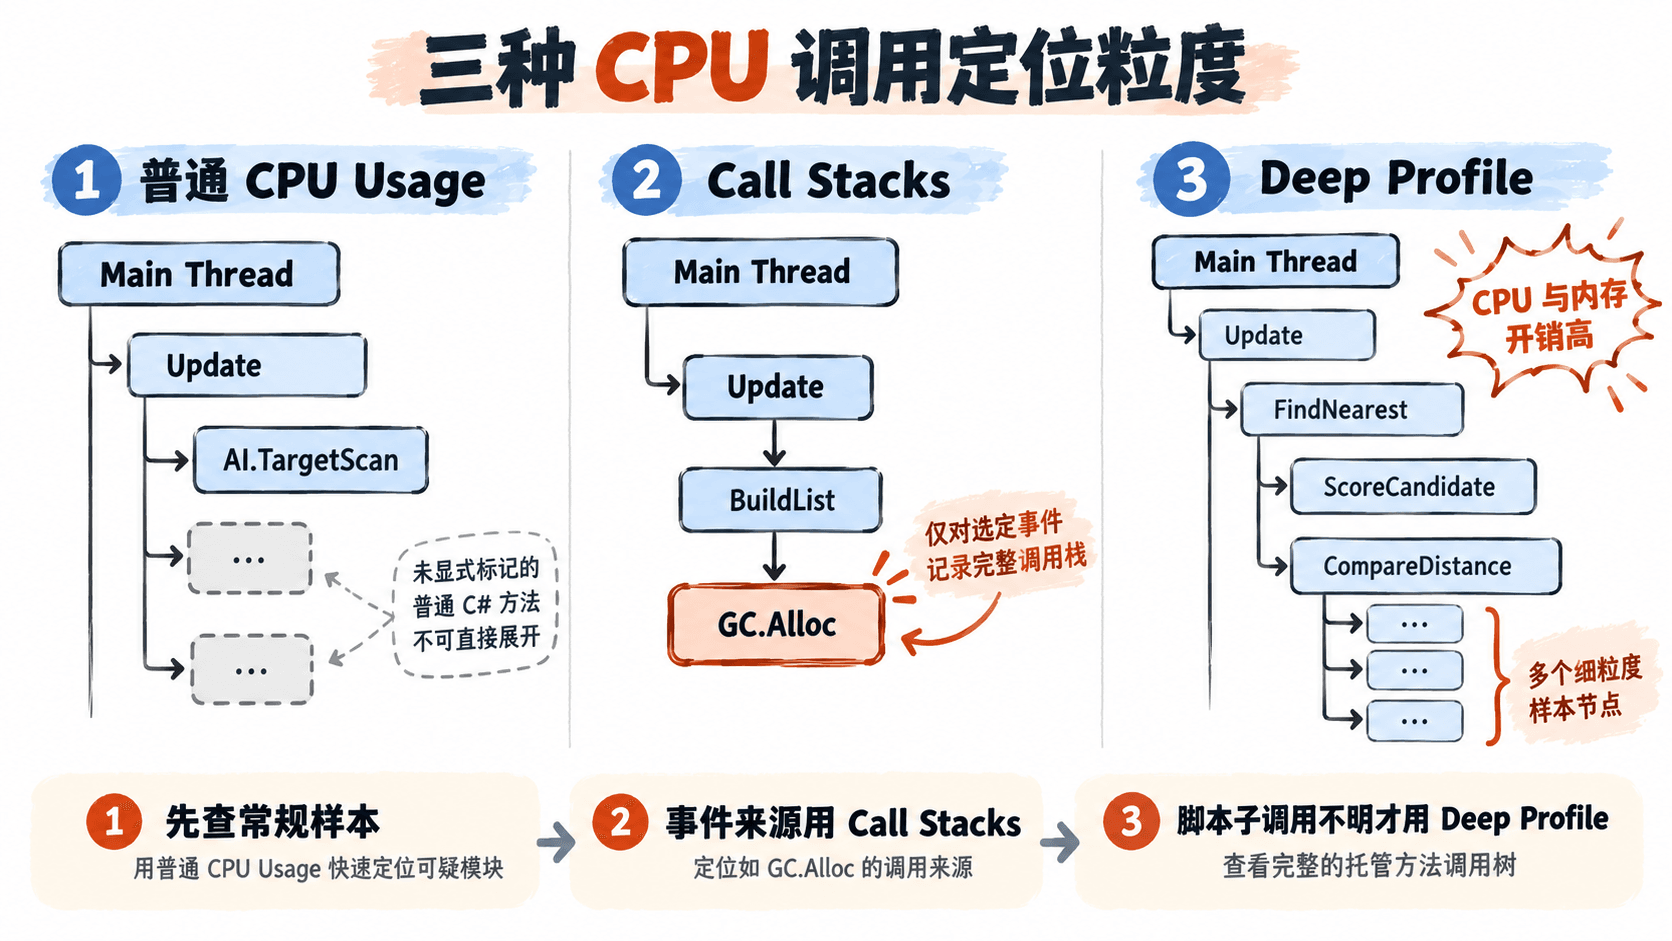
先用 Call Stacks 和局部标记缩小范围
建议先在独立 Development Build 上采集 CPU Usage 数据,并保持 Deep Profile 关闭。以下操作路径适用于 Unity 6.3 LTS,其他 Unity 6 小版本的工具栏布局可能略有差异。
- 打开
Window > Analysis > Profiler,从 Target Selection 选择正在运行的 Player。 - 选择
CPU Usage,在Timeline中找到异常帧,查看 Main Thread 内最长的脚本样本。 - 如果异常伴随
GC.Alloc,在 Profiler 顶部展开Call Stacks,启用GC.Alloc的调用栈记录。 - 重新执行同一段操作并采集新帧。选中相关分配样本,检查调用栈,确认分配来自哪个脚本方法。
- 如果耗时主要来自脚本计算而非受支持的事件,则先添加自定义 Marker,而不是直接启用 Deep Profile。
下面用一个可运行的 Unity C# 组件演示局部插桩。目标搜索是游戏 AI 中常见的热点:每帧遍历候选目标,计算距离并选择最近对象。我们只记录整个搜索区间的耗时。
创建 Assets/Scripts/TargetSearchProbe.cs,写入:
using Unity.Profiling;
using UnityEngine;

public sealed class TargetSearchProbe : MonoBehaviour
{
    private static readonly ProfilerMarker SearchMarker =
        new ProfilerMarker("AI.TargetScan");

    [SerializeField] private Transform[] targets = new Transform[0];
    [SerializeField, Min(0.1f)] private float searchRadius = 20f;

    public Transform Nearest { get; private set; }

    private void Update()
    {
        // 只对可疑的目标搜索区间插桩。
        using (SearchMarker.Auto())
        {
            Nearest = FindNearest();
        }
    }

    private Transform FindNearest()
    {
        Transform result = null;
        Vector3 origin = transform.position;
        float bestSqr = searchRadius * searchRadius;

        foreach (Transform candidate in targets)
        {
            if (candidate == null) continue;

            // 使用平方距离,避免每次比较都执行开方。
            float sqr = (candidate.position - origin).sqrMagnitude;
            if (sqr < bestSqr)
            {
                bestSqr = sqr;
                result = candidate;
            }
        }

        return result;
    }
}
预期结果:将脚本挂到坐标为 (0, 0, 0) 的 GameObject,创建两个目标对象,分别放在 (3, 0, 0) 和 (8, 0, 0),并把它们的 Transform 填入 Inspector 中的 Targets 数组。保持 Search Radius = 20,进入 Play Mode 后,Nearest 应指向距离为 3 米的目标。
在 Profiler 的 CPU Usage > Hierarchy 中,可以找到名为 AI.TargetScan 的样本,并观察其 Total、Self 和 Calls 等数据。普通采样不一定单独列出 FindNearest(),但自定义标记可以让搜索区间的耗时独立显示。
如果目标数量从 2 个增加到 500 个,搜索区间的工作量也会增加。测试时应重复采集多帧,不能依据单次微小耗时判断瓶颈。这里的 Marker 用于定位,具体毫秒值由硬件、目标数量与运行环境决定。
只在调用细节不足时开启 Deep Profile
当普通采样已经确认 AI.TargetScan 耗时异常,但无法解释其中究竟哪个未标记的 C# 子方法最慢时,才适合短时间启用 Deep Profile。
在 Editor 中启用
- 停止 Play Mode,打开
Window > Analysis > Profiler。 - 在 Profiler 工具栏启用
Deep Profile。 - 等待 Unity 完成必要的脚本重新加载和插桩。
- 进入 Play Mode,执行一次能稳定复现搜索热点的操作。
- 选择异常帧,在
CPU Usage > Hierarchy中展开调用层级,观察FindNearest()及其内部托管方法样本。 - 记录可疑方法及其调用次数,然后停止采集并关闭
Deep Profile。
Deep Profile 能看到更多托管方法调用,却不意味着可以看到所有原生引擎内部函数的逐层实现。大量小方法还可能因为插桩而显得异常昂贵。
在独立 Player 中启用
如果 Editor 与 Player 表现不同,应优先检查目标设备,但必须构建支持 Deep Profiling 的开发版本。
- 打开
File > Build Profiles,选择目标平台对应的 Build Profile。 - 启用
Development Build,再启用Deep Profiling。 - 重新构建并启动 Player,通过 Profiler 的 Target Selection 连接该进程。
- 只执行必要的复现场景,采集少量代表性帧并保存分析数据。
- 分析结束后关闭 Deep Profiling 构建选项,重新构建普通性能测试版本。
如果深度采样后 Editor 严重卡顿,可先退出 Play Mode,再关闭 Deep Profile。若已经无法稳定查看采样数据,应缩小测试场景,减少运行中的脚本对象数量,并优先用局部 ProfilerMarker 缩小问题区域。
用无深度插桩的采样确认真实收益
Deep Profile 的正确产出是可疑调用路径,而不是一个可直接用作性能基线的毫秒数。例如,发现 Update() 每帧调用 FindNearest(),而 FindNearest() 又频繁执行候选搜索,这说明应检查搜索频率、候选数量与缓存策略。
假设固定测试场景包含 100 个 NPC,测试前预热 15 秒,每次记录 300 帧,并统计 Main Thread 耗时的 P95,得到以下示例数据:
| 测试状态 | Deep Profile | Main Thread P95 | 结论 |
|---|---|---|---|
| 修改前普通采样 | 关闭 | 21.0 ms | 超过 60 FPS 的 16.67 ms 帧预算 |
| 修改前深度采样 | 开启 | 58.0 ms | 仅用于查找调用路径 |
| 修改后普通采样 | 关闭 | 15.2 ms | 同条件下主线程耗时下降 |
这些数字是说明分析方法的假设数据,不代表 Unity 或示例脚本的固定性能表现。
在该算例中,可信的主线程耗时改善是 21.0 - 15.2 = 5.8 ms,约为 27.6%。不能用深度采样的 58.0 ms 与修改后的 15.2 ms 相减,声称获得了 42.8 ms 的优化收益,因为其中混入了不同的插桩开销。
完成修复后,使用以下条件再次核对:
- 测试同一台目标设备、相同画质与分辨率,保持场景、NPC 数量和操作路线一致。
- 关闭 Deep Profile,使用同一种 Player 构建配置重新采样;必要时分别保存修改前后的数据。
- 重复采样至少 3 次,比较相同统计口径下的 Main Thread 耗时、
GC.Alloc和调用次数。 - 若 CPU 已降低但仍掉帧,继续检查 GPU、VSync、Present 或线程等待,不要把全部长帧都归因于 C# 计算。
排查顺序应当是:普通 CPU Usage 确认热点;遇到分配或同步事件时使用 Call Stacks;已知代码区域时增加局部 Marker;只有需要拆开未插桩的托管方法调用时才开启 Deep Profile。完成定位后关闭深度采样,用普通 Player 数据决定优化是否真正有效。
具体功能和界面名称可对照 Unity 6.3 Deep Profiling 官方文档 与 Profiler 窗口参考。