
大模型应用开发 / 系统课时
设计知识版本与增量更新
设计知识版本与增量更新
这一节解决知识库持续更新时最实际的问题:如何判断哪些片段真的变了,只为新增或修改内容重新生成向量,同时保留版本关系,让发布失败或答案异常时可以快速回退。核心是把“片段身份”和“片段内容”拆成两个独立标识。
学习目标
- 能用稳定片段标识区分逻辑身份,并用内容指纹判断内容是否变化。
- 能计算新增、修改、未变与删除片段,只对受影响内容执行向量更新。
- 能用版本清单和原子切换记录发布关系,支持审计与快速回退。
稳定标识和内容指纹回答不同问题
chunk_id 回答“这是不是同一个逻辑片段”,内容指纹回答“这个片段的内容有没有变化”。两者不能混成一个值。稳定标识应来自不会因普通编辑而变化的信息,例如 doc_id + section_key;内容指纹则对规范化后的正文计算 SHA-256,只要正文变化,指纹就变化。
不要直接用切片后的数组下标生成稳定 ID。假设前面新增一个段落,后续所有序号都会移动,系统会误判整篇文档都发生变化,导致无意义的重新 Embedding。更稳妥的做法是为标题路径、业务条款或源系统记录保留稳定键,再在稳定键内部比较内容指纹。
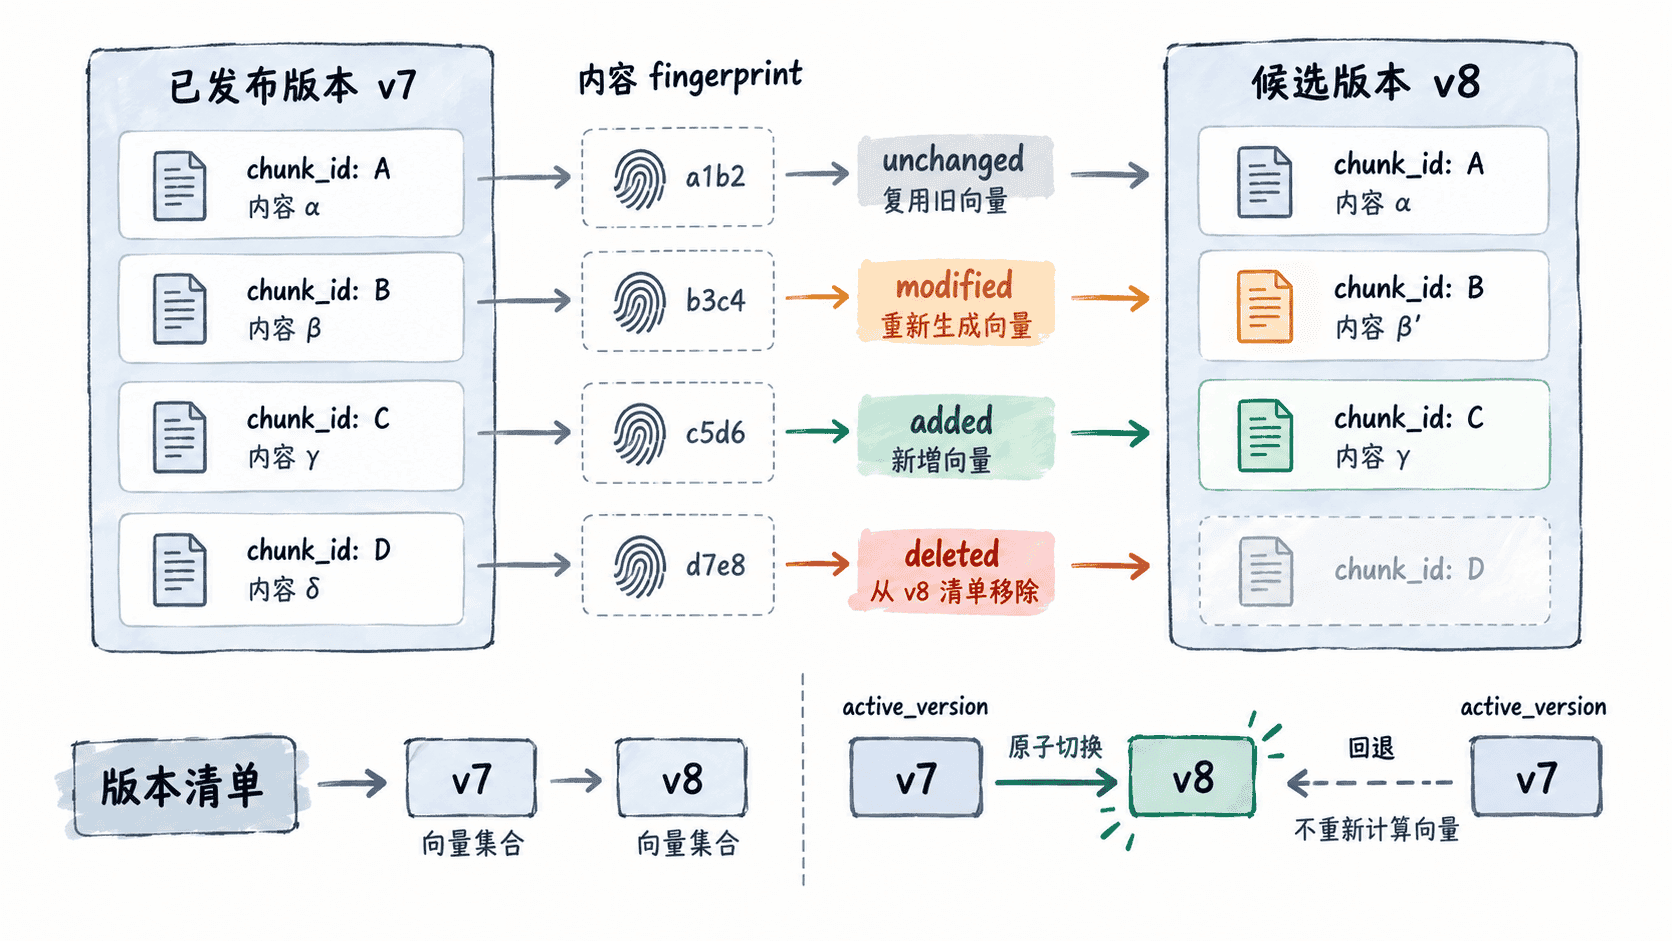
计算一次增量更新计划
下面的程序只依赖 Python 标准库。它先用 doc_id + logical_key 生成稳定 chunk_id,再对规范化正文计算指纹,最后把新旧版本分成新增、修改、未变和删除四类。真正接入向量库时,只需要把 added + modified 送去重新 Embedding,并处理 deleted,unchanged 可以直接复用已有向量。
import hashlib
import json
import re

def normalize(text: str) -> str:
    # 忽略连续空白差异,避免纯排版变化触发重建。
    return re.sub(r"\s+", " ", text).strip()

def sha256(text: str) -> str:
    return hashlib.sha256(text.encode("utf-8")).hexdigest()

def build_record(doc_id: str, logical_key: str, text: str) -> dict:
    stable_source = f"{doc_id}|{logical_key}"
    return {
        "logical_key": logical_key,
        "chunk_id": sha256(stable_source)[:16],
        "fingerprint": sha256(normalize(text)),
        "text": text,
    }

def index_by_id(records: list[dict]) -> dict[str, dict]:
    return {record["chunk_id"]: record for record in records}

old_chunks = [
    build_record("refund-policy", "refund#deadline", "收货后 7 天内可以申请退款"),
    build_record("refund-policy", "refund#channel", "在订单页提交退款申请"),
    build_record("refund-policy", "refund#contact", "异常情况联系人工客服"),
]
new_chunks = [
    build_record("refund-policy", "refund#deadline", "收货后 15 天内可以申请退款"),
    build_record("refund-policy", "refund#channel", "在订单页提交退款申请"),
    build_record("refund-policy", "refund#evidence", "高价值商品需要上传凭证"),
]

old_by_id = index_by_id(old_chunks)
new_by_id = index_by_id(new_chunks)
old_ids = set(old_by_id)
new_ids = set(new_by_id)

added = new_ids - old_ids
deleted = old_ids - new_ids
shared = old_ids & new_ids
modified = {
    chunk_id
    for chunk_id in shared
    if old_by_id[chunk_id]["fingerprint"] != new_by_id[chunk_id]["fingerprint"]
}
unchanged = shared - modified

def keys(ids: set[str], source: dict[str, dict]) -> list[str]:
    return sorted(source[chunk_id]["logical_key"] for chunk_id in ids)

plan = {
    "version_id": "v8",
    "parent_version": "v7",
    "reembed": keys(added | modified, new_by_id),
    "reuse": keys(unchanged, new_by_id),
    "remove_from_manifest": keys(deleted, old_by_id),
}
print(json.dumps(plan, ensure_ascii=False, indent=2))
预期输出
{
  "version_id": "v8",
  "parent_version": "v7",
  "reembed": [
    "refund#deadline",
    "refund#evidence"
  ],
  "reuse": [
    "refund#channel"
  ],
  "remove_from_manifest": [
    "refund#contact"
  ]
}
这个结果说明只有“退款期限”和新增的“凭证要求”需要重新生成向量;“申请渠道”内容没变,可以复用;旧版中的“人工客服”片段不再属于 v8。删除动作最好先从新版本清单中移除,而不是立刻物理删除旧向量,因为旧版本仍可能在回退时需要它。
用版本清单完成发布而不是覆盖旧数据
可回退的发布不应直接把“当前向量”原地覆盖掉。更稳妥的结构是维护版本清单:清单记录 version_id、parent_version、发布时间、包含哪些片段或向量记录,以及本次新增、修改和删除的差异。未变化的向量可以跨版本复用,避免重复存储与重复计算。
一次发布可以按以下顺序完成:先为新增和修改片段生成候选向量;再写入 v8 的版本清单;随后执行数量、权限和探针查询验证;全部通过后,原子地把 active_version 从 v7 切换为 v8。只有超过保留期且确认不再需要回退后,才清理失效向量。
指纹规则必须稳定且可解释
内容指纹之前要先定义规范化规则,但不要过度规范化。统一换行、去掉首尾空白、合并连续空格通常是安全的;如果业务中大小写、标点或数字具有含义,就不要随意抹掉,否则“内容变了”却得到同一个规范化文本,会造成漏更新。
同时不要把抓取时间、导入时间或随机 ID 拼进内容指纹。那些值每次同步都会变化,会让所有片段看起来都被修改。真正需要参与指纹的应该是会影响回答语义或权限判断的内容,例如正文、结构化字段和必要的权限属性。
回退要恢复完整检索视图
快速回退不只是把文档版本号改回去,还要恢复那个版本对应的片段集合、权限信息和向量空间。若 v8 使用了新的 Embedding 模型,更不能把 v7 和 v8 混在同一个可查询集合里。版本清单应记录所使用的索引或模型契约,使 active_version 切换后,查询侧能得到完全一致的旧检索视图。
稳定标识负责对齐逻辑片段,内容指纹负责识别变化,版本清单负责描述一次发布。当这三层职责分开后,日常更新只需处理真正变化的内容,而审计、回退和模型升级也都有清晰边界。