
大模型应用开发 / 系统课时
在答案中返回可追溯引用
在答案中返回可追溯引用
本节把“模型说得像有依据”变成“每个关键结论都能回到实际证据”。你将为进入上下文的片段分配稳定引用标识,约束模型输出引用,并在服务端拒绝不存在或未参与生成的引用。
学习目标
- 为上下文片段生成稳定且可回查的引用标识。
- 约束模型在关键结论后只输出允许的证据引用。
- 在服务端校验引用集合,并返回前端可展示的引用元数据。
引用标识必须绑定实际证据
引用 ID 不应使用“本次第 1 条、第 2 条”这类临时编号,因为相同文档在不同请求里的排序可能变化。更稳妥的是由稳定文档 ID 和稳定 chunk ID 组成,例如 policy-2026#17。只要切块版本没有变化,同一片段就能持续映射到同一引用。
进入生成上下文时,每个片段同时携带引用 ID、正文和可回查元数据;没有真正进入上下文的检索候选,即使分数很高,也不能出现在本次答案的允许引用集合中。
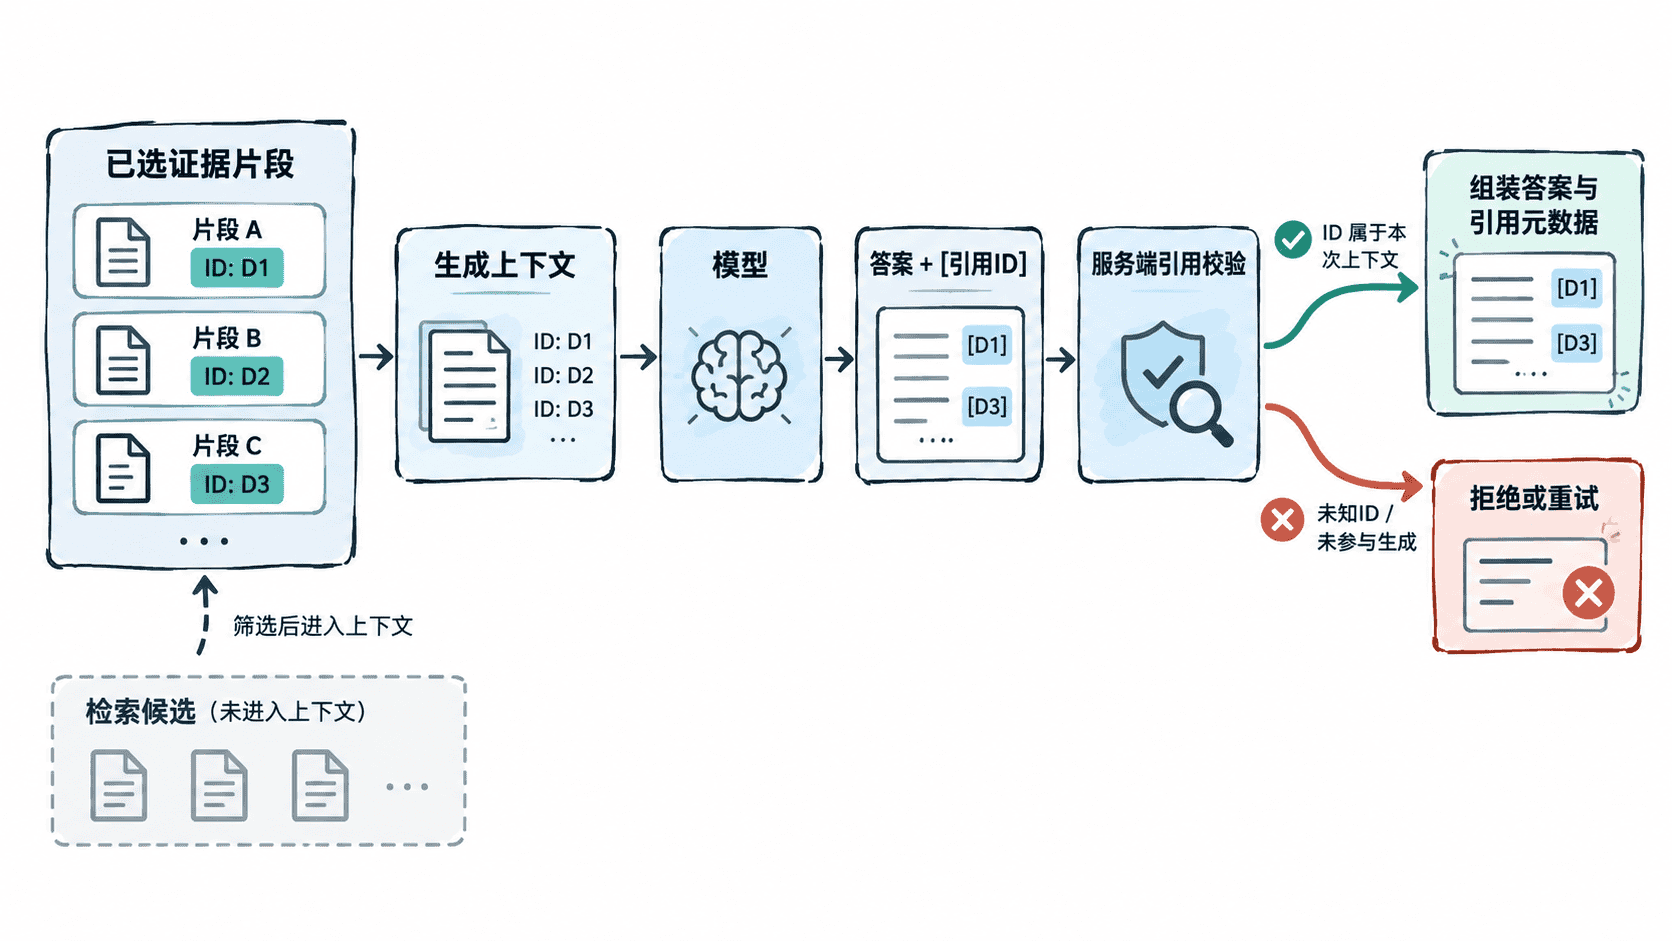
把引用要求写进生成协议
提示词要同时告诉模型“允许引用什么”和“何时必须引用”。一个实用约束是:事实性结论、政策条件、数字和时效要求后必须紧跟至少一个引用;如果证据不足,就明确回答无法从当前资料确认,而不是猜测引用 ID。
上下文可以采用这种格式:[policy-2026#17] 标准版退款申请需在支付后 7 日内提交。。模型只看到本次已选证据对应的 ID,服务端再把这些 ID 作为白名单传给校验器。
服务端校验并返回结构化引用
下面的完整示例模拟两条已进入上下文的证据。validate_answer 会提取答案里的引用,拒绝未知 ID,并要求每个事实句至少携带一个引用;通过后再返回前端可使用的来源标题与地址。
import json

def stable_ref(document_id: str, chunk_id: int) -> str:
    return f"{document_id}#{chunk_id}"

def extract_refs(answer: str) -> list[str]:
    refs = []
    pos = 0
    while True:
        left = answer.find("[", pos)
        if left == -1:
            break
        right = answer.find("]", left + 1)
        if right == -1:
            break
        refs.append(answer[left + 1:right])
        pos = right + 1
    return refs

def validate_answer(answer: str, evidence: dict[str, dict]) -> dict:
    refs = extract_refs(answer)
    unknown = sorted(set(refs) - set(evidence))
    if unknown:
        raise ValueError("unknown citations: " + ",".join(unknown))

    # 示例按中文句号切分;生产环境应使用更稳健的句子级 claim 检测。
    sentences = [s.strip() for s in answer.split("。") if s.strip()]
    if any("[" not in s or "]" not in s for s in sentences):
        raise ValueError("a factual sentence has no citation")

    unique_refs = list(dict.fromkeys(refs))
    citations = [
        {"id": ref, "title": evidence[ref]["title"], "url": evidence[ref]["url"]}
        for ref in unique_refs
    ]
    return {"answer": answer, "citations": citations}

evidence = {
    stable_ref("policy-2026", 17): {
        "title": "退款政策",
        "url": "/docs/policy-2026#17",
    },
    stable_ref("sla-handbook", 4): {
        "title": "客服 SLA 手册",
        "url": "/docs/sla-handbook#4",
    },
}

answer = (
    "标准版退款申请需在支付后 7 日内提交 [policy-2026#17]。"
    "工作日工单首次响应目标为 4 小时内 [sla-handbook#4]。"
)

result = validate_answer(answer, evidence)
print(json.dumps(result, ensure_ascii=False, separators=(",", ":")))
预期输出
{"answer":"标准版退款申请需在支付后 7 日内提交 [policy-2026#17]。工作日工单首次响应目标为 4 小时内 [sla-handbook#4]。","citations":[{"id":"policy-2026#17","title":"退款政策","url":"/docs/policy-2026#17"},{"id":"sla-handbook#4","title":"客服 SLA 手册","url":"/docs/sla-handbook#4"}]}这里的 evidence 就是本次真正送入模型的证据白名单。若模型生成 [other-doc#9],即使该片段存在于整个知识库中,也会因未参与本次生成而被拒绝。
处理无引用与伪引用
引用校验至少要区分三类失败:引用 ID 不存在、引用存在但未进入本次上下文、事实句没有引用。前两类应直接拒绝结果或触发一次受约束重试;第三类可以根据业务风险决定重试、降级为“无法确认”,或把该句从答案中移除。
服务端还应保存“回答文本、实际上下文证据 ID、最终引用 ID、知识版本”这组审计信息。这样用户点击引用时能回到原文,客服质检也能重放当时的证据集合,而不是只看到模型最终写出的自然语言。可追溯性的关键不是让模型学会加括号,而是让稳定证据标识、生成约束和服务端白名单校验形成闭环。