
大模型应用开发 / 系统课时
盘点企业文档与权限元数据
盘点企业文档与权限元数据
知识库真正难维护的部分通常不是“能不能切片”,而是能否知道每条知识来自哪里、属于谁、谁可以看以及何时需要更新。本节先把企业资料登记成可过滤、可审计的资产记录,再为后续切片和检索建立稳定元数据边界。
学习目标
- 为 FAQ、PDF、网页、表格和内部文档定义统一的最小元数据
- 用租户、部门、版本与访问级别支撑检索前权限过滤
- 通过校验脚本发现缺失字段、重复文档标识和非法权限值
先把“文件”变成资产记录
原始文件只回答“内容在哪里”,却回答不了“这条内容是否还能用、谁有权看到、更新后如何定位旧版本”。因此,入库前要先为每个逻辑文档建立一条资产记录,再让后续生成的 chunk 继承这条记录中的身份、来源和权限字段。
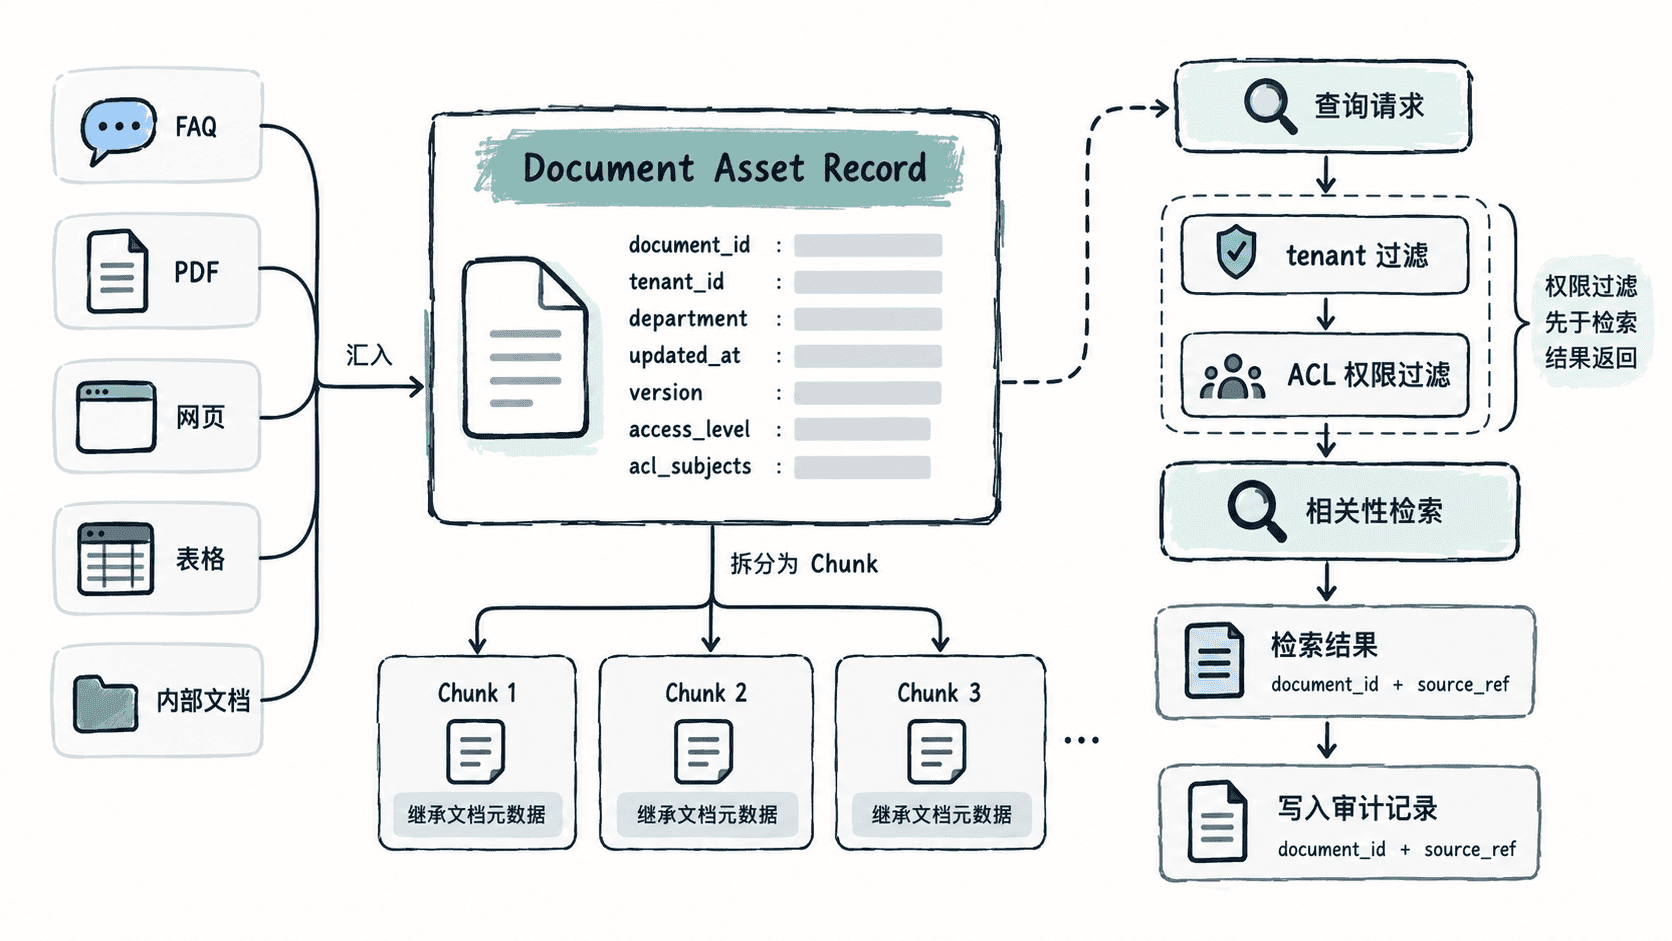
这层登记最好以“逻辑文档”为单位,而不是以物理文件名为单位。例如员工手册从 PDF v3 升级到 v4 时,document_id 可以保持稳定,而 version、updated_at 和内容校验值发生变化。这样更新任务才能准确判断是新增、替换还是下线。
设计能过滤也能审计的字段
最小字段不要追求“越多越好”,而要覆盖身份、来源、归属、时间、版本和权限六类问题。
| 字段 | 示例 | 主要用途 |
|---|---|---|
document_id |
doc-employee-handbook |
稳定识别同一逻辑文档 |
source_type |
pdf |
区分 FAQ、PDF、网页、表格、内部文档 |
source_ref |
file:employee-handbook-v3.pdf |
回到原始资料或采集位置 |
tenant_id |
tenant-acme |
多租户隔离 |
department |
hr |
部门过滤与责任归属 |
updated_at |
2026-09-01T08:00:00Z |
判断资料新鲜度 |
version |
v3 |
追踪内容迭代 |
access_level |
internal |
表达公开范围 |
acl_subjects |
group:all-employees |
精确到允许访问的组或主体 |
checksum |
sha256:demo-001 |
判断内容是否实际变化 |
access_level 适合表达粗粒度策略,acl_subjects 则承载具体授权主体。两者不要互相替代:仅有“restricted”无法知道谁可以访问,仅有 ACL 又难以快速执行统一策略和审计分类。
用校验脚本检查盘点结果
下面把五类企业资料各登记一条记录,并验证必填字段、时间格式、访问级别和 document_id 唯一性。实际项目可以把这些记录保存为 JSONL、数据库表或内容平台中的文档清单,但字段语义应保持一致。
from datetime import datetime

REQUIRED = {
    "document_id",
    "source_type",
    "source_ref",
    "tenant_id",
    "department",
    "updated_at",
    "version",
    "access_level",
    "acl_subjects",
    "checksum",
}
ALLOWED_LEVELS = {"public", "internal", "restricted", "confidential"}

records = [
    {
        "document_id": "doc-account-faq",
        "source_type": "faq",
        "source_ref": "faq:account",
        "tenant_id": "tenant-acme",
        "department": "it",
        "updated_at": "2026-09-10T09:00:00Z",
        "version": "v8",
        "access_level": "internal",
        "acl_subjects": ["group:all-employees"],
        "checksum": "sha256:demo-001",
    },
    {
        "document_id": "doc-employee-handbook",
        "source_type": "pdf",
        "source_ref": "file:employee-handbook-v3.pdf",
        "tenant_id": "tenant-acme",
        "department": "hr",
        "updated_at": "2026-09-01T08:00:00Z",
        "version": "v3",
        "access_level": "internal",
        "acl_subjects": ["group:all-employees"],
        "checksum": "sha256:demo-002",
    },
    {
        "document_id": "doc-expense-help",
        "source_type": "web",
        "source_ref": "web:help-center/expense",
        "tenant_id": "tenant-acme",
        "department": "finance",
        "updated_at": "2026-09-08T02:30:00Z",
        "version": "v12",
        "access_level": "internal",
        "acl_subjects": ["group:all-employees"],
        "checksum": "sha256:demo-003",
    },
    {
        "document_id": "doc-travel-policy",
        "source_type": "spreadsheet",
        "source_ref": "sheet:finance-travel",
        "tenant_id": "tenant-acme",
        "department": "finance",
        "updated_at": "2026-09-09T04:00:00Z",
        "version": "v5",
        "access_level": "restricted",
        "acl_subjects": ["group:finance"],
        "checksum": "sha256:demo-004",
    },
    {
        "document_id": "doc-security-runbook",
        "source_type": "internal",
        "source_ref": "doc:security-runbook",
        "tenant_id": "tenant-acme",
        "department": "security",
        "updated_at": "2026-09-11T01:00:00Z",
        "version": "v2",
        "access_level": "confidential",
        "acl_subjects": ["group:security"],
        "checksum": "sha256:demo-005",
    },
]

def validate(record: dict) -> None:
    # 先验证字段完整性,再验证权限与时间语义,避免脏数据进入切片阶段。
    missing = REQUIRED - record.keys()
    if missing:
        raise ValueError(f"{record.get('document_id', '<unknown>')} missing={sorted(missing)}")
    if record["access_level"] not in ALLOWED_LEVELS:
        raise ValueError(f"invalid access_level={record['access_level']}")
    if not isinstance(record["acl_subjects"], list) or not record["acl_subjects"]:
        raise ValueError("acl_subjects must be a non-empty list")
    datetime.fromisoformat(record["updated_at"].replace("Z", "+00:00"))

for item in records:
    validate(item)

ids = [item["document_id"] for item in records]
tenants = {item["tenant_id"] for item in records}
if len(ids) != len(set(ids)):
    raise ValueError("document_id must be unique")

print(
    f"validated={len(records)} "
    f"tenants={len(tenants)} "
    f"document_ids_unique={str(len(ids) == len(set(ids))).lower()}"
)
预期输出:
validated=5 tenants=1 document_ids_unique=true如果把某条记录的 access_level 改成未定义值,或者删除 tenant_id,脚本应直接失败。盘点阶段宁可阻止不完整资料入库,也不要把“不知道谁能看”的文档交给检索系统猜测。
权限和版本要先于切片
切片会把一个文档复制成许多可检索单元,因此权限字段必须在切片前就确定,并随每个 chunk 一起存储。查询时先根据当前用户解析出 tenant_id、部门或授权组,再用这些条件过滤候选数据,之后才计算相关性或进行重排。
版本字段解决的不是展示问题,而是更新问题。稳定的 document_id 用来认出“还是这份文档”,version 和 updated_at 描述当前状态,checksum 则判断内容是否真的变化。三者组合起来,采集任务才能避免重复切片,也能在审计时解释某次回答使用的是哪个版本。
盘点完成的验收标准
一份可进入后续知识加工的清单,至少应满足这些条件:
- 每个逻辑文档都有稳定且唯一的
document_id,并能通过source_ref回到原资料 - 每条记录都明确
tenant_id、department、access_level和acl_subjects,不存在权限空白 updated_at、version与checksum足以判断新旧版本和内容变化- 任意抽查一条未来的 chunk,都能反查所属文档、来源、权限和版本
做到这一步后,切片、向量化和召回才有可靠的过滤与审计基础;否则检索质量即使很高,也可能因为权限错配或版本失控而无法上线。