
大模型应用开发 / 系统课时
生成向量并写入检索索引
生成向量并写入检索索引
这一节把已经切好的知识片段变成可检索索引:批量生成向量,把正文、来源、版本和权限一起写入,并在写入后用同一套维度与距离规则做一次查询验证。重点不是绑定某个向量数据库,而是先固定摄取侧与查询侧必须共同遵守的索引契约。
学习目标
- 能定义 Embedding 模型、向量维度、距离度量和归一化方式组成的索引契约。
- 能批量写入文本、向量、来源、版本与权限元数据,并拒绝维度错误或非法向量。
- 能用同一查询契约完成检索验证,发现模型、维度或度量配置不一致的问题。
先固定摄取与查询的共同契约
向量索引最容易出现的错误,不是“没有向量”,而是摄取侧和查询侧使用了不同规则。至少要固定 embedding_model、dimension、metric 和是否归一化。模型升级不能只改调用代码;一旦新模型维度或向量空间改变,就应写入新索引或新版本,不能把两种向量混在同一索引中。
如果使用余弦相似度,常见做法是先把向量归一化到单位长度;这样点积与余弦相似度等价。无论数据库选择 cosine、dot product 还是 L2,查询侧必须使用与建库时相同的度量语义。
每条索引记录还应保留检索后回答所需的元数据。最小集合通常包括稳定的 chunk_id、doc_id、source、version、acl 和原始 text。权限元数据必须与向量一起进入索引,否则只能在召回后过滤,既浪费召回名额,也可能扩大越权数据暴露面。
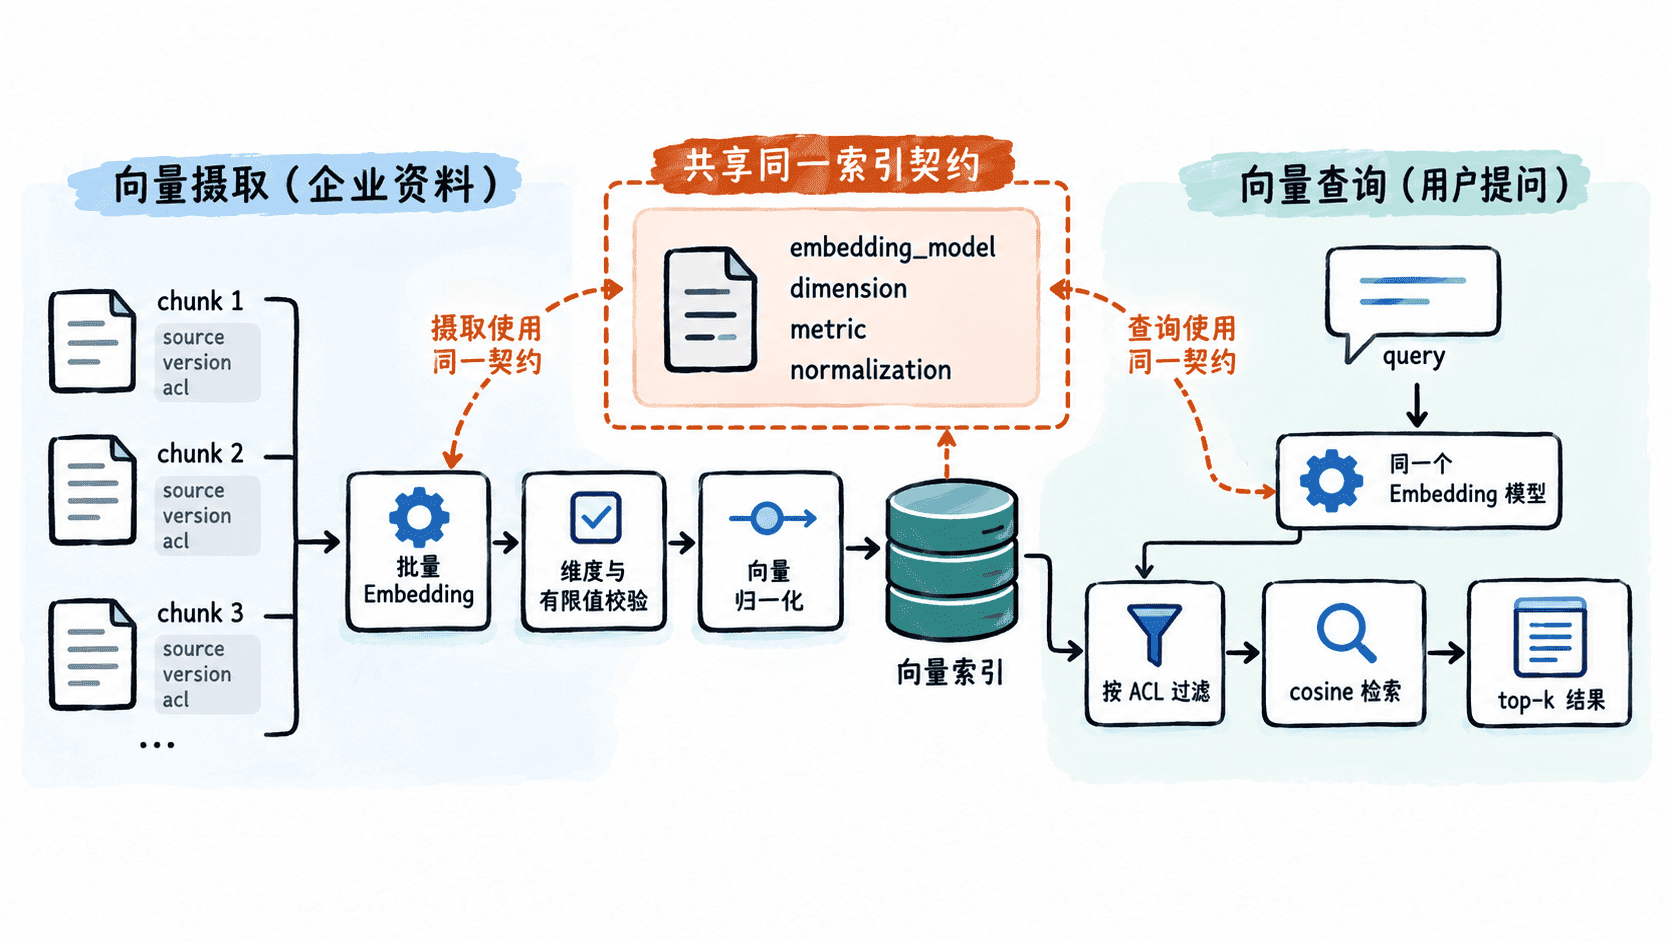
批量生成并写入一个可验证的索引
下面用纯 Python 做一个离线可运行的最小索引。为了不依赖外部模型下载,示例使用确定性的哈希向量函数模拟 Embedding,并用 JSONL 持久化记录、暴力余弦计算完成检索。生产环境替换为真实 Embedding 服务和 Qdrant、pgvector、Milvus 等向量存储时,字段与校验思路保持不变。
import hashlib
import json
import math
import re
from pathlib import Path

DIM = 12
INDEX_FILE = Path("vector_store.jsonl")
INDEX_CONFIG = {
    "embedding_model": "demo-hash-v1",
    "dimension": DIM,
    "metric": "cosine",
    "normalized": True,
}

def embed(text: str) -> list[float]:
    """离线演示用确定性向量;生产环境替换为真实 Embedding API。"""
    vector = [0.0] * DIM
    tokens = re.findall(r"[\w]+", text.lower(), flags=re.UNICODE)
    for token in tokens:
        digest = hashlib.sha256(token.encode("utf-8")).digest()
        for i in range(DIM):
            vector[i] += 1.0 if digest[i] & 1 else -1.0
    norm = math.sqrt(sum(value * value for value in vector))
    return [value / norm for value in vector] if norm else vector

def validate(vector: list[float]) -> None:
    if len(vector) != INDEX_CONFIG["dimension"]:
        raise ValueError("vector dimension mismatch")
    if not all(math.isfinite(value) for value in vector):
        raise ValueError("vector contains NaN or Infinity")

def cosine(a: list[float], b: list[float]) -> float:
    return sum(x * y for x, y in zip(a, b))

records = [
    {
        "chunk_id": "refund-v3-0001",
        "doc_id": "refund-policy",
        "version": 3,
        "source": "kb/refund.md",
        "acl": ["support"],
        "text": "退款 条件 发货 后 七天 内 可申请",
    },
    {
        "chunk_id": "invoice-v2-0001",
        "doc_id": "invoice-guide",
        "version": 2,
        "source": "kb/invoice.md",
        "acl": ["support", "finance"],
        "text": "发票 申请 需要 订单号 和 抬头",
    },
]

for record in records:
    record["vector"] = embed(record["text"])
    validate(record["vector"])

with INDEX_FILE.open("w", encoding="utf-8") as file:
    for record in records:
        file.write(json.dumps(record, ensure_ascii=False) + "\n")

query_vector = embed("退款 条件")
validate(query_vector)
hits = sorted(
    (
        (cosine(query_vector, record["vector"]), record)
        for record in records
        if "support" in record["acl"]
    ),
    key=lambda item: item[0],
    reverse=True,
)

print(f"dimension={DIM}, metric=cosine, records={len(records)}")
for score, record in hits:
    print(record["chunk_id"], f"{score:.4f}", record["source"], record["version"])
预期输出
dimension=12, metric=cosine, records=2
refund-v3-0001 0.4914 kb/refund.md 3
invoice-v2-0001 -0.2474 kb/invoice.md 2
这里的分数只用于验证数据链路,不能代表真实语义模型的质量。真正需要确认的是:每条记录维度都为 12、没有 NaN 或无穷值、权限字段随记录持久化,而且“退款 条件”确实通过同一向量函数和同一 cosine 规则进入查询。
写入前后分别做一致性检查
写入前先做结构校验,可以避免脏数据进入索引后才发现问题。除维度和有限值外,还应检查 chunk_id 是否唯一、正文是否为空、来源和版本是否存在,以及 ACL 是否符合约定的数据类型。批量任务最好统计成功、跳过和失败数量,并把失败片段送入重试队列,而不是悄悄丢弃。
写入后再做一次端到端探针查询。探针应使用与线上完全相同的查询 Embedding、归一化、距离度量和权限过滤逻辑,并断言一个已知问题能命中预期片段。仅仅检查“索引中有 N 条记录”无法发现查询侧换了模型、度量配置错了或权限过滤没有生效。
生产索引还要保存可追溯信息
向量只是召回信号,回答阶段仍需要知道内容来自哪里、属于哪个版本、当前用户是否有权访问。因此不要只保存 id + vector。至少让检索结果能回到原文片段和来源,并携带版本与权限信息;如果还需要删除、审计和增量更新,再额外保存内容指纹、文档稳定标识与发布时间。
当摄取侧和查询侧共享同一份索引契约,并且写入后有端到端探针验证时,向量索引才真正具备可上线性:问题出现时可以区分是 Embedding 生成失败、索引配置错误、权限过滤错误,还是召回质量本身不足。