
大模型应用开发 / 系统课时
缓存高频问答降低模型开销
缓存高频问答降低模型开销
高频问题不必每次都重新做 Embedding、检索和模型生成,但把所有结果塞进一个缓存会造成跨租户串数据、知识更新后返回旧答案,甚至绕过权限变化。本节拆分三层缓存,并用版本化缓存键实现可预测、可验证的精确失效。
学习目标
- 区分 Embedding 缓存、检索缓存和最终答案缓存的职责与风险
- 为缓存键纳入租户、权限、知识版本以及模型和检索配置
- 在知识更新、权限变化或模型配置变更后让旧缓存立即失去命中资格
把三层缓存放在不同位置
三种缓存节省的成本不同,因此键和值也不应混用。
| 缓存层 | 缓存内容 | 关键键维度 | 典型失效条件 |
|---|---|---|---|
| Embedding 缓存 | 查询或文档向量 | 租户、Embedding 模型版本、规范化文本或内容哈希 | Embedding 模型变化、文档内容变化 |
| 检索缓存 | 文档 ID、片段与分数 | 租户、权限指纹、知识版本、检索配置、规范化查询 | 知识更新、权限变化、检索参数变化 |
| 最终答案缓存 | 可直接返回的答案及引用 | 租户、权限指纹、知识版本、检索配置、模型配置、提示词版本、规范化查询 | 任一上游版本或权限变化 |
查询 Embedding 本身通常不依赖知识库版本,因此不必机械地把知识版本加入查询向量键;文档 Embedding 则应绑定内容哈希或文档版本。检索结果和最终答案与“当前能看到哪些知识”直接相关,必须绑定知识版本和权限指纹。
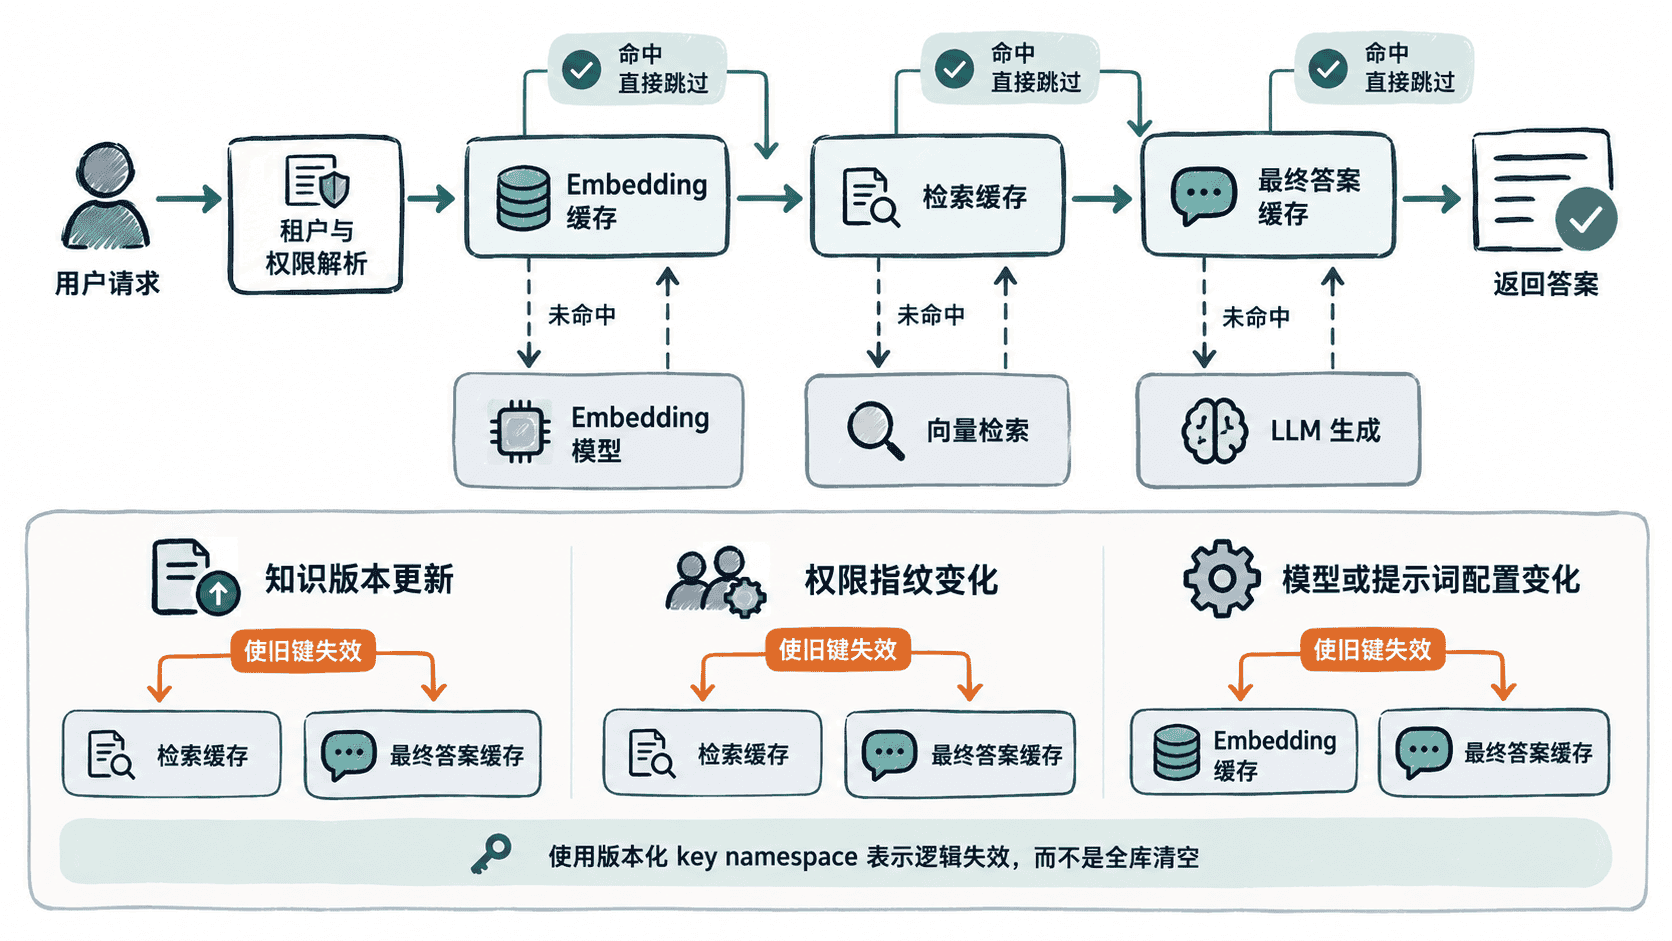
用版本维度构造缓存键
最简单可靠的做法不是维护大量“删除哪些 key”的规则,而是把会改变语义的版本直接纳入键。版本一变,新请求自然生成新 key,旧值立即无法命中;后台再按 TTL 或异步任务回收旧条目。
下面的示例演示最终答案缓存。相同问题只有在租户、知识版本、权限版本、检索配置、模型配置和提示词版本都一致时才会命中。
import hashlib
import json

def digest(value):
    raw = json.dumps(
        value,
        ensure_ascii=False,
        sort_keys=True,
        separators=(",", ":"),
    )
    return hashlib.sha256(raw.encode("utf-8")).hexdigest()[:16]

def answer_cache_key(
    tenant,
    knowledge_version,
    acl_version,
    retriever_config,
    model_config,
    prompt_version,
    query,
):
    normalized_query = " ".join(query.strip().lower().split())
    key_parts = {
        "tenant": tenant,
        "knowledge_version": knowledge_version,
        "acl_version": acl_version,
        "retriever": retriever_config,
        "model": model_config,
        "prompt_version": prompt_version,
        "query": normalized_query,
    }
    return "answer:" + digest(key_parts)

cache = {}
base = {
    "tenant": "tenant-a",
    "retriever_config": {"top_k": 5, "reranker": "v2"},
    "model_config": {"model": "support-model-v3", "temperature": 0},
    "prompt_version": "prompt-12",
    "query": "  How do I reset my password? ",
}

key_v42 = answer_cache_key(
    knowledge_version="kb-42",
    acl_version="acl-7",
    **base,
)
cache[key_v42] = "Use the password reset page."

same_key = answer_cache_key(
    knowledge_version="kb-42",
    acl_version="acl-7",
    **base,
)
new_kb_key = answer_cache_key(
    knowledge_version="kb-43",
    acl_version="acl-7",
    **base,
)
new_acl_key = answer_cache_key(
    knowledge_version="kb-42",
    acl_version="acl-8",
    **base,
)

print("same-version-hit:", same_key in cache)
print("knowledge-update-hit:", new_kb_key in cache)
print("permission-change-hit:", new_acl_key in cache)
预期输出:
same-version-hit: True
knowledge-update-hit: False
permission-change-hit: False
这个策略把“失效”从脆弱的删除操作改成键空间切换。旧条目即使还物理存在,也已经没有资格服务新请求。
分别设计每层的失效边界
Embedding 缓存适合复用确定性强的计算。查询向量可以按规范化文本和 Embedding 模型版本缓存;文档向量应按文档内容哈希缓存。只要模型版本或内容哈希不同,就必须生成新键,避免向量空间不一致。
检索缓存必须包含权限指纹。这个指纹可以来自用户角色、可访问知识集合或权限版本的稳定摘要,但不要把完整权限列表直接塞进 key。知识库发布新版本时,新请求进入新 namespace;权限变更时,新的权限指纹同样阻止旧检索结果复用。
最终答案缓存最严格,因为它把历史检索结果和模型生成一起复用。除知识与权限外,还应包含模型标识、温度等会改变输出的生成配置、提示词版本和检索配置。若引用文档必须展示给用户,缓存值还应保存引用标识,并在返回前再次执行轻量权限校验。
不要缓存所有回答
带实时数据、用户账户状态、订单进度、一次性工具结果或副作用操作的回答通常不适合做最终答案缓存。对于这类请求,可以只复用 Embedding 或检索结果,让最后一步仍按当前上下文生成。
上线验收时至少要验证四类场景:同租户同版本能命中;不同租户不能互相命中;知识发布后旧答案立即失去命中资格;权限收紧后原本可见的检索结果和最终答案都不能继续复用。这样缓存节省的才是重复计算,而不是把旧权限和旧知识一起固化下来。