
大模型应用开发 / 系统课时
监控延迟错误率与模型成本
监控延迟错误率与模型成本
这一节建立一套能真正定位客服异常的观测口径:把检索、重排、模型和工具调用拆开计时,同时记录错误、token、缓存命中与拒答,再按租户和发布版本聚合,让“变慢、变贵、答坏了”可以被分别发现。
学习目标
- 为一次客服请求定义可聚合的延迟、错误和成本字段
- 按租户与版本计算 token、缓存命中率和拒答率
- 避免高基数标签把指标系统本身拖垮
先定义请求级观测边界
一个回答通常跨过检索、重排、模型和工具调用四类阶段。只看总耗时无法判断瓶颈,所以每个阶段都要记录独立耗时,同时在请求级别保留最终状态、拒答与成本。日志和 Trace 负责保存单次请求细节,Metrics 负责聚合趋势,两者不要混成一种数据。
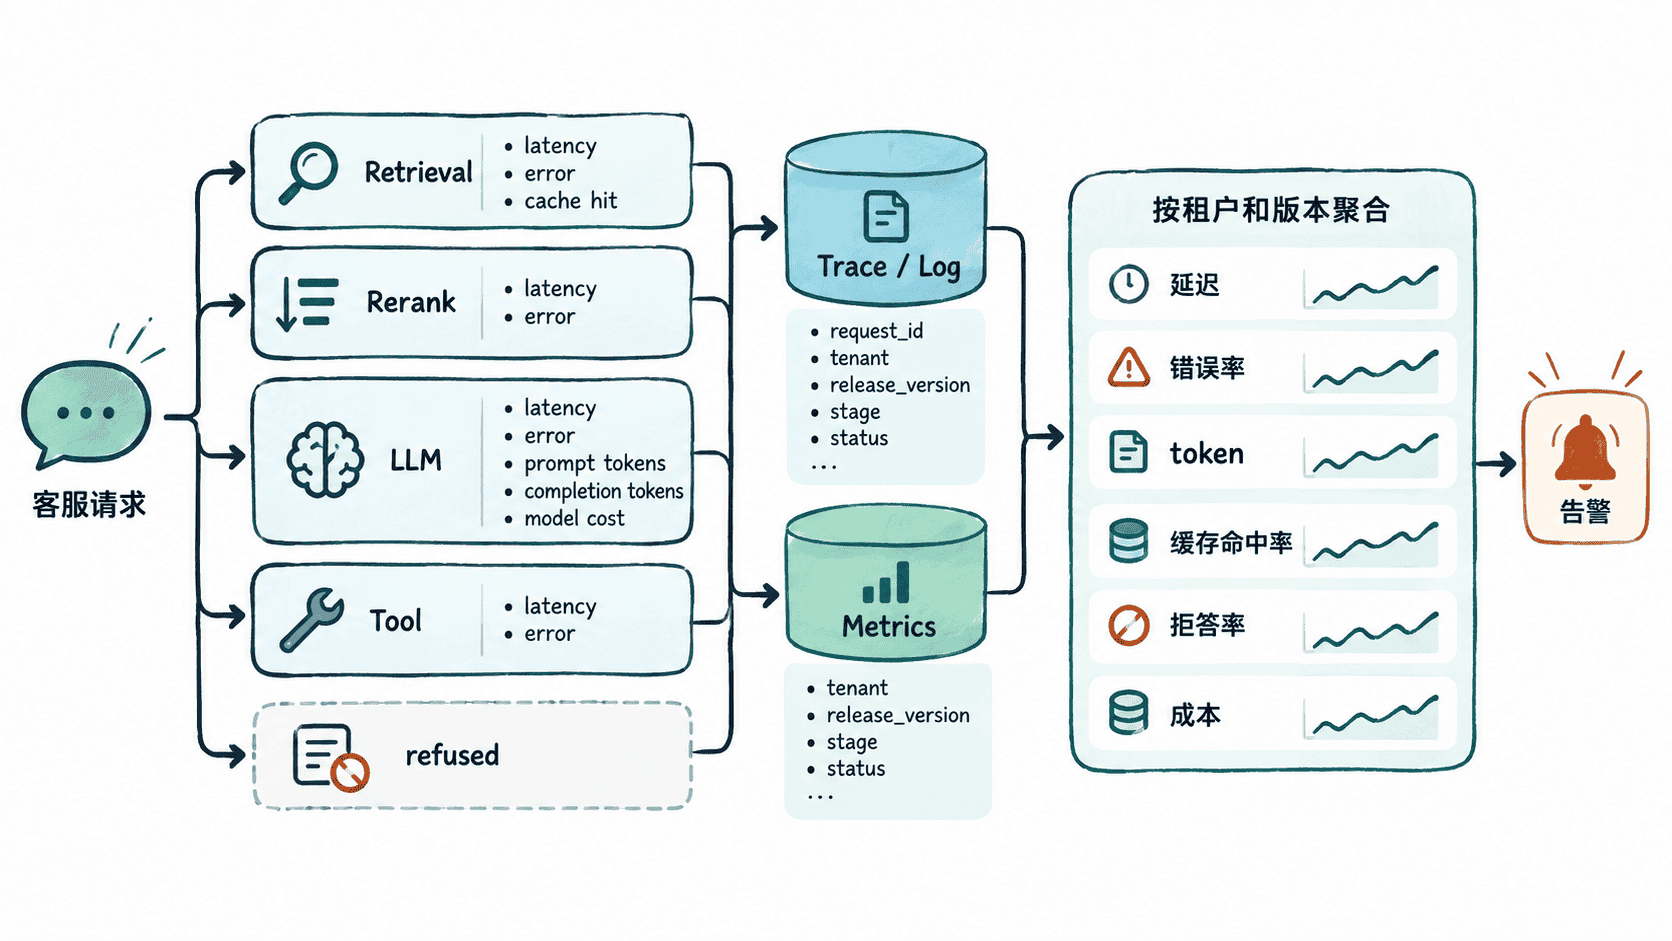
请求级数据至少要能回答三个问题:哪一段慢、哪一类请求失败、成本为什么上升。模型名称和发布版本也要记录,否则一次模型切换造成的 token 或延迟变化会被整体平均值掩盖。
指标标签要控制基数
适合做指标标签的是取值集合稳定且有限的维度,例如 tenant、release_version、stage、model 和结果状态。request_id、用户 ID、文档 ID、完整问题文本都属于高基数字段,应放进日志或 Trace,而不是直接作为 Metrics 标签。
推荐同时保留这些请求级字段:
| 字段 | 用途 |
|---|---|
| 各阶段耗时 | 判断检索、重排、模型或工具哪个环节变慢 |
error |
计算请求错误率并按阶段追根因 |
| prompt/completion token | 解释模型成本和上下文膨胀 |
cache_hit |
判断缓存策略是否失效 |
refused |
观察安全拒答、无答案拒答或策略变化 |
tenant、release_version |
隔离租户差异与发布回归 |
模型成本最好在请求完成时按“实际模型版本 + 实际 token + 当时价格表”计算并记录,后续再聚合。这样即使价格或模型路由发生变化,也能保留历史成本口径。
跑一个最小聚合器
下面的 Python 示例用四条固定请求记录模拟采集结果,并按租户和版本聚合阶段平均耗时、错误率、token、缓存命中率、拒答率与模型成本。真实系统可以把同样的字段发送到 OpenTelemetry、Prometheus 或数据仓库。
from collections import defaultdict

records = [
    {
        "tenant": "acme", "version": "v1",
        "retrieval_ms": 32, "rerank_ms": 11, "llm_ms": 420, "tool_ms": 0,
        "error": False, "prompt_tokens": 900, "completion_tokens": 120,
        "cache_hit": True, "refused": False, "cost_usd": 0.0021,
    },
    {
        "tenant": "acme", "version": "v1",
        "retrieval_ms": 40, "rerank_ms": 15, "llm_ms": 510, "tool_ms": 80,
        "error": True, "prompt_tokens": 1000, "completion_tokens": 0,
        "cache_hit": False, "refused": False, "cost_usd": 0.0016,
    },
    {
        "tenant": "acme", "version": "v2",
        "retrieval_ms": 28, "rerank_ms": 9, "llm_ms": 300, "tool_ms": 0,
        "error": False, "prompt_tokens": 850, "completion_tokens": 100,
        "cache_hit": True, "refused": False, "cost_usd": 0.0018,
    },
    {
        "tenant": "acme", "version": "v2",
        "retrieval_ms": 30, "rerank_ms": 10, "llm_ms": 330, "tool_ms": 70,
        "error": False, "prompt_tokens": 920, "completion_tokens": 130,
        "cache_hit": False, "refused": True, "cost_usd": 0.0020,
    },
]

groups = defaultdict(list)
for row in records:
    groups[(row["tenant"], row["version"])].append(row)

for (tenant, version), rows in sorted(groups.items()):
    n = len(rows)
    avg = lambda key: sum(r[key] for r in rows) / n
    error_rate = sum(r["error"] for r in rows) / n
    cache_rate = sum(r["cache_hit"] for r in rows) / n
    refusal_rate = sum(r["refused"] for r in rows) / n
    tokens = sum(r["prompt_tokens"] + r["completion_tokens"] for r in rows)
    cost = sum(r["cost_usd"] for r in rows)

    print(
        f"tenant={tenant} version={version} requests={n} "
        f"latency={avg('retrieval_ms'):.1f}/{avg('rerank_ms'):.1f}/"
        f"{avg('llm_ms'):.1f}/{avg('tool_ms'):.1f}ms "
        f"error={error_rate:.0%} tokens={tokens} "
        f"cache={cache_rate:.0%} refused={refusal_rate:.0%} "
        f"cost=${cost:.4f}"
    )
预期输出
tenant=acme version=v1 requests=2 latency=36.0/13.0/465.0/40.0ms error=50% tokens=2020 cache=50% refused=0% cost=$0.0037
tenant=acme version=v2 requests=2 latency=29.0/9.5/315.0/35.0ms error=0% tokens=2000 cache=50% refused=50% cost=$0.0038
示例把四段延迟按“检索/重排/模型/工具”的固定顺序输出。生产环境除了平均值,还应保留 p50、p95、p99 等分位数,因为少量长尾请求常常是客服体验恶化的真正来源。
用组合指标区分慢、贵和答坏
单个指标很容易误判。模型成本上升时,先同时观察 prompt token、completion token、缓存命中率和模型版本:prompt token 突增通常指向上下文膨胀,completion token 突增可能来自生成策略变化,缓存命中下降则会让更多请求重新经过完整链路。
延迟上升也要拆阶段。检索 p95 上升而模型稳定,优先看向量库、过滤条件和缓存;模型 p95 与 token 同时上升,则更像上下文或输出长度增加;工具耗时上升且错误率同步升高,应回到具体工具依赖的超时与熔断指标。
拒答率要区分“安全拒答”和“无知识拒答”。两者混成一个数只能发现异常,不能解释异常。若发布新版本后拒答率突然抬升,而错误率和延迟都正常,通常应优先检查检索阈值、提示词策略或答案置信门槛,而不是扩容。
告警先围绕基线而不是拍脑袋
新系统没有足够历史数据时,可以先用容量与 SLA 设置保守阈值,再逐步改成基于租户和版本基线的告警。至少要覆盖延迟分位数、请求错误率、单位请求 token、单位请求成本、缓存命中率和拒答率的突变。
最有用的监控不是“指标最多”,而是每个异常都能继续下钻到租户、版本和阶段,并最终关联到具体 Trace。这样成本异常、性能回归和质量问题才能在同一条证据链上被快速区分和定位。