
大模型应用开发 / 系统课时
把差评样本沉淀成回归测试
把差评样本沉淀成回归测试
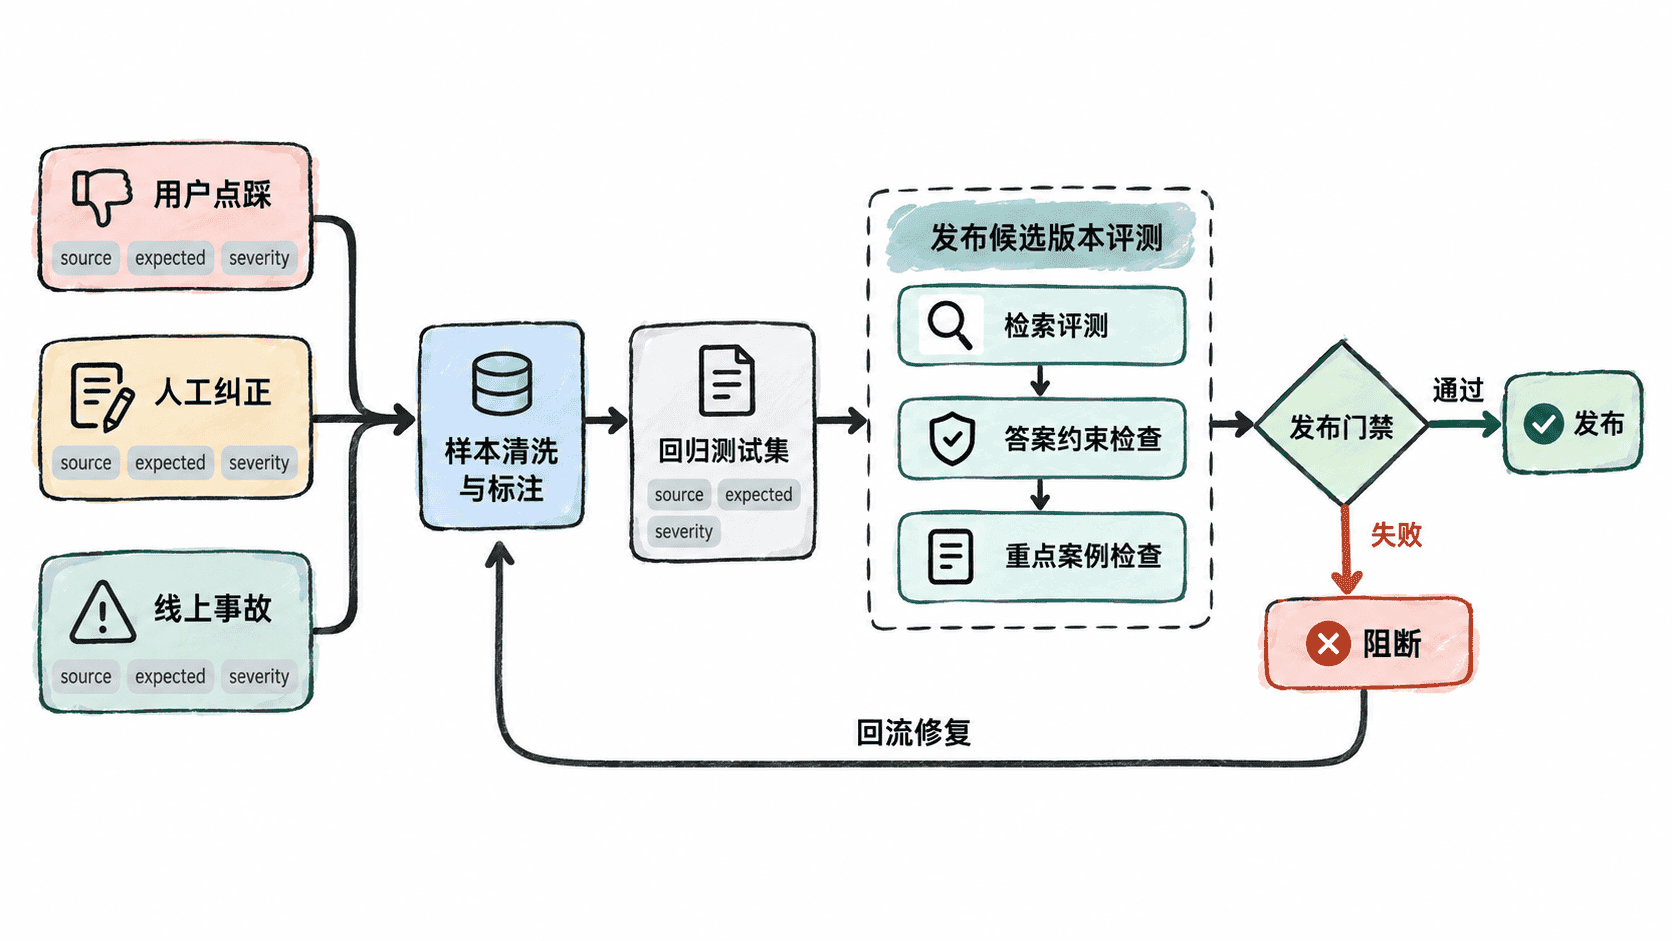
线上点踩、人工纠正和事故记录只有进入可重复执行的评测集,才会真正变成质量资产。本节把这些负反馈整理成带期望结果、严重级别和来源的回归样本,并用发布门禁自动阻止关键案例或核心指标明显退化。
学习目标
- 把差评、人工纠正和线上事故统一转成可追溯的回归样本
- 为样本定义可执行的期望结果,而不是只保存“用户不满意”
- 在版本发布前重跑重点案例,并用明确门槛决定是否阻断发布
先把负反馈变成可执行样本
一条差评不能直接拿来做测试。至少要补齐四类信息:输入是什么、当时用了哪些知识、期望行为是什么、失败有多严重。这样同一条样本才能在检索器、提示词、模型或知识库升级后重复执行并比较。
推荐把样本分为三类来源。用户点踩适合发现高频体验问题;人工纠正能给出较明确的正确答案或应答边界;线上事故则应标为高优先级,因为它往往涉及错误承诺、越权回答或关键业务流程失败。
为样本定义“期望结果”
每条样本最好同时包含内容约束和质量属性。内容约束回答“这次必须答对什么”,质量属性回答“怎样才算没有退化”。例如订单退款问题可以要求答案必须包含退款时限,禁止承诺不存在的补偿,并要求引用指定政策文档。
严重级别要直接参与门禁。普通措辞问题可以允许少量波动;涉及合规、费用、权限或数据泄露的案例则应设为 critical,只要一条失败就阻断发布。这样不会出现总体平均分变高,却把关键事故重新引入线上。
一个最小样本可以包含 id、query、mustContain、mustNotContain、severity 和 source。如果系统需要检索证据,还应记录期望文档 ID 或知识空间,避免模型答对了,但引用了错误或越权的资料。
用发布门禁自动检查退化
下面的示例模拟发布前对回归样本执行约束检查,并同时比较总体通过率。它不依赖第三方库,可以直接保存为 regression_gate.py 运行。
from dataclasses import dataclass

@dataclass
class Case:
    id: str
    must_contain: tuple[str, ...]
    must_not_contain: tuple[str, ...]
    severity: str

cases = [
    Case("refund-window", ("7个工作日",), ("立即到账",), "critical"),
    Case("invoice-entry", ("电子发票",), ("纸质发票仅限线下",), "normal"),
]

candidate_answers = {
    "refund-window": "审核通过后,退款通常会在7个工作日内原路退回。",
    "invoice-entry": "可以在订单详情页申请电子发票。",
}

baseline_pass_rate = 1.0
min_pass_rate = 0.95

failed = []
for case in cases:
    answer = candidate_answers[case.id]
    ok = all(x in answer for x in case.must_contain)
    ok = ok and all(x not in answer for x in case.must_not_contain)
    if not ok:
        failed.append(case)

pass_rate = (len(cases) - len(failed)) / len(cases)
critical_failed = any(case.severity == "critical" for case in failed)

if critical_failed or pass_rate < min(min_pass_rate, baseline_pass_rate):
    raise SystemExit("BLOCK: regression gate failed")

print(f"PASS: {len(cases)} cases, pass_rate={pass_rate:.0%}")
预期输出
PASS: 2 cases, pass_rate=100%真实系统里,candidate_answers 应来自待发布版本的批量调用结果。动态模型输出可以先转成结构化判定项,再与样本约束比较;对关键案例则应保留人工复核或更严格的确定性规则。
让回归集保持有价值
回归集不是把所有差评永久堆进去。相同根因的样本应去重或分组,否则一个热门问题会在总分中获得过高权重;已经失效的政策和产品规则也要随知识库版本更新,否则测试会反过来阻止正确改动。
每次线上事故修复后,应至少补一条能够复现事故的 critical 样本,并记录来源和修复版本。发布门禁则同时看总体指标与重点案例:总体质量不能明显下降,关键事故不能复发。这样差评才从一次性的运营反馈,变成下一次发布前可自动执行的质量防线。