
大模型应用开发 / 系统课时
画出 RAG 请求完整链路
画出 RAG 请求完整链路
一个 RAG 问答结果看似只是一段文本,背后却经过改写、召回、重排、上下文组装、生成和引用映射等多个阶段。把整条链路展开后,才能知道答案变差究竟发生在哪一层,并为每层留下可观测的输入输出。
学习目标
- 说清一条 RAG 请求从用户问题到带引用答案的完整处理顺序
- 为查询改写、召回、重排、上下文组装和生成定义可观测输入输出
- 根据异常所在阶段判断应该调整检索、排序、上下文还是生成策略
一条请求经过哪些阶段
最小可用的企业 RAG 链路可以拆成六个处理阶段。用户原始问题先经过查询改写,得到更适合检索的查询;召回层从知识库取得候选片段;重排层把与当前问题最相关的候选放到前面;上下文组装层根据长度预算组织证据;模型生成答案;最后把答案中的事实与来源文档建立引用关系后返回。
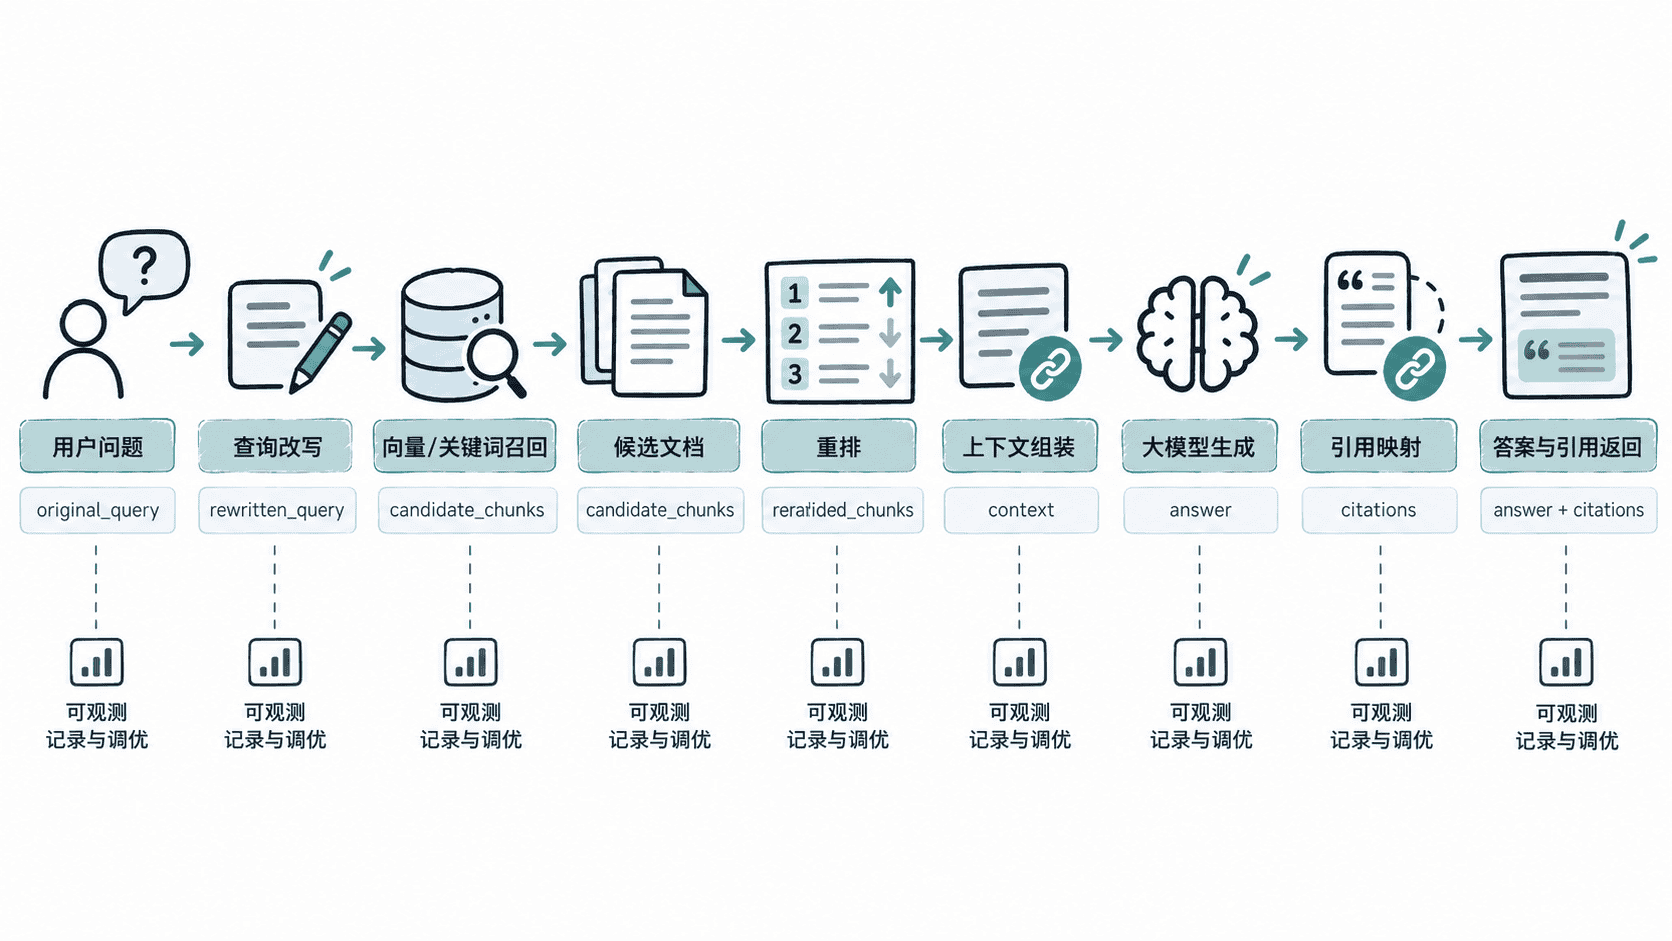
查询改写并非必选,但在用户问题过短、存在代词或口语表达时很有价值。例如“它支持多久退货”需要结合会话上下文,把“它”解析成具体产品后再检索。改写后的查询应该保留原问题约束,不能为了提高召回而擅自改变用户意图。
为每一层保留输入和输出
如果系统只保存最终答案,出现错误时几乎无法判断是“没检索到”还是“检索到了却没用好”。因此最小观测面应该覆盖每个主要阶段,而不是只记录一次模型调用。
| 阶段 | 建议记录的输入 | 建议记录的输出 | 首要检查点 |
|---|---|---|---|
| 查询改写 | 原问题、必要的会话上下文 | 改写后的检索查询 | 是否改变原意 |
| 召回 | 检索查询、过滤条件 | 候选片段及来源 | 正确证据是否进入候选集 |
| 重排 | 查询、候选片段 | 新排序及分数 | 正确证据是否被排到前部 |
| 上下文组装 | 排序后的片段、长度预算 | 最终模型上下文 | 是否截断关键证据或混入冲突信息 |
| 模型生成 | 问题、上下文、回答约束 | 答案文本 | 是否忠于已有证据 |
| 引用映射 | 答案、上下文来源标识 | 引用关系 | 引用是否真正支持对应结论 |
对于生产排查,一条请求最好使用统一的请求标识贯穿所有阶段。下面是观测记录的片段示例,用于说明应关联哪些数据,不是可独立运行的程序。
{
  "request_id": "<ID>",
  "original_query": "公司的标准退货期限是多少?",
  "rewritten_query": "公司标准退货政策中的退货期限",
  "retrieved_chunk_ids": ["<ID>", "<ID>"],
  "reranked_chunk_ids": ["<ID>", "<ID>"],
  "context_chunk_ids": ["<ID>"],
  "answer": "<MODEL_OUTPUT>",
  "citation_chunk_ids": ["<ID>"]
}
这里的 <ID> 和 <MODEL_OUTPUT> 都是动态值,实际记录会随请求变化。验证方法是使用同一个 request_id 检查各阶段日志能否串联起来,并确认引用中的片段确实来自最终送入模型的上下文,而不是来自已经被丢弃的候选结果。
从错误现象反推问题层级
最终答案错误,并不意味着首先要换模型。如果正确文档从未进入候选集,应先检查查询改写、过滤条件和召回策略;正确文档已经召回却长期排在后面,问题更可能在重排;证据排名正确却没有进入最终提示词,则应检查上下文预算、去重和截断规则。
只有在上下文已经包含明确且一致的证据,而生成结果仍偏离证据时,才应重点检查回答提示、模型参数和生成约束。引用错误也需要单独定位:答案内容可能正确,但如果引用指向不支持该结论的文档,用户仍然无法验证结果。
用最小闭环验收整条链路
最小闭环不要求一开始就拥有复杂评测平台,但应能对一条测试问题完整回答四个问题:改写后的查询是什么、召回了哪些片段、最终给模型的证据是什么、答案引用了哪一段来源。只要其中任一环不可查看,故障就容易被错误归因到最后的生成模型。
当原始问题、候选证据、排序结果、最终上下文、生成答案和引用能够按同一请求标识串起来时,RAG 才从“能回答”变成“能定位、能调优、能验收”的工程链路。