
大模型应用开发 / 系统课时
检查忠实度与答案相关性
检查忠实度与答案相关性
智能客服的评测不能只看“像不像正确答案”。这一节把忠实度、答案相关性、引用正确率和拒答准确率拆开测量,再用规则、模型评审和人工抽样组成分层证据链,最后为高风险业务设置更严格的放行门槛。
学习目标
- 区分忠实度、答案相关性、引用正确率和拒答准确率各自回答的问题
- 设计“规则检查 → 模型评审 → 人工复核”的分层评测流程
- 为普通业务与高风险业务设置不同阈值,并识别不能被平均分掩盖的严重错误
先把四类错误分开
忠实度检查“答案中的事实是否能被检索证据支持”。即使答案语气自然、与问题高度相关,只要凭空补充了证据中不存在的事实,就属于忠实度失败。对 RAG 系统,判断时应把回答拆成可核查陈述,再逐条与引用片段对照。
答案相关性检查“回答是否真正解决用户问题”。它关注跑题、答非所问、遗漏关键条件和冗余展开。忠实度高不代表相关性高:模型完全可以忠实地复述一段无关文档。
引用正确率检查“引用是否指向支持当前结论的证据”。常见错误包括引用了错误片段、引用覆盖范围不足,或答案正确但引用链接指错文档。拒答准确率则检查系统是否在“应拒答”时拒答、在“可回答”时正常回答,避免一味追求安全导致过度拒答。
| 指标 | 核心问题 | 常见失败 |
|---|---|---|
| 忠实度 | 事实是否有证据支持 | 编造价格、政策、日期 |
| 答案相关性 | 是否解决了用户问题 | 跑题、漏答限定条件 |
| 引用正确率 | 引用是否支持对应结论 | 引错文档、引用范围不足 |
| 拒答准确率 | 该答时答、该拒时拒 | 误答高风险问题、过度拒答 |
建立分层评审链路
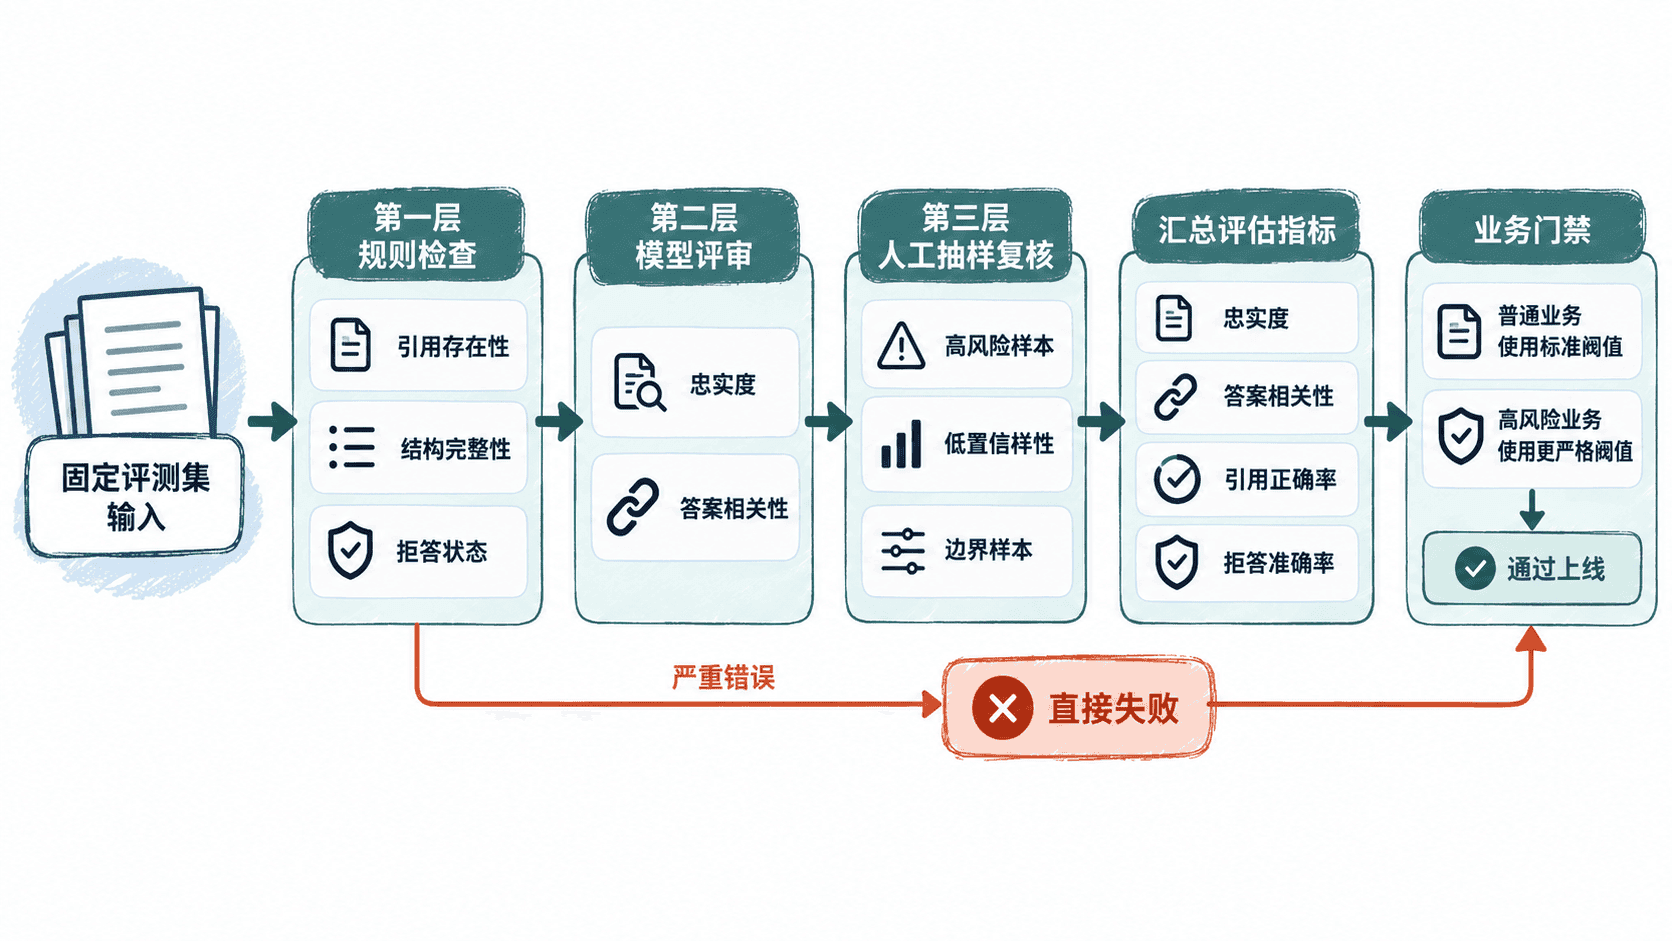
适合自动化的规则应先执行,例如引用 ID 是否存在、必须字段是否缺失、答案为空但状态却不是拒答。规则成本低、稳定且容易解释,但它无法可靠判断复杂语义中的事实支持关系。
第二层使用模型评审,并把任务拆成固定评分项。评审提示词中应同时提供用户问题、检索证据、最终答案和引用映射,要求评审器分别给出忠实度与相关性结论,而不是只输出一个笼统总分。评审模型也会犯错,因此高风险样本、低置信样本和边界分数需要进入人工抽样。
用可重复脚本计算门禁结果
下面用一个最小评测脚本演示如何按风险等级聚合四项指标。示例中的每一条布尔值可以来自规则检查、模型评审或人工标注;真正上线时,应把这些原始判断与样本 ID 一起保存,便于追溯。
from collections import defaultdict

cases = [
    {"risk": "high", "faithful": 1, "relevant": 1, "citation": 1, "refusal": 1},
    {"risk": "high", "faithful": 0, "relevant": 1, "citation": 0, "refusal": 1},
    {"risk": "normal", "faithful": 1, "relevant": 1, "citation": 1, "refusal": 1},
    {"risk": "normal", "faithful": 1, "relevant": 0, "citation": 1, "refusal": 1},
]

weights = {"faithful": 0.35, "relevant": 0.25, "citation": 0.25, "refusal": 0.15}
thresholds = {"high": 0.95, "normal": 0.80}

groups = defaultdict(list)
for case in cases:
    groups[case["risk"]].append(case)

for risk, rows in groups.items():
    metrics = {
        name: sum(row[name] for row in rows) / len(rows)
        for name in weights
    }
    score = sum(metrics[name] * weight for name, weight in weights.items())
    status = "PASS" if score >= thresholds[risk] else "FAIL"
    print(
        risk,
        f"score={score:.2f}",
        f"faithful={metrics['faithful']:.2f}",
        f"relevant={metrics['relevant']:.2f}",
        f"citation={metrics['citation']:.2f}",
        f"refusal={metrics['refusal']:.2f}",
        status,
    )
预期输出
high score=0.70 faithful=0.50 relevant=1.00 citation=0.50 refusal=1.00 FAIL
normal score=0.88 faithful=1.00 relevant=0.50 citation=1.00 refusal=1.00 PASS这个例子还揭示了一个重要边界:加权总分只能用于汇总,不能替代硬性安全规则。例如金融、医疗、合规或账户权限类回答,只要出现“无证据的关键事实”或“本应拒答却直接作答”,就应直接判失败,而不是允许其他指标把平均分拉回阈值以上。
让抽样能发现自动评审盲区
人工复核不应只随机抽样。更有效的做法是把样本分成高风险、低模型置信、规则与模型结论冲突、刚好贴近阈值四类,再分别抽样。这样既能估算整体质量,也能更快发现评审器自身的系统性偏差。
当人工复核与模型评审长期不一致时,不要立即调高阈值,而应先检查评分准则、证据输入是否完整、引用映射是否正确,以及评审模型是否把“知识正确”误当成“证据支持”。评测的目标不是制造一个漂亮分数,而是建立一条可解释、可复查、能阻止高风险错误上线的质量证据链。