
大模型应用开发 / 系统课时
排查高峰期延迟与超时
排查高峰期延迟与超时
高峰期客服请求变慢时,不能只看总耗时或直接归因于大模型。本节用链路追踪把一次 RAG 请求拆成排队、检索、模型、工具和连接池等待等阶段,并给出从定位瓶颈到容量调整、降级和复验的完整路径。
学习目标
- 能根据 Trace 中的阶段耗时、状态码和等待时间判断主要瓶颈。
- 能区分并发排队、向量检索变慢、模型限流、工具超时与连接池耗尽。
- 能针对瓶颈选择扩容、限流、缓存、熔断或功能降级,并验证修复效果。
先把端到端耗时拆成阶段
一次知识库问答的总延迟通常由多个阶段叠加:入口排队、查询改写、向量检索、重排、模型生成、工具调用,以及数据库或 HTTP 连接池等待。高峰期排障的关键不是找“最慢服务”,而是找到请求在什么阶段开始积压,以及积压是否会向下游放大。
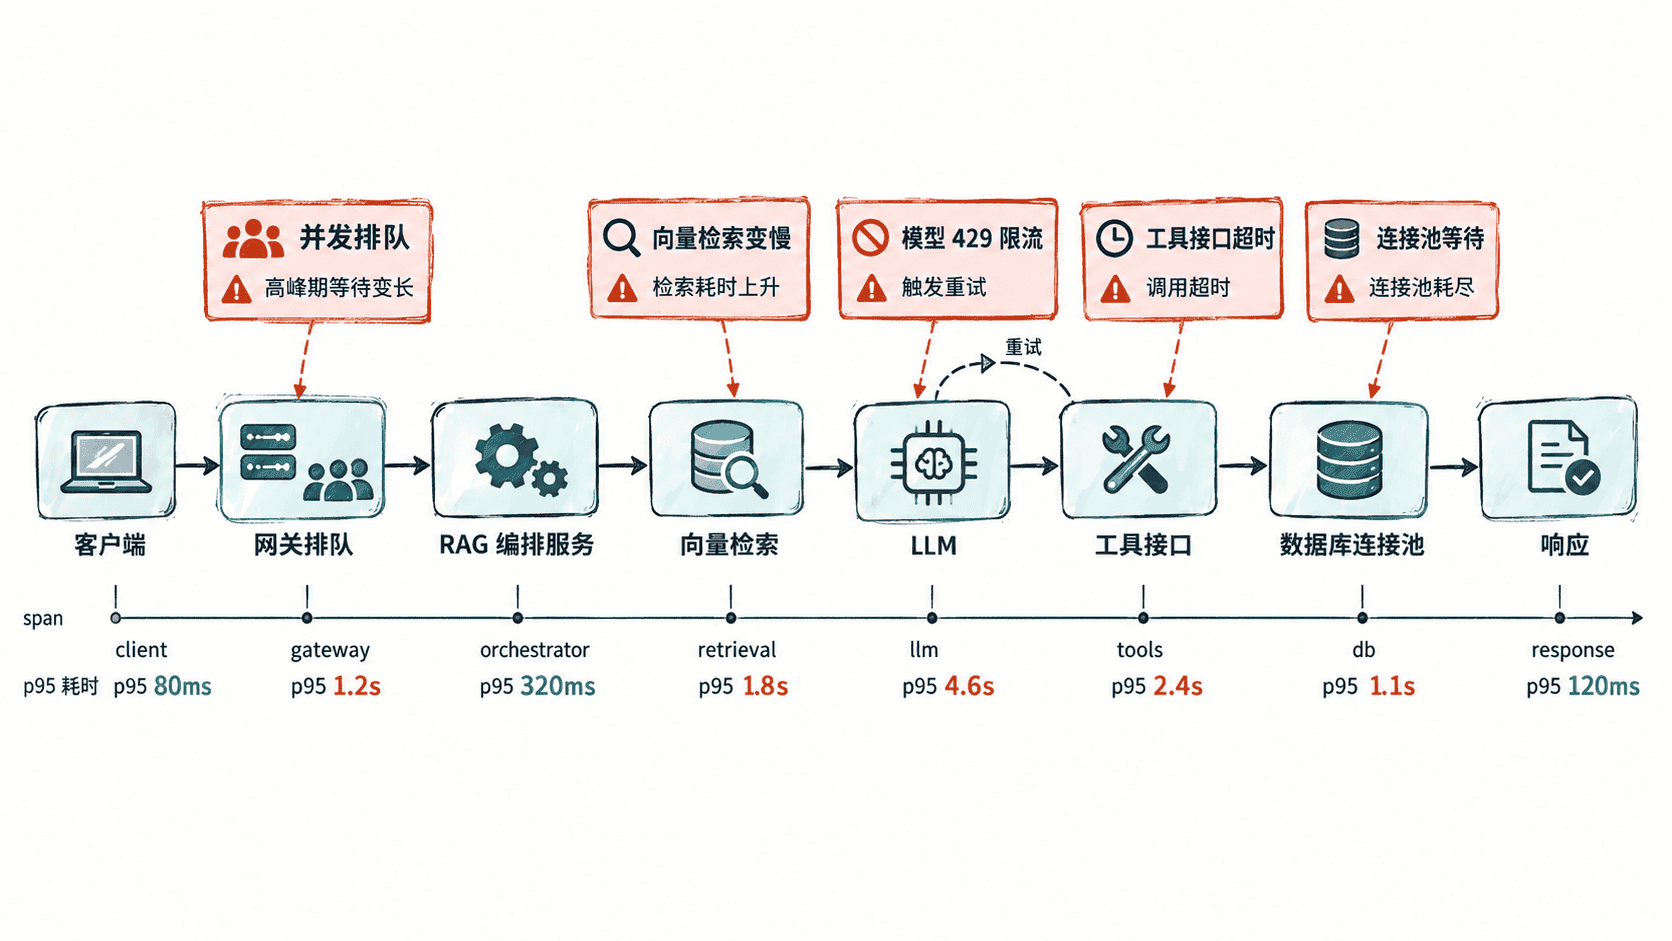
为每个阶段建立独立 span,并至少记录 trace_id、阶段名、开始时间、耗时、状态码、重试次数和关键资源等待时间。只记录一个总耗时指标,会把“入口排队 800 ms”和“模型执行 800 ms”混成同一种问题。
用链路追踪按顺序定位
先看请求总量与并发数,再看入口排队时间。如果 queue_wait 的 p95 随并发上升而明显变长,而检索与模型 span 本身仍稳定,说明瓶颈在应用实例、线程池或并发闸门,而不是下游服务。
接着检查检索、模型和工具 span。向量检索变慢通常表现为 vector_search p95、存储 CPU 或 I/O 同时上升;模型限流则更应关注 429、Retry-After、重试次数和首 Token 延迟;工具接口问题常出现固定接近客户端超时阈值的耗时。最后看连接池等待,如果活跃连接长期等于池上限且 pool_wait 上升,才把它判为连接池瓶颈。
下面的本地脚本演示如何用已经聚合好的阶段 p95 快速筛出优先调查对象。真实系统应由 APM 或指标平台生成这些聚合值。
stages = [
    {'name': 'queue_wait', 'p95_ms': 820, 'limit_ms': 300, 'hint': '并发排队'},
    {'name': 'vector_search', 'p95_ms': 180, 'limit_ms': 250, 'hint': '向量检索'},
    {'name': 'llm', 'p95_ms': 2450, 'limit_ms': 2200, 'hint': '模型 429 或重试'},
    {'name': 'tool_http', 'p95_ms': 1600, 'limit_ms': 1200, 'hint': '工具超时'},
    {'name': 'db_pool_wait', 'p95_ms': 410, 'limit_ms': 200, 'hint': '连接池等待'},
]

for item in stages:
    state = '瓶颈' if item['p95_ms'] > item['limit_ms'] else '正常'
    print(f"{item['name']}: {item['p95_ms']}ms / {item['limit_ms']}ms -> {state},{item['hint']}")
预期输出
queue_wait: 820ms / 300ms -> 瓶颈,并发排队
vector_search: 180ms / 250ms -> 正常,向量检索
llm: 2450ms / 2200ms -> 瓶颈,模型 429 或重试
tool_http: 1600ms / 1200ms -> 瓶颈,工具超时
db_pool_wait: 410ms / 200ms -> 瓶颈,连接池等待把症状映射到修复动作
| 主要信号 | 更可能的根因 | 优先修复动作 |
|---|---|---|
queue_wait 高,后续阶段正常 |
实例并发不足或入口无限制接入 | 增加可承载实例,设置并发上限与排队上限,超限快速失败或转低成本路径 |
vector_search p95 上升 |
候选集过大、过滤低效、分片或存储资源不足 | 收紧 top_k,优化过滤与索引,预热热点数据,按容量增加副本 |
| LLM 出现 429、重试与首 Token 变慢 | 模型侧 QPS 或并发受限 | 限制并发与最大输出 Token,尊重退避,必要时切换备用模型 |
| 工具调用接近超时阈值 | 外部接口慢或故障扩散 | 设置独立短超时、熔断与缓存,非关键工具降级为“不调用” |
pool_wait 高且活跃连接等于上限 |
连接持有过久或池容量不足 | 先缩短事务与连接占用,再在数据库容量允许时增大连接池 |
扩容不是默认答案。若下游模型、向量库或数据库已经到容量上限,继续增加应用实例只会制造更多并发。高峰期更稳妥的策略是先做入口背压,再按业务价值降级:缩小检索候选、跳过非关键重排、限制生成长度、关闭可选工具,保证核心问答路径可用。
修复后用同一组指标复验
修复后必须在接近真实峰值的并发下复测,并用同一口径比较 p50、p95、p99、超时率、错误率和拒答率。若只看到平均延迟下降,尾部请求仍可能继续超时。
验收时还要确认瓶颈没有被“搬家”:例如入口排队下降后,模型 429 是否上升;连接池增大后,数据库 CPU 是否被打满;工具超时缩短后,回答质量是否明显下降。只有端到端 SLO 与关键质量指标同时恢复,调整才算真正闭环。