
大模型应用开发 / 系统课时
选择模型与向量存储组合
选择模型与向量存储组合
企业知识问答不是“挑一个最强模型”就结束,而是要把生成、向量化、候选检索和重排分别放到合适的位置。本篇给出一套按合规、吞吐、成本和可替换性做组合决策的方法,最终得到能上线、也方便后续更换供应商的最小方案。
学习目标
- 说清对话模型、Embedding、重排模型和向量存储各自负责什么。
- 能按数据合规、吞吐与成本约束筛选组合,而不是只看单项效果。
- 为四类组件定义稳定边界,避免业务代码直接绑定供应商 SDK。
先按职责拆开四类组件
企业客服的在线链路通常是“问题向量化 → 向量召回 → 可选重排 → 组织上下文 → 对话模型生成”。四类组件处理的数据不同,选型指标也不应混在一起。
| 组件 | 主要输入与输出 | 选型时优先看 |
|---|---|---|
| 对话模型 | 问题与上下文 → 回答 | 指令遵循、上下文长度、延迟、单次成本 |
| Embedding | 文本 → 向量 | 语义召回质量、维度、吞吐、语言覆盖 |
| 重排模型 | 问题与候选文档 → 新排序 | Top-K 精度、额外延迟、批处理能力 |
| 向量存储 | 向量与元数据 → 相似候选 | 过滤能力、索引规模、读写延迟、运维边界 |
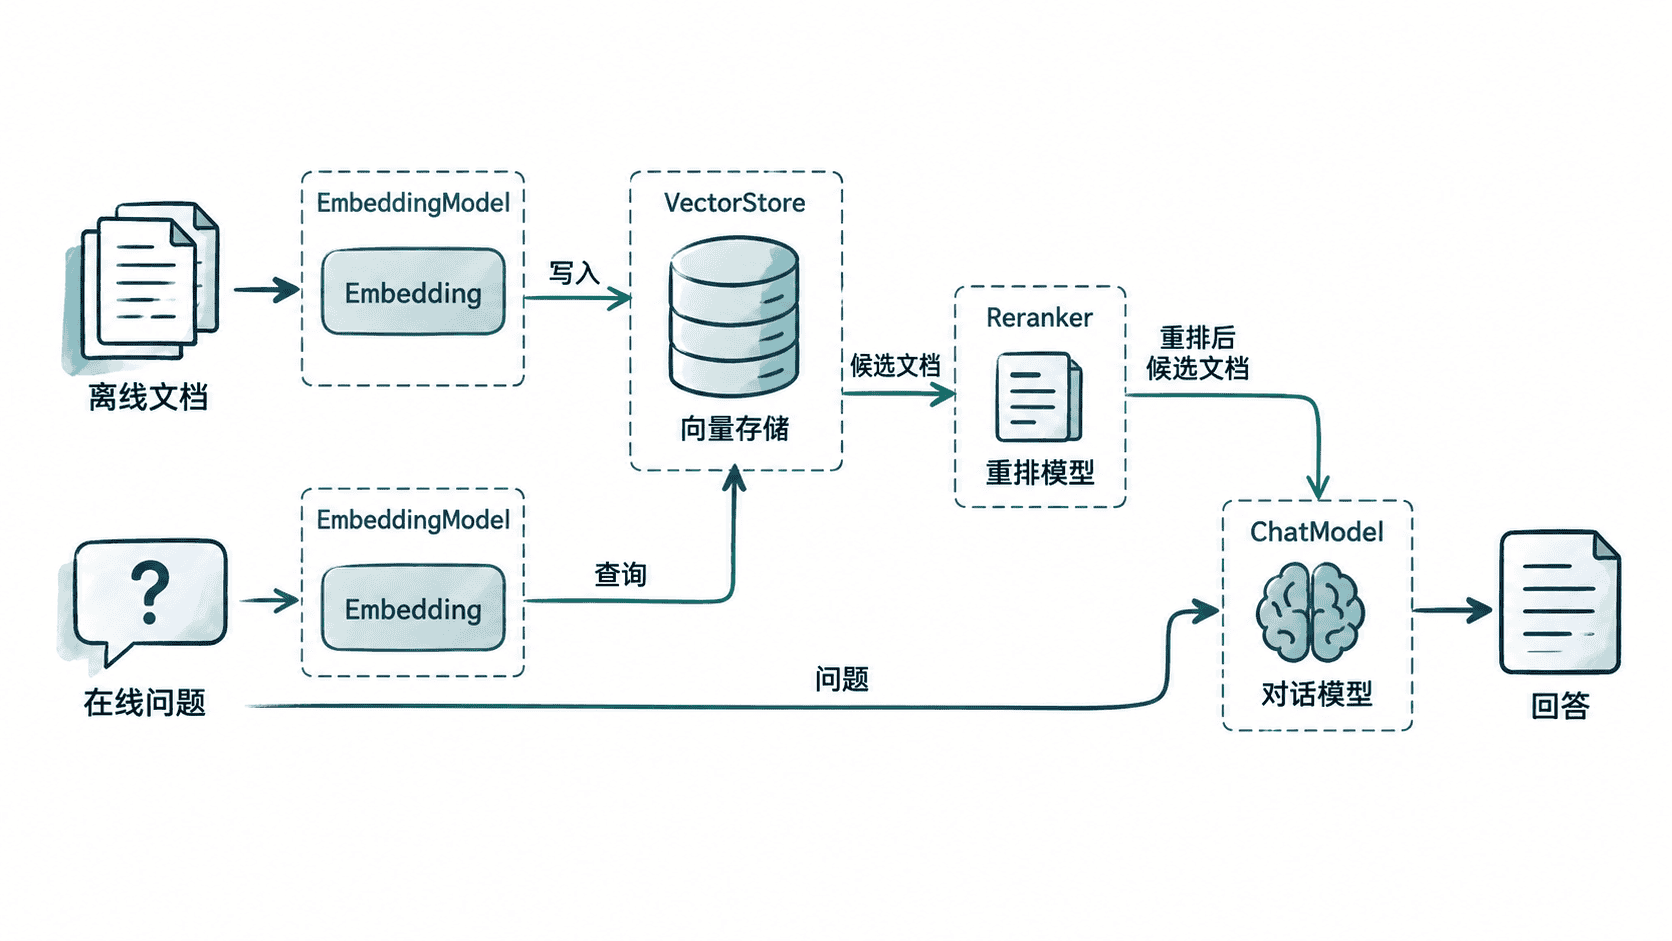
最小闭环不一定需要重排模型。文档量较小、召回结果已经稳定时,可先使用“Embedding + 向量存储 + 对话模型”;当候选集合变大、相似文档很多或 Top-K 顺序直接影响答案时,再增加重排层。
用四个约束做组合决策
先确定数据合规边界。需要逐项确认原始文档、用户问题、召回片段和日志是否允许离开指定网络或地域。只要其中一类数据受限制,对应模型调用与向量存储就必须部署在允许的边界内,不能只检查最终回答。
其次看吞吐和延迟。Embedding 常发生在批量入库和在线查询两个阶段,重排会对每次请求追加计算,对话模型通常又是整条链路最慢的一段。高并发场景应分别估算三段吞吐,而不是用一个“模型 QPS”概括整条链路。
再看成本结构。向量存储主要受向量数量、维度、副本和查询量影响;模型侧则受请求次数、输入长度和生成长度影响。降低成本时,先减少无效候选和重复调用,通常比直接牺牲回答质量更可控。
最后检查可替换性。业务层只依赖统一的 ChatModel、EmbeddingModel、Reranker 和 VectorStore 契约,供应商特有的鉴权、请求字段、重试策略和 SDK 类型都留在适配层。这样更换其中一个组件时,不需要改检索流程和客服业务规则。
按业务风险选择组合强度
低风险内部问答可以优先追求低成本和较短延迟;面向客户、涉及退款、合同或权限说明时,应把检索准确性和回答可追溯性放在前面。重排模型也应按需启用:它解决的是“候选已经召回,但顺序不够可靠”,不能修复知识库缺文档或切分错误。
如果预计未来会在云端模型、自托管模型和不同向量库之间切换,第一版就应固定输入输出契约,并把供应商配置放到部署配置中。组合选择的结果不是一张永久绑定的产品清单,而是一组满足当前约束、又允许逐个替换的组件边界。