
大模型应用开发 / 系统课时
按语义边界切分长文档
按语义边界切分长文档
长文档不能直接整篇向量化,也不能只按固定字符数硬切。本节用“结构优先、长度收口、必要重叠”的方法,让条款、流程和表格形成能独立回答问题的片段,并通过可运行示例观察重叠如何保持上下文连续。
学习目标
- 比较字符、段落、标题与结构切分对检索语义的影响
- 设计不跨越关键语义边界的片段长度与重叠策略
- 为条款、流程和表格保留可单独回答问题的最小语义单元
先按结构切,再按长度收口
语义切分的核心不是寻找一个万能长度,而是先判断哪些内容必须一起出现。标题约束下方段落,条款中的条件与例外相互依赖,流程步骤存在先后关系,表头定义每个单元格的含义。只有先保住这些关系,长度限制才有意义。
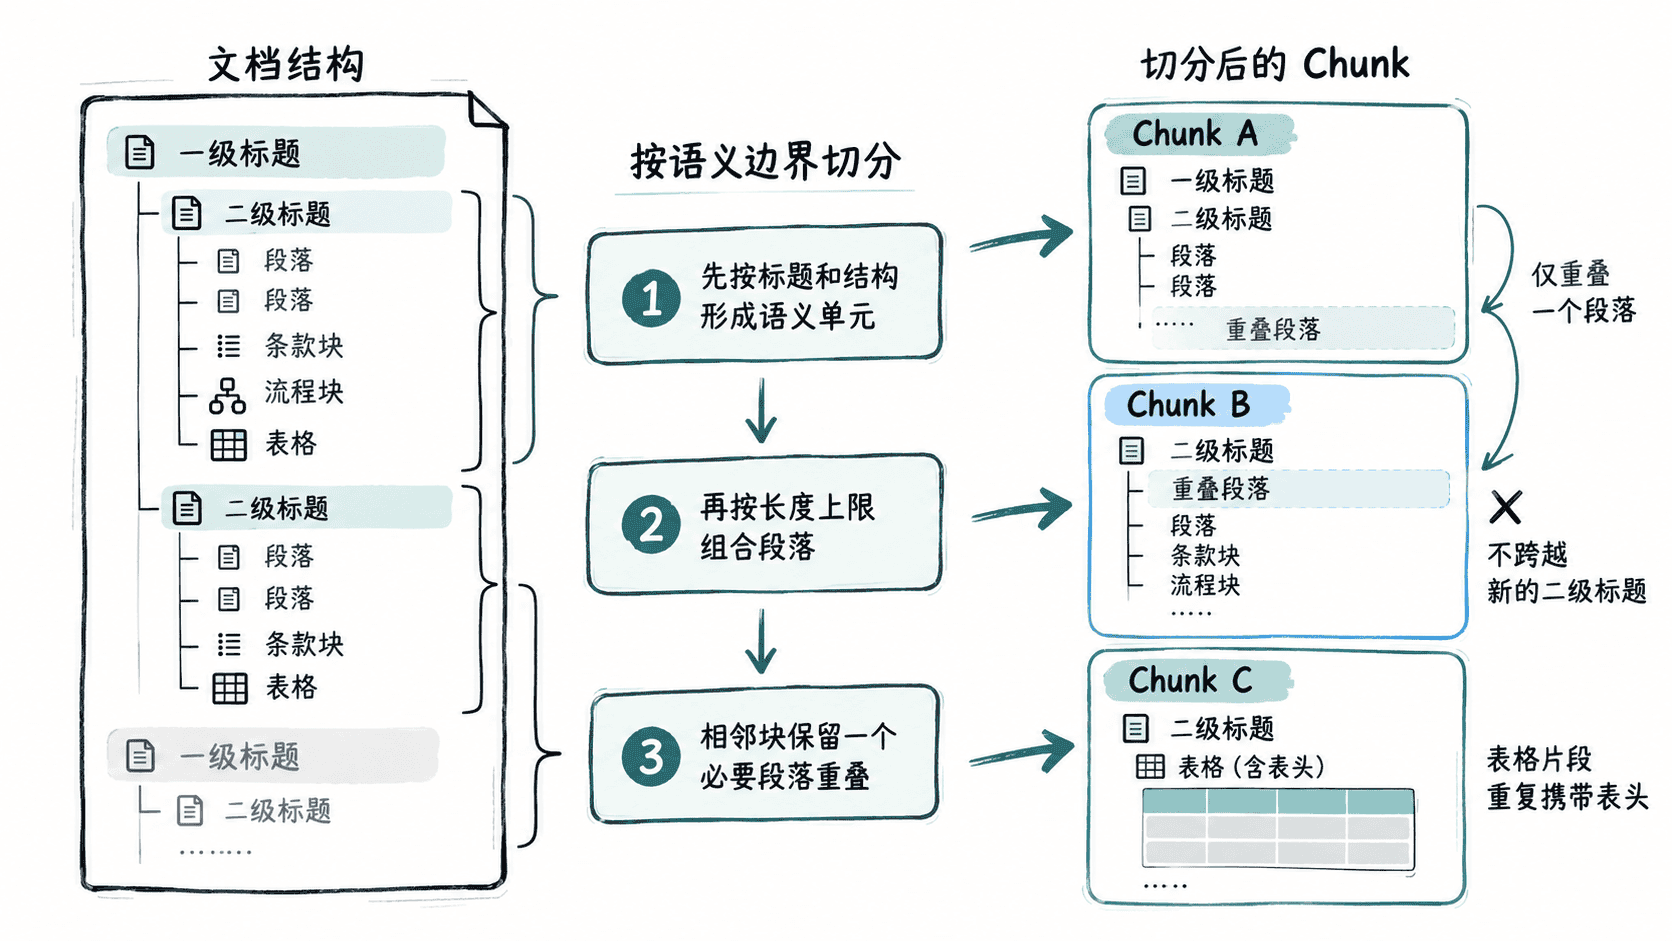
固定字符切分实现最简单,但可能把“适用条件”和下一句“例外情况”分到两个片段。结构优先切分则先把标题、段落、条款或表格行当作原子,再在同一结构范围内控制片段大小,因此更适合企业知识库。
四种边界各有适用范围
| 切分方式 | 优点 | 主要风险 | 适合场景 |
|---|---|---|---|
| 固定字符 | 实现简单、长度稳定 | 容易截断句子和条款 | 无明显结构的纯文本兜底 |
| 段落 | 保留自然表达 | 单段可能过长或过短 | FAQ、说明文、新闻稿 |
| 标题 | 上下文清晰 | 一个章节可能远超模型限制 | 手册、制度、产品文档 |
| 结构单元 | 最能保留业务关系 | 需要识别条款、流程、表格等类型 | 高价值企业知识与客服规则 |
工程上通常不是四选一,而是组合:先按标题或业务结构划定不可跨越的边界,再以段落为原子组装片段;若单个原子仍然过长,再退到句子或字符级二次切分。
用段落原子实现结构优先切分
下面的示例在同一标题内按字符预算组合段落。当加入新段落会超过上限时,先输出当前片段,再把上一段作为重叠上下文带入下一个片段。新标题出现后不会继承旧标题的内容。
from __future__ import annotations

def chunk_sections(sections: list[dict], max_chars: int = 35) -> list[str]:
    chunks: list[str] = []
    for section in sections:
        current: list[str] = []
        for paragraph in section["paragraphs"]:
            candidate = "\n".join([section["title"], *current, paragraph])
            if current and len(candidate) > max_chars:
                chunks.append("\n".join([section["title"], *current]))
                # 只继承上一段,作为跨片段的最小必要上下文。
                current = [current[-1], paragraph]
            else:
                current.append(paragraph)
        if current:
            chunks.append("\n".join([section["title"], *current]))
    return chunks

sections = [
    {
        "title": "退款条件",
        "paragraphs": [
            "订单已支付。",
            "支付后 7 天内可申请退款。",
            "虚拟商品激活后不支持退款。",
        ],
    },
    {
        "title": "处理流程",
        "paragraphs": [
            "客服先核对订单号。",
            "确认符合条件后创建退款单。",
            "财务完成原路退回。",
        ],
    },
]
for index, chunk in enumerate(chunk_sections(sections), start=1):
    print(f"[{index}] {chunk.replace(chr(10), ' | ')}")
预期输出
[1] 退款条件 | 订单已支付。 | 支付后 7 天内可申请退款。
[2] 退款条件 | 支付后 7 天内可申请退款。 | 虚拟商品激活后不支持退款。
[3] 处理流程 | 客服先核对订单号。 | 确认符合条件后创建退款单。
[4] 处理流程 | 确认符合条件后创建退款单。 | 财务完成原路退回。
示例把字符数当作便于观察的预算,生产系统更适合使用实际嵌入模型或生成模型的 tokenizer 计数。若一个段落本身已经超过上限,还需要在该段内部继续按句子切分,而不是让超长片段绕过限制。
重叠只补连续性,不复制整章
重叠的作用是避免答案证据恰好落在边界两侧,不是把上一片段大面积复制到下一片段。复制过多会增加索引体积,也会让检索结果出现多个高度相似的候选,挤占真正不同的证据。
更稳妥的做法是只继承完成语义所需的最小上下文:条款可以带上上一条前置条件,流程可以带上前一步的结果,普通说明文通常只需要上一段或标题。是否保留重叠应由检索问题验证,而不是机械使用固定比例。
条款流程和表格要有自己的原子单位
条款切分时,应把“适用对象、条件、动作、例外”尽量留在同一片段;如果例外被切走,客服很可能只检索到主规则而给出错误承诺。流程切分时,应让一个片段至少包含能完成一个业务动作所需的前置条件和结果,避免只留下孤立的“点击提交”或“进入下一步”。
表格则应把表头复制到每个相关片段,并保证一行中的关键字段不被拆开。大表可以按业务分组或行集合切分,但每个片段都应让读者知道“这个值是什么、属于谁、单位是什么”。
用真实问题验收边界
切分完成后,应从客服真实问题中抽取一小组代表性查询,观察正确证据是否能在一个或少量片段中完整命中。如果经常出现“召回了主规则却缺少例外”“命中了数值却看不到字段名”,优先修边界与结构;如果片段内容完整但相关结果被大量相似片段淹没,再缩小重叠或调整长度。
好的切分结果不是片段长度整齐,而是每个片段都有清晰主题、足够上下文和明确边界。只要读者无需回到原文补齐关键条件,这个语义单元才真正适合进入向量检索。