
大模型应用开发 / 系统课时
定位漏召回与错误召回
定位漏召回与错误召回
当客服问答出现“明明知识库里有却找不到”或“召回了一堆不相关内容”时,最有效的做法不是先把 topK 调大,而是保存检索链路每一层的候选、分数和过滤结果,用失败样本逐层定位问题发生在哪个环节。
学习目标
- 能把一次失败检索拆成入库、切分、初召回、过滤和重排五个检查点
- 能根据候选与分数判断未入库、切分错误、过滤过严、向量偏差和重排误判
- 能用最小诊断脚本复现失败,并验证修复是否真正改善召回
先把失败链路完整记录下来
排查检索质量时,至少要保存用户问题、目标文档标识、初召回候选、向量分数、过滤原因、重排分数和最终排名。否则你只看到最终 topK,很难判断正确文档究竟是没被检索到,还是中途被过滤或重排挤掉。
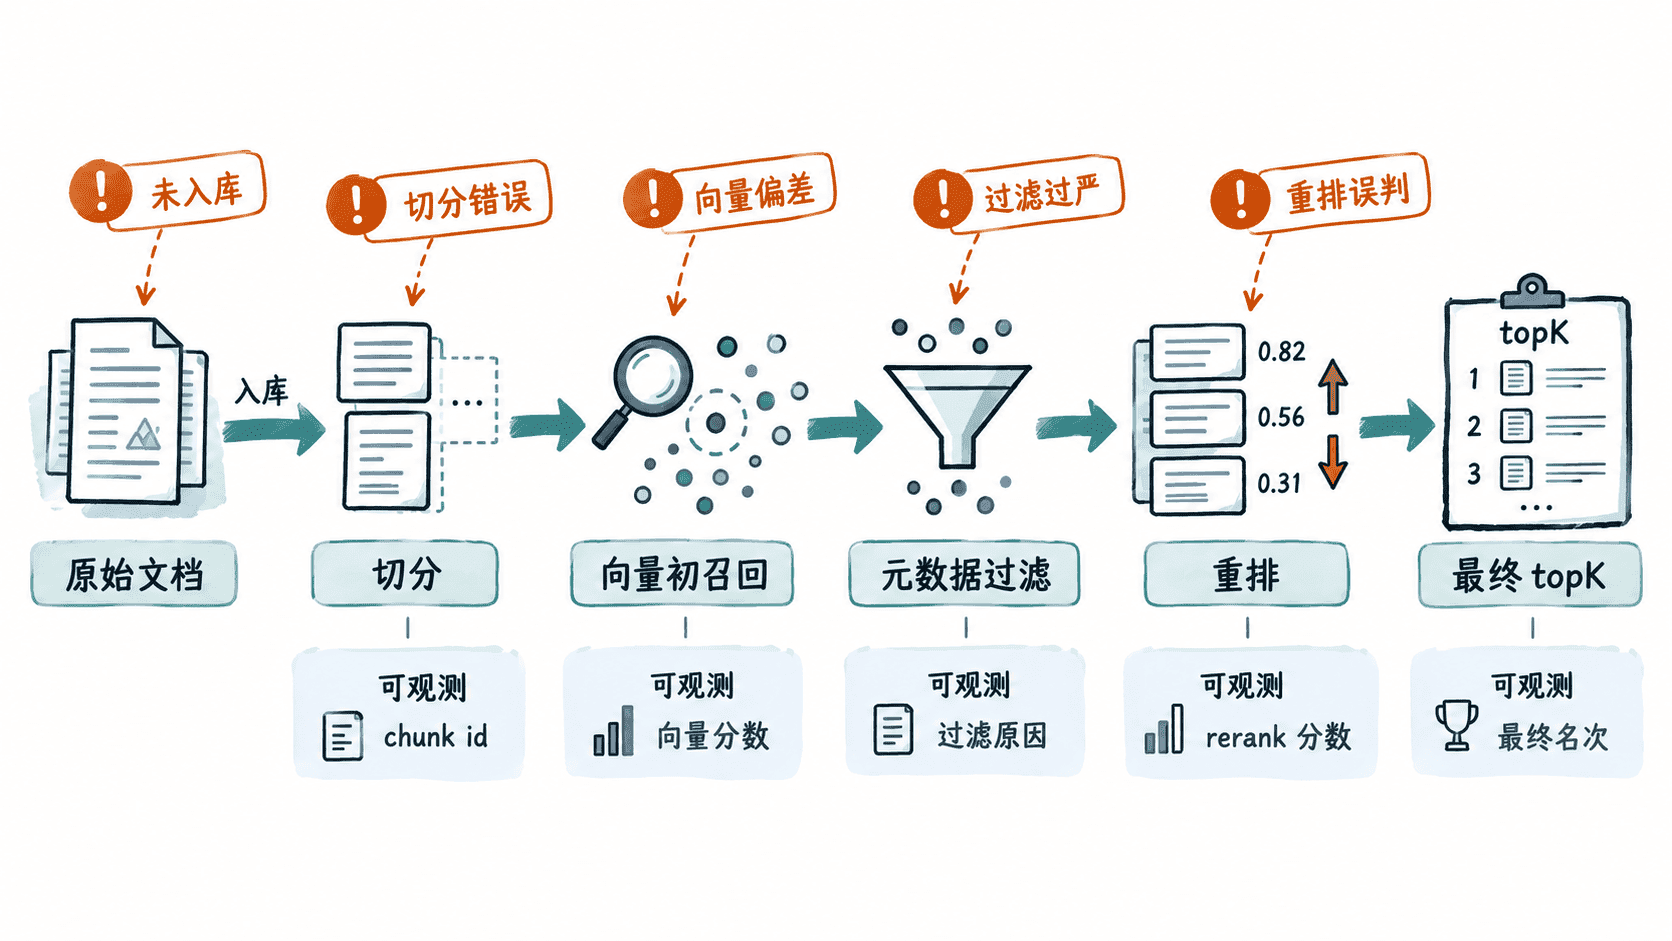
一个实用原则是:先确认目标内容在哪一层第一次消失。目标文档从未入库开始就不存在,与它曾经进入初召回但被重排压到后面,是两类完全不同的问题,修复手段也不同。
用最小样本复现一次失败
下面的脚本模拟一条检索链路,并打印每层候选。实际系统中可把同样的字段写入结构化日志或评测表。
from dataclasses import dataclass

@dataclass
class Candidate:
    chunk_id: str
    vector_score: float
    category: str
    rerank_score: float | None = None

query = "企业版是否支持单点登录"
target_chunk = "doc-sso-01"

initial = [
    Candidate("doc-billing-02", 0.82, "billing"),
    Candidate("doc-sso-01", 0.79, "security"),
    Candidate("doc-login-03", 0.77, "security"),
]

# 模拟一个错误过滤条件:只保留 billing 类文档。
filtered = [c for c in initial if c.category == "billing"]

# 实际系统中这一层通常由 reranker 产生分数。
for c in filtered:
    c.rerank_score = 0.91 if c.chunk_id == "doc-billing-02" else 0.0

print("initial:", [(c.chunk_id, c.vector_score) for c in initial])
print("filtered:", [c.chunk_id for c in filtered])
print("target_in_initial:", any(c.chunk_id == target_chunk for c in initial))
print("target_after_filter:", any(c.chunk_id == target_chunk for c in filtered))
预期输出
initial: [('doc-billing-02', 0.82), ('doc-sso-01', 0.79), ('doc-login-03', 0.77)]
filtered: ['doc-billing-02']
target_in_initial: True
target_after_filter: False
这组结果说明正确块已经进入向量初召回,因此不是“向量完全召不回来”;它在过滤后消失,根因应优先检查元数据条件,而不是提高 topK 或更换嵌入模型。
按目标内容第一次消失的位置判断根因
如果原始知识源中就找不到目标内容,先查同步任务、权限范围、解析失败和文档版本。此时调整检索参数没有意义,因为检索器无法召回一个根本没有入库的对象。
如果文档已经入库,但目标答案被切在错误位置,要检查 chunk 边界。典型现象是标题、条件和结论被拆开,单个 chunk 缺少能与问题对齐的完整语义。修复应优先调整按标题或段落切分、重叠窗口和表格解析。
如果目标 chunk 能进入未过滤的候选,却在过滤后消失,重点检查租户、产品线、语言、版本和权限条件。过滤器应记录“为什么被排除”,否则很容易把过滤过严误判成向量召回差。
如果目标 chunk 连较大的候选池都进不来,再看向量偏差。可比较失败问题与目标 chunk 的相似度、同义表达覆盖、embedding 模型是否适合当前语言和领域,以及 query 是否需要改写。
如果目标 chunk 初召回排名不错,但重排后大幅下降,则检查 reranker 输入是否被截断、query 与 passage 拼接是否正确,以及重排模型是否把“表面词匹配”当成更强相关性。重排层必须保存重排前后名次,不能只留最终结果。
不要用增大 topK 掩盖问题
增大 topK 只是在初召回阶段扩大候选池。它可能临时让正确文档“碰巧进入”,但也会增加重排成本、噪声和延迟。如果根因是未入库、错误过滤或重排误判,topK 再大也不能真正修复问题。
更稳妥的验证方式是建立一小组已知正确证据的失败问题,记录修复前后的 Recall@K、目标 chunk 初召回名次、过滤存活率和重排后名次。只要目标文档在某一层仍持续消失,就说明根因尚未消除。
用证据链验证修复
一次有效修复应该能回答三个问题:目标内容是否存在于索引中,是否进入足够靠前的初召回候选,是否能经过过滤和重排进入最终上下文。每次只改一个变量,再用同一批失败样本回放,才能知道改动真正改善的是哪一层。
当日志能保留“每层候选 + 分数 + 淘汰原因”时,漏召回和错误召回就不再是模糊的模型问题,而会变成可以定位到具体阶段的工程故障;这比无差别放大 topK 更可控,也更容易长期回归。