
大模型应用开发 / 系统课时
处理多跳与跨文档问题
处理多跳与跨文档问题
有些客服问题不能靠一个片段回答,例如“升级后是否还能退款,以及具体怎么申请”同时依赖产品状态、退款政策和操作流程。本篇把复杂问题拆成多个子查询,分别召回证据,再按文档身份与版本去重合并,避免单次检索只抓到其中一部分条件。
学习目标
- 识别需要两条及以上独立证据才能回答的多跳问题
- 把复杂问题拆成可单独检索、可验证的子查询
- 合并跨文档证据时保留来源、版本和约束,避免错误拼接
先判断是不是多跳问题
多跳问题的特征不是“句子长”,而是答案依赖多个事实之间的连接。例如“试用版升级企业版后能否退款,如何提交”至少需要确认三个事实:升级后的产品状态、企业版退款资格、退款申请流程。任何一个事实缺失,最终答案都可能看起来完整却实际上条件不成立。
可以把需要的证据拆成“实体状态、政策约束、流程动作”三类。若一个问题必须先确认 A,再依据 A 选择 B,最后根据 B 执行 C,它就已经具备明显的多跳结构,不适合只发起一次宽泛检索。
把复杂问题拆成子查询
子查询应尽量做到“一问一证据”,同时保留原问题里的主体、时间和版本条件。不要把“退款”三个字复制成三个相似查询,那只会重复召回同一批片段。
例如原问题“试用版升级企业版后,是否还能走退款通道,怎么提交?”可以拆成:
- 升级企业版后,账号适用哪一种产品状态与合同条件?
- 企业版在什么条件下具备退款资格?
- 符合退款条件后,申请入口和审批流程是什么?
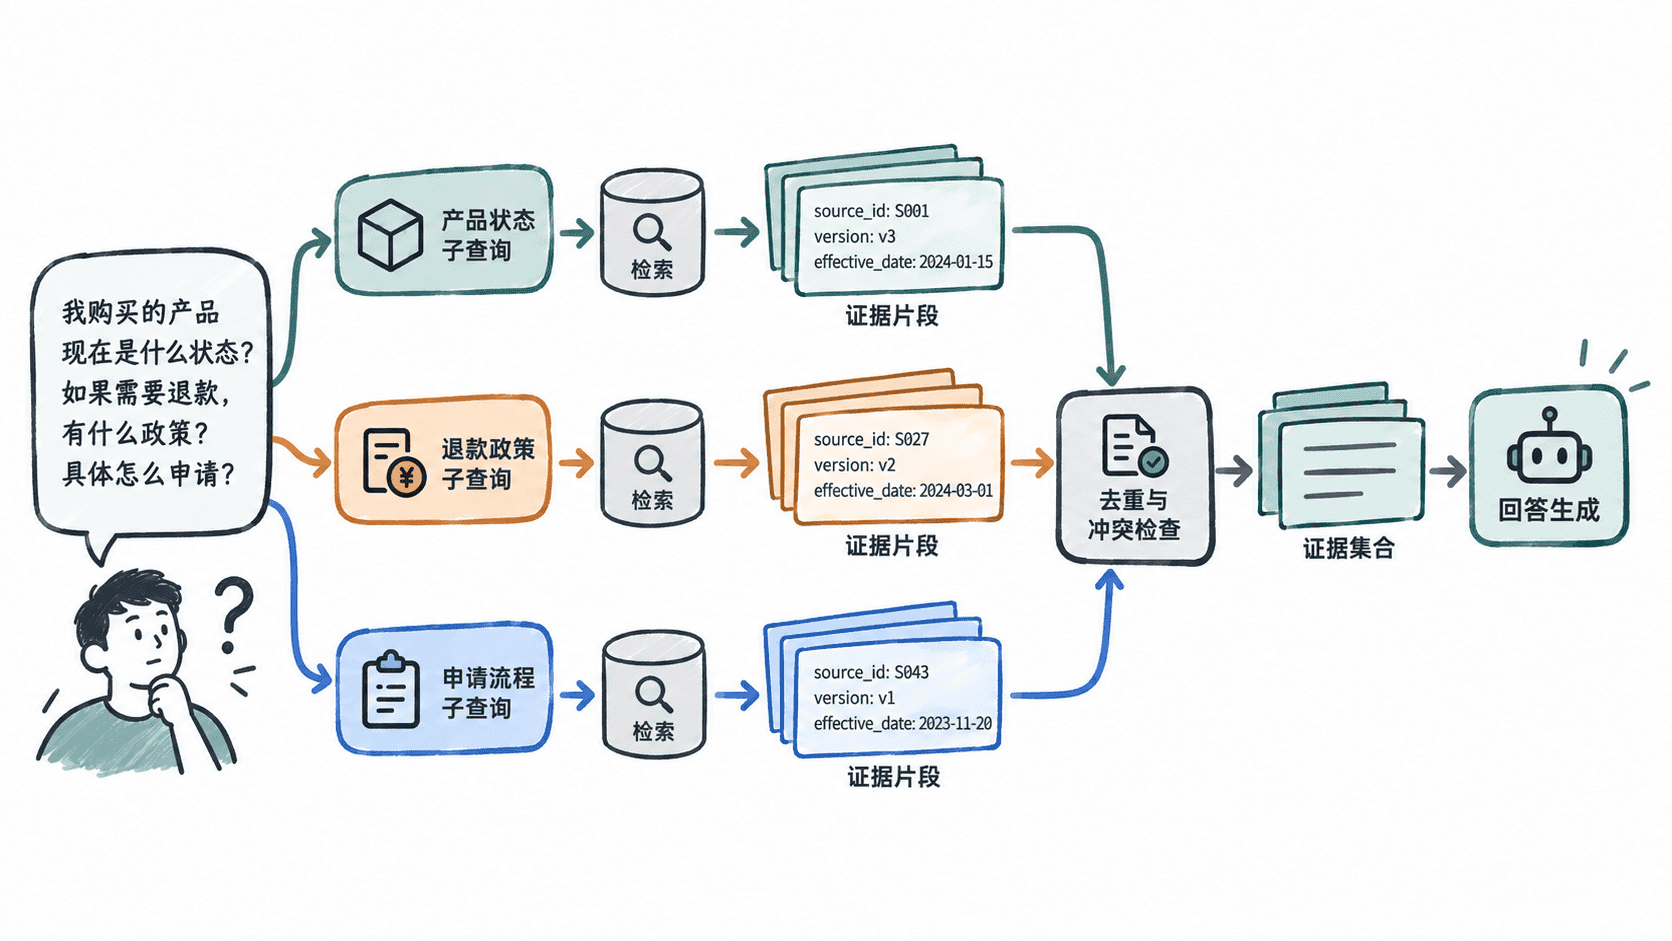
如果使用大模型自动拆解,最好让输出包含“子查询文本 + 目标证据类型”,而不是只返回字符串列表。这样检索层可以把政策查询路由到政策库,把操作查询路由到流程库,减少不同类型文档相互干扰。
合并证据时不要只做字符串去重
跨文档检索最容易出错的地方不是“没找到”,而是把来自不同版本、不同适用范围的片段拼成一个答案。合并时至少保留 source_id、文档版本、生效时间和适用产品;同一来源的重复切片可合并,不同来源但结论冲突的片段不能静默去重。
推荐先按文档 ID 与切片 ID 去掉完全重复,再按证据角色排序,例如产品条件、政策约束、操作步骤。生成答案之前再做一次冲突检查:如果两条政策对同一条件给出不同结论,应优先选择当前生效版本,无法判定时返回“需要人工确认”,而不是让生成模型自行猜测。
跑通一个最小多跳检索流程
下面用内存文档模拟三个知识域。为了让示例无需外部服务即可运行,子查询拆解结果预先给出,检索采用简单字符重合度;生产环境可把 retrieve 替换为向量检索或混合检索,后面的分支、合并与去重逻辑保持不变。
documents = [
    {
        "id": "product-upgrade",
        "type": "product",
        "text": "试用版一旦升级为企业版,账号状态按企业版合同执行。"
    },
    {
        "id": "policy-refund",
        "type": "policy",
        "text": "企业版在合同约定退款窗口内,并满足未超额使用等条件时可申请退款。"
    },
    {
        "id": "process-refund",
        "type": "process",
        "text": "符合条件后,在管理后台提交退款工单,并等待管理员审批。"
    },
]

subqueries = [
    {"route": "product", "text": "试用版升级企业版后采用什么账号状态"},
    {"route": "policy", "text": "企业版退款资格和限制条件"},
    {"route": "process", "text": "符合退款条件后如何提交申请"},
]

def retrieve(subquery, k=1):
    pool = [doc for doc in documents if doc["type"] == subquery["route"]]
    query_chars = set(subquery["text"])
    ranked = sorted(
        pool,
        key=lambda doc: len(query_chars & set(doc["text"])),
        reverse=True,
    )
    return ranked[:k]

merged = {}
for subquery in subqueries:
    for doc in retrieve(subquery):
        merged[doc["id"]] = doc

print(list(merged))
预期输出:
['product-upgrade', 'policy-refund', 'process-refund']这个结果说明三类证据都进入了最终集合。示例里的字符重合度只负责让流程可独立运行,真正上线时应替换成已有的向量、BM25 或混合检索,并对每个子查询继续执行重排。
验收跨文档答案是否完整
多跳检索不能只评估“最终答案像不像”,还要检查证据链是否闭合。最实用的做法是为测试问题预先标注必需证据集合,例如某题必须同时命中 product、policy 和 process 三类证据,再计算证据覆盖率与最终回答正确率。
一个可靠的多跳流程不是“多搜几次”,而是把复杂问题拆成可验证的小问题,让每条证据都带着明确来源和适用条件进入合并阶段。这样即使答案跨越多个文档,也能追溯每一步是如何得到的。