
大模型应用开发 / 系统课时
跑通第一条知识问答请求
跑通第一条知识问答请求
这一节只解决一个问题:把“问题进入系统”到“答案带证据返回”的链路完整跑通。我们用少量 FAQ 建立内存索引,完成召回、上下文组装、模型适配和响应封装,并用一次真实 HTTP 请求验收结果。
学习目标
- 说清最小 RAG 请求中检索、上下文、模型与响应之间的边界
- 用零依赖 Python 服务完成一次可复现的知识问答请求
- 通过答案、来源和
request_id判断端到端链路是否真正可用
先把闭环缩到五个边界
第一条请求不需要先上向量数据库、重排器或复杂 Agent。最小闭环只保留五个边界:知识索引保存可检索事实;检索器找出相关片段;上下文组装器把证据写进提示词;模型适配器根据上下文产出答案;接口层同时返回答案、证据和请求标识。
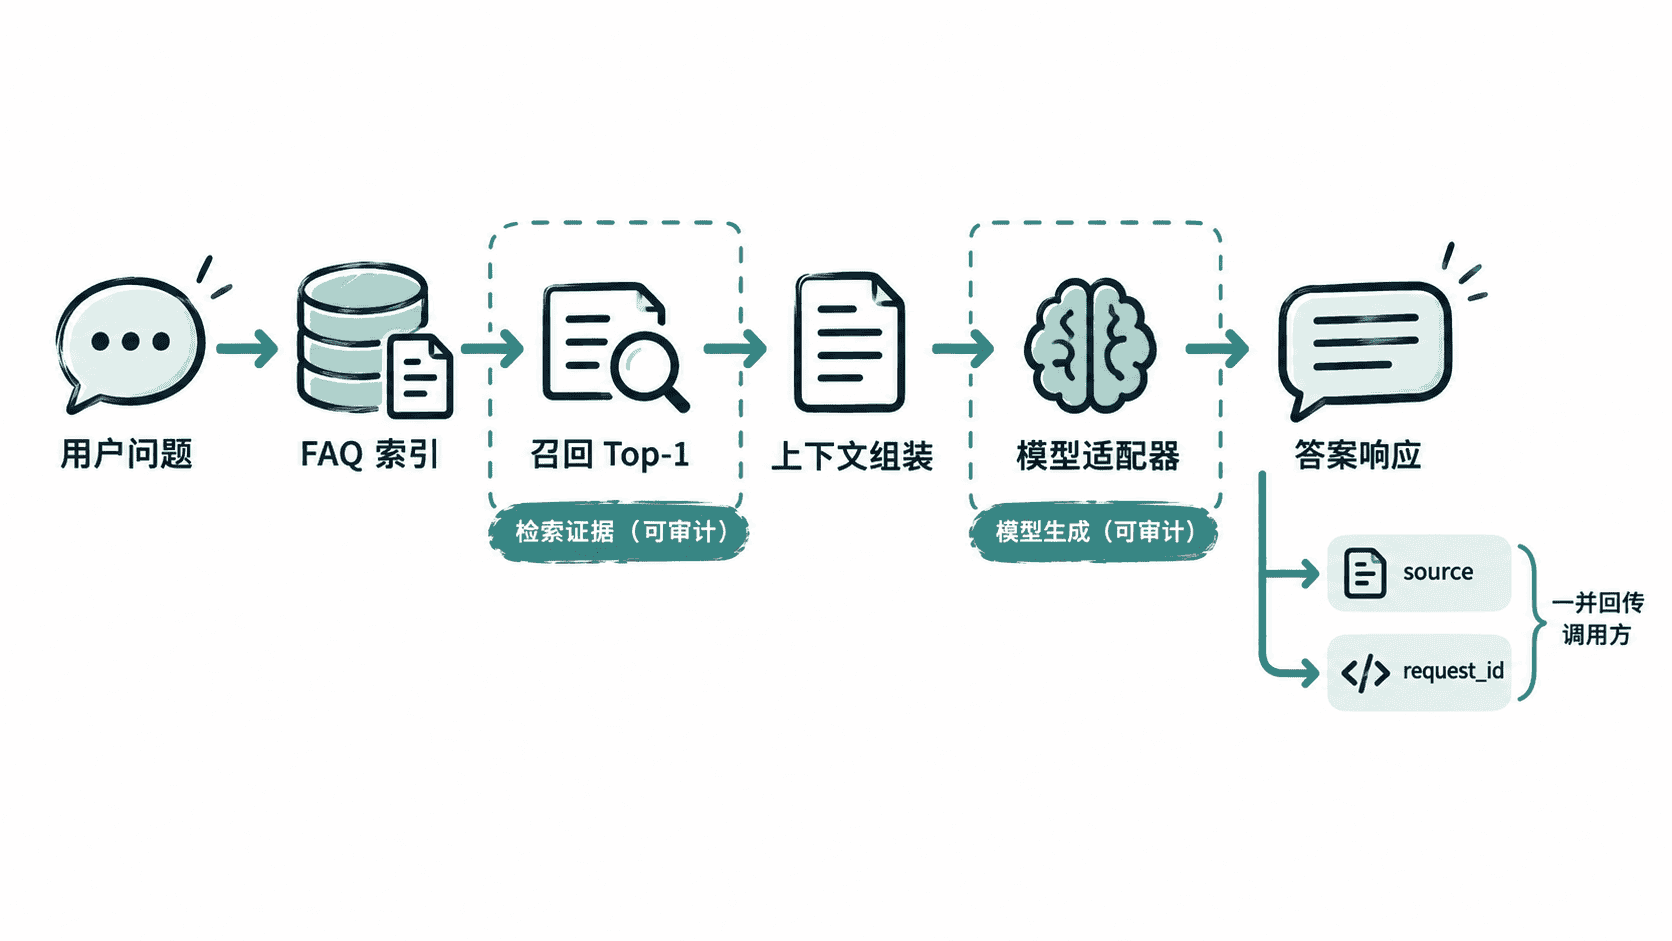
其中最容易被忽略的是“证据”和“答案”不能混成一个字段。答案可能来自模型生成,而来源必须由检索阶段确定;这样即使后续替换模型,也不会破坏溯源契约。
用一个零依赖服务跑通请求
下面的程序只依赖 Python 标准库。它把三条 FAQ 当作最小索引,用字符重合度完成 Top-1 召回,再把命中文档写入模型上下文。为了让示例在没有外部模型服务时也能稳定运行,generate_answer 是一个可替换的模型适配器:当前返回命中 FAQ 的答案,但已经接收完整 prompt,接入真实 LLM 时只替换这个函数即可。
import json
import uuid
from http.server import BaseHTTPRequestHandler, HTTPServer

FAQ = [
    {
        "id": "faq-001",
        "question": "如何重置密码?",
        "answer": "在登录页点击“忘记密码”,完成邮箱验证后设置新密码。",
        "source": "员工账号 FAQ",
    },
    {
        "id": "faq-002",
        "question": "报销多久到账?",
        "answer": "审批通过后通常 3 个工作日内到账。",
        "source": "财务 FAQ",
    },
    {
        "id": "faq-003",
        "question": "如何申请访客网络?",
        "answer": "由接待员工在访客系统提交申请后生成临时网络凭证。",
        "source": "网络使用 FAQ",
    },
]

def score(query: str, text: str) -> int:
    ignored = set("??,,。.!! ")
    q = {ch for ch in query if ch not in ignored}
    t = {ch for ch in text if ch not in ignored}
    return len(q & t)

def retrieve(query: str) -> dict:
    # 第一条链路先用可解释的简单召回,后续再替换成向量检索。
    hit = max(FAQ, key=lambda item: score(query, item["question"]))
    return {**hit, "score": score(query, hit["question"])}

def build_prompt(query: str, hit: dict) -> str:
    return (
        "仅根据给定企业知识回答;证据不足时说明无法确认。\n"
        f"来源:{hit['source']}\n"
        f"知识:{hit['answer']}\n"
        f"问题:{query}"
    )

def generate_answer(prompt: str, hit: dict) -> str:
    # 模型适配边界:真实部署时把这里替换成 LLM 调用,prompt 契约保持不变。
    if hit["score"] == 0:
        return "当前知识库没有足够信息回答这个问题。"
    return hit["answer"]

class Handler(BaseHTTPRequestHandler):
    def do_POST(self):
        if self.path != "/ask":
            self.send_error(404)
            return

        length = int(self.headers.get("Content-Length", "0"))
        payload = json.loads(self.rfile.read(length))
        question = str(payload.get("question", "")).strip()
        if not question:
            self.send_error(400, "question is required")
            return

        hit = retrieve(question)
        prompt = build_prompt(question, hit)
        result = {
            "request_id": str(uuid.uuid4()),
            "answer": generate_answer(prompt, hit),
            "source": {
                "document_id": hit["id"],
                "title": hit["source"],
                "score": hit["score"],
            },
        }

        body = json.dumps(result, ensure_ascii=False).encode("utf-8")
        self.send_response(200)
        self.send_header("Content-Type", "application/json; charset=utf-8")
        self.send_header("Content-Length", str(len(body)))
        self.end_headers()
        self.wfile.write(body)

    def log_message(self, *_):
        pass

if __name__ == "__main__":
    HTTPServer(("127.0.0.1", 8000), Handler).serve_forever()
把文件保存为 rag_demo.py 后,在一个终端后台启动服务并发送第一条请求:
python rag_demo.py &
PID=$!
sleep 1
curl -s -X POST http://127.0.0.1:8000/ask \
  -H 'Content-Type: application/json' \
  -d '{"question":"如何重置密码?"}'
kill "$PID"预期输出如下;request_id 每次请求都会变化,所以用 <ID> 表示。
{"request_id":"<ID>","answer":"在登录页点击“忘记密码”,完成邮箱验证后设置新密码。","source":{"document_id":"faq-001","title":"员工账号 FAQ","score":6}}看清上下文和模型边界
这条请求已经具备 RAG 最关键的三个可替换点。第一,retrieve 决定“拿什么证据”;以后换成向量库,只要仍返回文档标识、内容和分数即可。第二,build_prompt 决定“证据如何进入模型上下文”;这里应明确限制模型只能根据企业知识回答。第三,generate_answer 决定“由哪个模型生成”,它不负责伪造来源。
接口响应也应保持稳定。answer 给调用方直接展示;source.document_id 用来跳回原知识;source.score 便于排查召回;request_id 串起应用日志、检索日志和模型日志。不要把模型自己生成的“参考资料”文本当作真实来源。
验收第一条请求
判断链路是否跑通,不是只看有没有一句自然语言答案,而要同时检查四件事:
- 问题可以通过接口进入系统,并得到成功响应
- 召回结果确实指向预期 FAQ,而不是随机文档
- 返回答案与命中证据一致,没有超出证据内容
- 每次请求都有独立
request_id,并且响应中保留可追溯的文档标识
当这四项都成立时,最小闭环已经可验证。下一步无论替换成向量检索、真实大模型还是持久化日志,都应该尽量保持这几个接口边界不变。