
大模型应用开发 / 系统课时
排查召回正确却回答幻觉
排查召回正确却回答幻觉
当正确证据已经进入上下文,答案仍然给出错误结论时,问题通常已经离开“检索是否召回”这一层。此时要固定同一次请求的证据与提示词,依次检查证据顺序和冲突、系统约束、原始模型输出、解析器以及生成参数,用最小案例把错误锁定在生成链路的具体环节。
学习目标
- 区分“检索正确但生成错误”和“生成正确但解析后错误”。
- 检查证据顺序、冲突片段、系统约束与模型参数对结论的影响。
- 用最小可复现案例固定输入,验证修复是否真正消除幻觉。
先固定一次完整生成链路
第一步不是调温度,而是保存同一次请求真正送给模型的内容:系统指令、用户问题、证据片段及顺序、模型名称与参数、原始模型输出、解析后的最终答案。缺任何一段,都可能把后处理错误误判成模型幻觉。
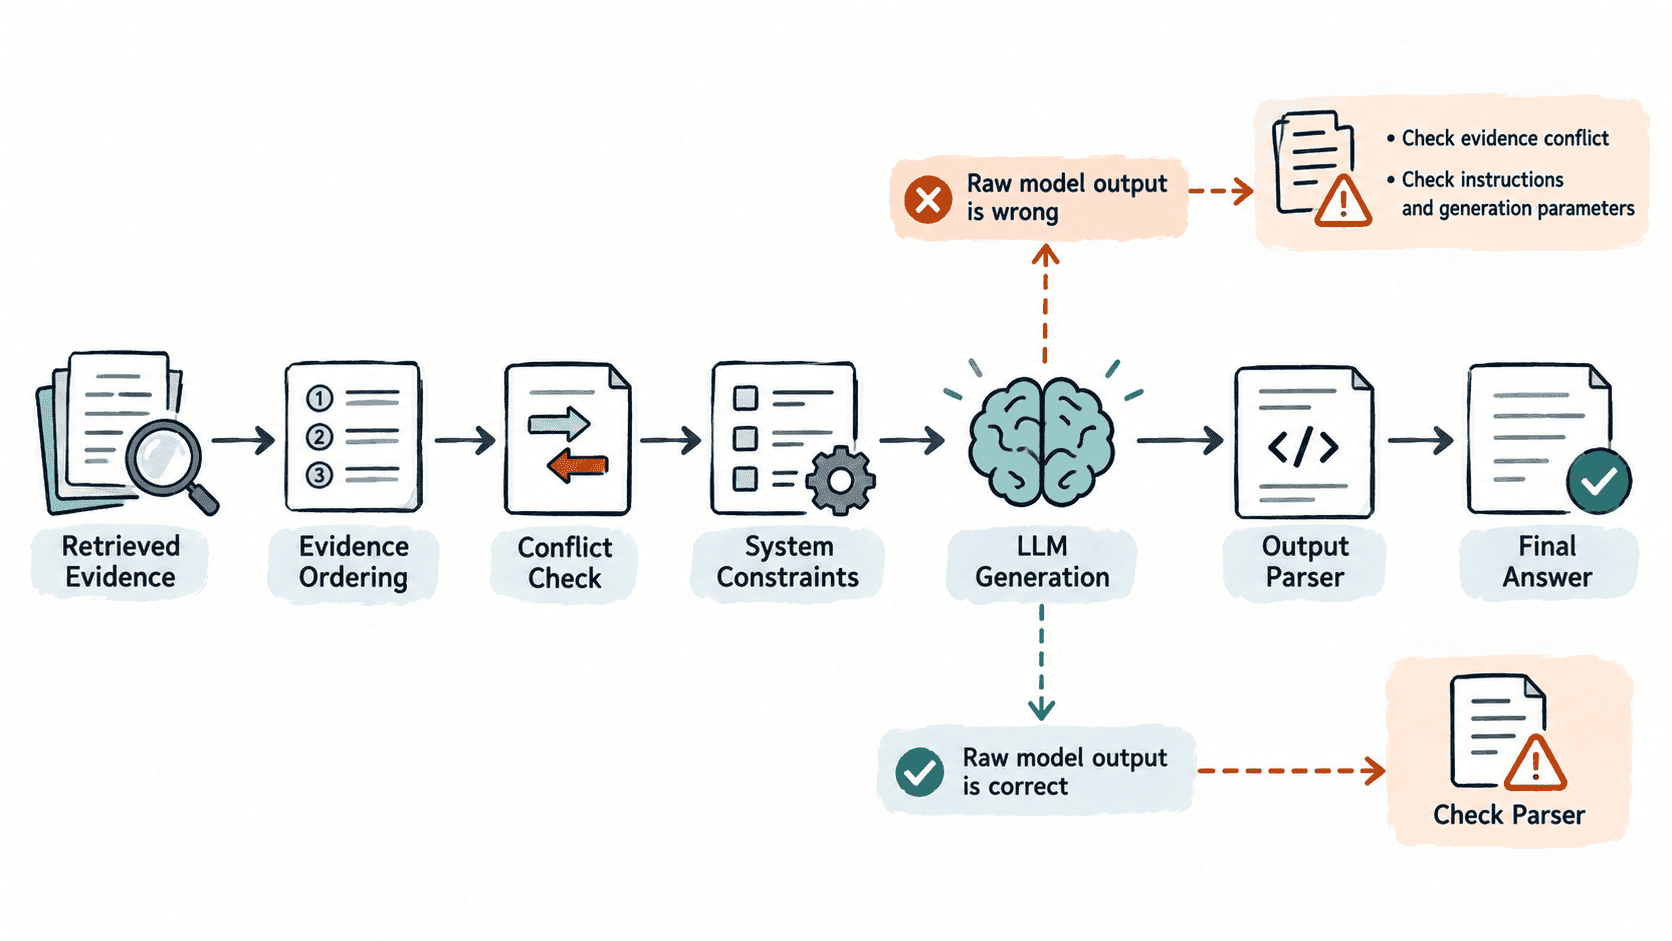
建议把这份快照作为故障样本保存下来。之后每次只改变一个变量,例如仅调换证据顺序,或仅把温度降到 0;如果同时改提示词、模型和解析器,即使答案恢复,也无法确认真正根因。
检查证据顺序与冲突片段
“召回正确”只说明目标片段出现了,不代表上下文没有更强的干扰信息。常见情况是旧版本片段排在新版本前面、多个文档对同一规则给出不同答案,或无关但措辞更强的片段占据靠前位置。先给每段证据记录文档 ID、版本、时间和排序分数,再确认最终拼接顺序。
如果存在冲突,系统约束应明确告诉模型如何裁决,例如优先使用最新生效版本、不得把低版本内容覆盖高版本内容,并要求答案只能依据给定证据。比“请准确回答”更有效的是可验证规则:缺少证据时明确返回“不确定”,有冲突时指出冲突并引用采用的版本。
分离模型输出和解析器
不少“幻觉”其实出现在模型之后。模型原始输出可能已经正确,但结构化解析、字段兜底或模板拼接把答案改坏。下面的可运行脚本用一个最小样本检查原始输出和解析结果是否一致。
raw_model_output = {
    'answer': '退款期限是 7 天',
    'citation': 'policy-v3',
}

parsed_output = {
    'answer': '退款期限是 30 天',
    'citation': 'policy-v3',
}

if raw_model_output['answer'] != parsed_output['answer']:
    print('fault_layer=output_parser')
else:
    print('fault_layer=generation')

print(f"raw={raw_model_output['answer']}")
print(f"final={parsed_output['answer']}")
预期输出
fault_layer=output_parser
raw=退款期限是 7 天
final=退款期限是 30 天
这个检查很简单,却能避免把解析器默认值、字段映射错误或二次模板覆盖误归因给模型。线上排查时应同时记录 raw output 和 final output;只记录最终答案,会丢失最关键的分界证据。
收紧系统约束与生成参数
如果原始模型输出本身就错,再检查提示词和生成参数。先把随机性降到最低以提高复现性,例如固定模型版本、温度设为 0,并关闭会引入额外候选随机性的设置。参数收紧不是最终修复,而是为了让同一输入尽可能稳定地产生同一错误,便于定位。
系统指令则要明确三件事:只能依据提供证据作答;证据不足时不得补全常识;冲突时按可解释规则选择版本。还可以要求每个关键结论附带证据 ID。若答案中的事实找不到对应证据 ID,就可以在生成后直接判为不合格,而不是把它送给用户。
用最小案例复现并验收
最小案例只保留一个用户问题、两到三个必要证据片段、一份系统指令和固定模型参数。先确认错误可以稳定复现,再按单变量方式修改:调整证据顺序、删除冲突片段、加强系统约束、修复解析器。每次都保存 raw output 和 final output,避免凭肉眼判断。
验收时至少覆盖三类输入:证据充分且唯一、证据相互冲突、证据不足。合格结果应分别表现为正确回答、按规则处理冲突、明确拒绝无依据补全。只有这三类都稳定通过,才能说明问题从“偶然答对”变成了可控制的生成行为。