
大模型应用开发 / 系统课时
改写含糊问题补齐检索意图
改写含糊问题补齐检索意图
多轮客服对话里,用户常说“这个多久能退”“那海外也可以吗”,单独拿去检索几乎没有足够信息。本节把会话上下文压缩成可独立检索的查询,同时保留用户原问题作为最终回答依据,避免查询改写替用户补出并不存在的意图。
学习目标
- 识别代词、省略和上下文依赖导致的检索信息缺失
- 将当前问题改写成可独立理解的检索查询
- 分离“用于检索的改写问题”和“用于回答的原始问题”,控制改写偏移
检索查询和用户问题不是同一个对象
假设上一轮用户问“企业版退款周期是多少”,系统回答后,用户继续问“海外订单呢”。直接检索“海外订单呢”时,召回系统不知道用户仍在询问退款周期;但如果直接把原问题替换成“海外企业版订单退款周期是多少”,又可能在后续生成回答时丢失用户真实措辞和会话关系。
更稳妥的做法是同时保留两份文本:original_question 原样进入回答阶段,retrieval_query 只服务于检索。改写器的任务是补齐明确存在于上下文中的实体、约束和主题,而不是猜测新的业务条件。
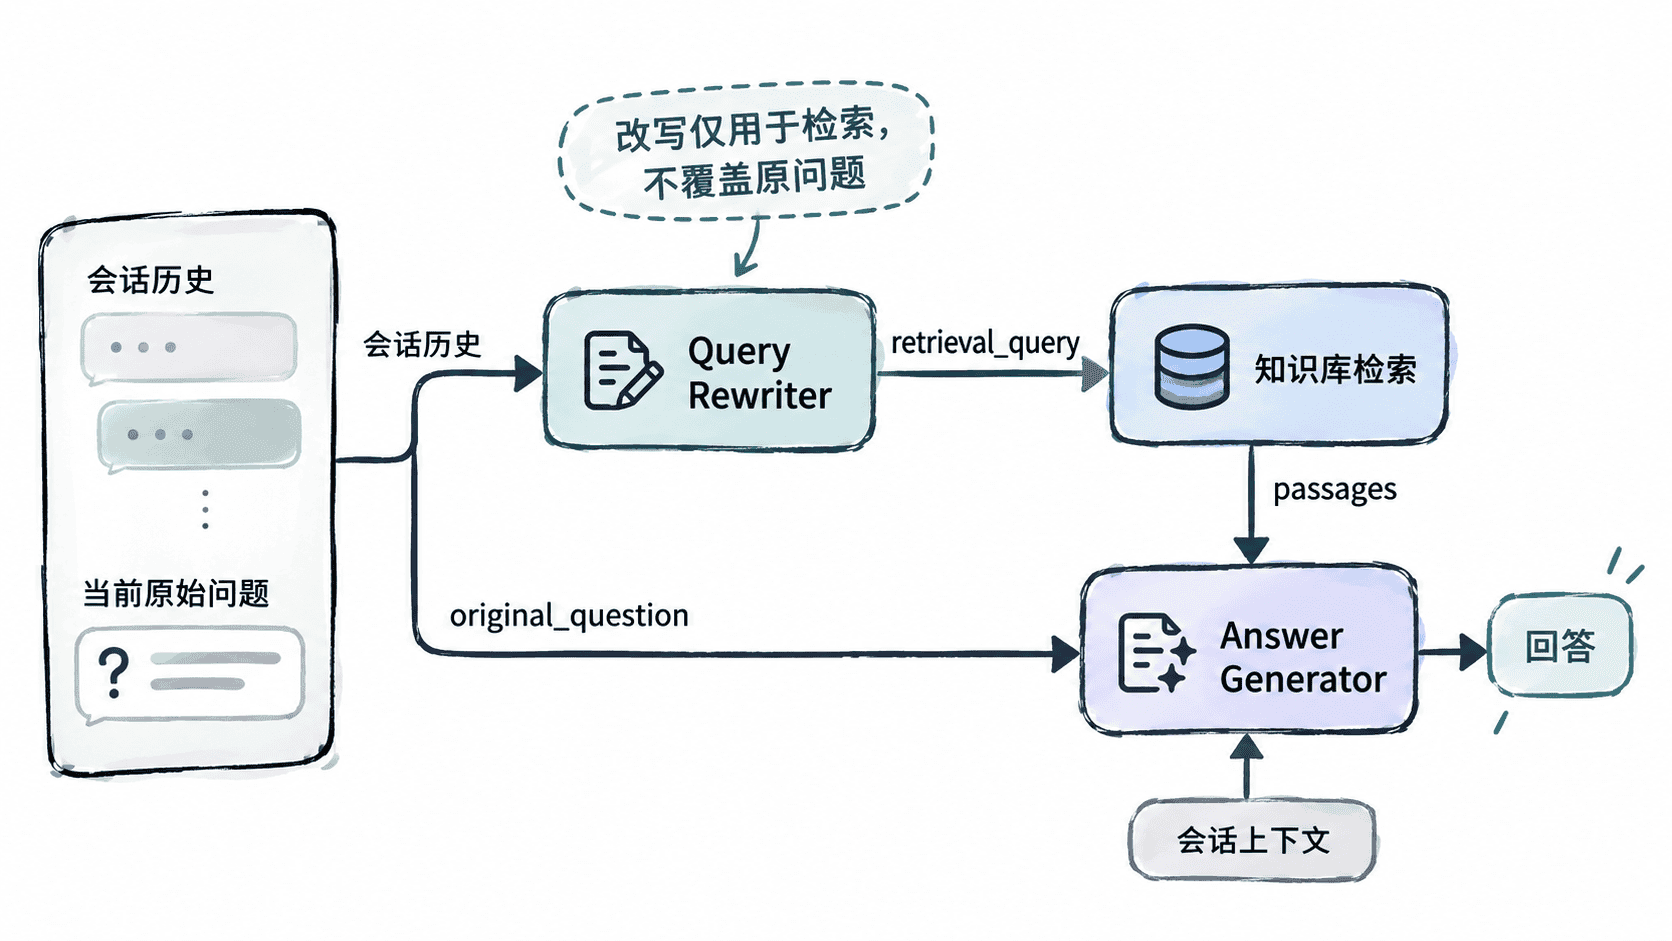
只补上下文里已有的信息
改写通常处理三类缺失:代词指代,例如“它支持吗”;主题省略,例如“多久能到账”;口语缩略,例如“海外呢”。补齐时应优先复制上下文中已经确认的信息,不主动增加用户没有表达的产品型号、地区、时间范围或问题类型。
下面用一个最小 Python 示例演示这种边界。示例不是通用自然语言理解器,而是展示改写接口应如何同时返回原问题和检索问题,以及为什么两者必须分离。
from dataclasses import dataclass

@dataclass
class RewriteResult:
    original_question: str
    retrieval_query: str


def rewrite_query(previous_topic: str, question: str) -> RewriteResult:
    normalized = question.strip()

    # 只补充已由上一轮明确确认的主题,不猜测额外业务条件。
    if normalized == "海外订单呢?":
        retrieval_query = f"海外订单的{previous_topic}"
    else:
        retrieval_query = normalized

    return RewriteResult(
        original_question=question,
        retrieval_query=retrieval_query,
    )


result = rewrite_query("企业版退款周期是多少", "海外订单呢?")
print(result.original_question)
print(result.retrieval_query)
预期输出:
海外订单呢?
海外订单的企业版退款周期是多少
这里的 retrieval_query 已经可以独立送入向量检索或关键词检索,而 original_question 没有被覆盖。生产环境通常会由语言模型执行改写,但接口仍建议保留这两个字段,并为改写结果设置长度、语言和内容边界。
给模型明确的改写约束
如果使用大模型改写查询,提示词应明确要求“补齐而不回答”。输入至少包括最近几轮与当前主题相关的会话和当前问题,输出只包含一条独立查询。不要把完整长会话无差别塞给改写器,否则早期话题容易污染当前意图。
改写结果还应经过基本校验:不得凭空出现上下文和当前问题都没有的订单号、产品名或故障原因;不得把疑问句改成结论;用户已经给出完整问题时应尽量保持原样。对于“帮我比较这两个方案”这类必须依赖多个对象的问题,如果上下文不足以唯一确定对象,应保留歧义,而不是自行猜测。
验证改写是否真的提高召回
评估不能只看改写文本是否通顺,而要比较检索结果。准备一组真实多轮问题,分别用原问题和改写问题执行检索,观察目标文档是否进入 Top K、排名是否提高,以及错误文档是否增多。
重点覆盖三类测试:必须改写才能找到答案的问题、原问题本来就完整的问题、上下文存在多个候选指代的问题。第一类应提高召回,第二类不应被过度改写,第三类宁可保留不确定性,也不要稳定地产生错误实体。
查询改写的价值在于为检索补齐必要上下文,而不是重新解释用户。让 retrieval_query 专注提高召回,让 original_question 始终保留到回答阶段,就能在提升检索命中率的同时,把“改写过度导致答非所问”的风险控制在可观察、可测试的范围内。