
大模型应用开发 / 系统课时
控制上下文长度与证据排序
控制上下文长度与证据排序
本节解决一个常见反直觉问题:检索结果越多,答案不一定越可靠。你将把相关性、来源权威度、更新时间和证据多样性合并到选择流程中,并在固定 token 预算内完成去重、排序与裁剪。
学习目标
- 为检索片段设计兼顾相关性、权威度和新鲜度的排序信号。
- 在 token 预算内执行去重、来源多样化和证据裁剪。
- 用可复现的选择结果验证上下文没有被低价值片段挤占。
先把 token 预算变成硬约束
模型的上下文窗口不是“证据可用空间”。系统提示、用户问题、工具结果、引用格式和预留回答都要占 token,因此应先计算证据预算,再做排序。生产中通常把回答预留量设为硬下限,避免证据塞满窗口后模型没有足够空间组织答案。
可以把可用证据预算理解为:模型窗口减去固定提示、当前问题、输出预留和少量格式开销。预算确定后,任何候选片段都必须经过选择器,而不是简单取检索 Top-K 后全部拼接。
用四类信号选证据
相关性回答“它是否在讲当前问题”,应当占主要权重;来源权威度回答“这个来源是否值得相信”;更新时间用于降低已过期政策或旧手册的优先级;多样性则防止多个高分片段都来自同一页面,导致上下文重复而缺少互补证据。
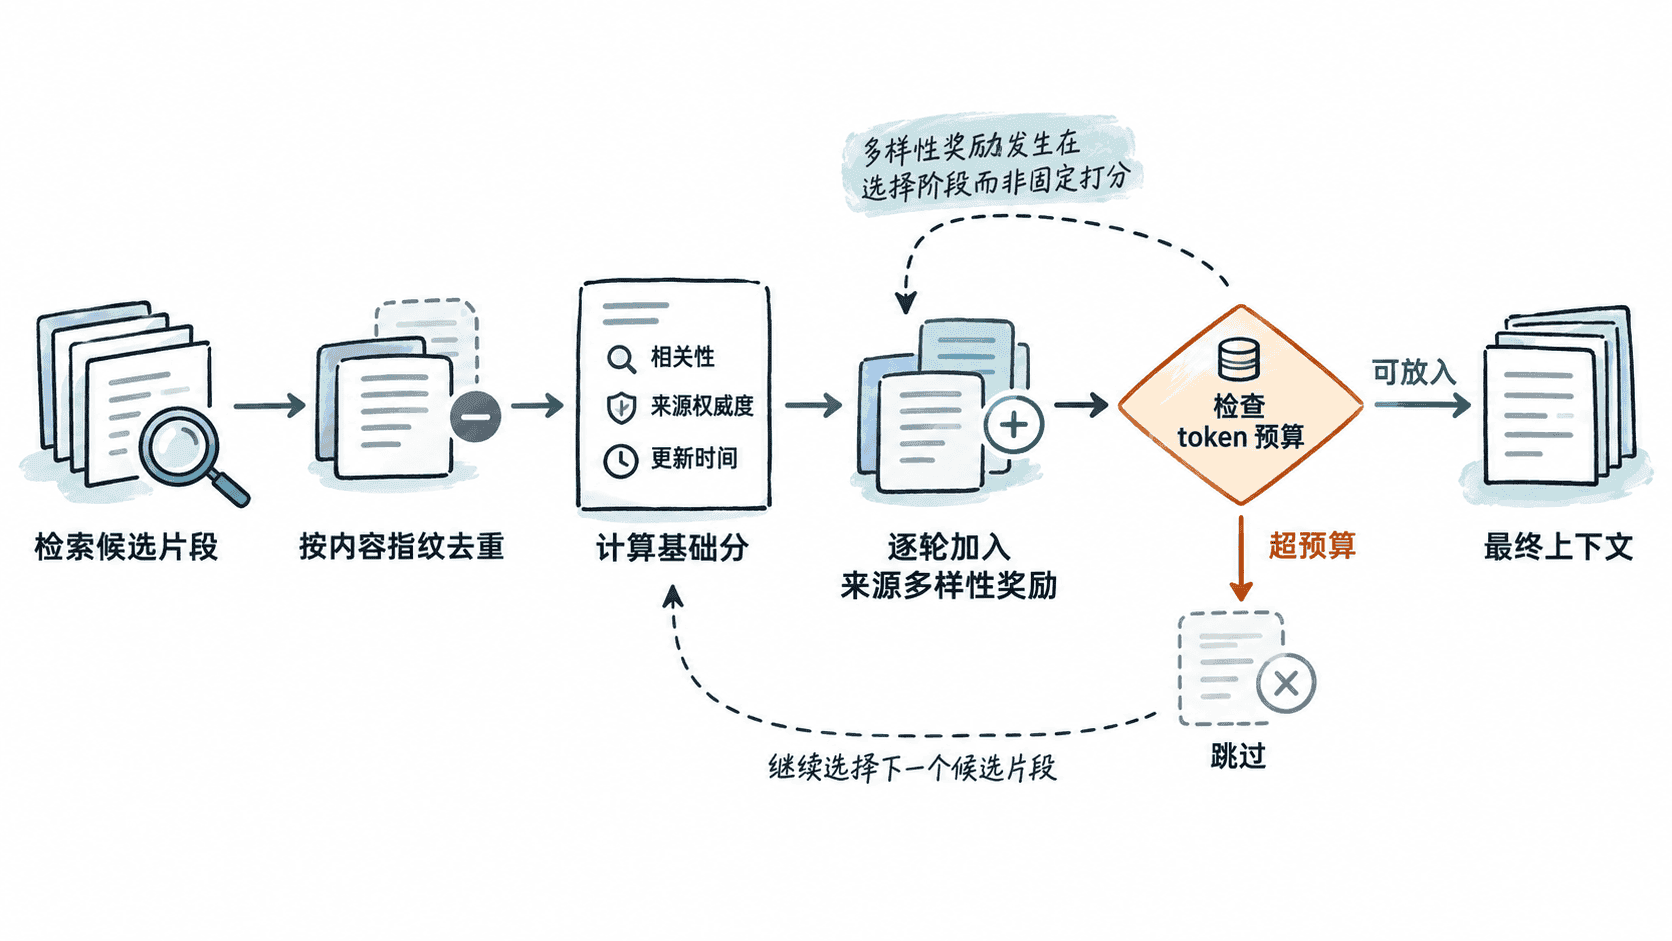
多样性不适合在检索阶段简单给每条记录固定加分。更稳妥的方法是先按基础分排序,再在逐条选入上下文时,对尚未出现的来源给予小幅奖励。这样既保留高相关证据,又能在分数接近时优先覆盖不同来源。
实现一个可运行的选择器
下面的示例先按 dedup_key 去重,再计算基础分;每轮选择时,未出现过的来源获得小幅多样性奖励。若当前候选放不进剩余预算,就尝试下一条,而不是立刻结束。
from dataclasses import dataclass

@dataclass(frozen=True)
class Evidence:
    id: str
    source: str
    relevance: float
    authority: float
    age_days: int
    tokens: int
    dedup_key: str

def base_score(e: Evidence) -> float:
    freshness = max(0.0, 1.0 - e.age_days / 365)
    return 0.55 * e.relevance + 0.25 * e.authority + 0.20 * freshness

def select_evidence(candidates: list[Evidence], budget: int) -> tuple[list[Evidence], int]:
    unique = []
    seen_keys = set()
    for e in candidates:
        if e.dedup_key in seen_keys:
            continue
        seen_keys.add(e.dedup_key)
        unique.append(e)

    selected = []
    used = 0
    seen_sources = set()
    remaining = unique[:]

    while remaining:
        # 分数接近时,优先补充尚未进入上下文的来源。
        remaining.sort(
            key=lambda e: base_score(e) + (0.05 if e.source not in seen_sources else 0.0),
            reverse=True,
        )
        chosen = next((e for e in remaining if used + e.tokens <= budget), None)
        if chosen is None:
            break
        selected.append(chosen)
        used += chosen.tokens
        seen_sources.add(chosen.source)
        remaining.remove(chosen)

    return selected, used

candidates = [
    Evidence("p1", "handbook", 0.95, 0.95, 10, 650, "refund-policy"),
    Evidence("p2", "kb", 0.91, 0.90, 30, 520, "refund-exception"),
    Evidence("p3", "mirror", 0.93, 0.70, 12, 610, "refund-policy"),
    Evidence("p4", "handbook", 0.88, 0.85, 3, 480, "refund-sla"),
    Evidence("p5", "faq", 0.86, 0.80, 1, 420, "refund-channel"),
]

budget = 1600
selected, used = select_evidence(candidates, budget)
print("selected=" + ",".join(e.id for e in selected))
print(f"tokens={used}/{budget}")
预期输出
selected=p1,p2,p5
tokens=1590/1600
p3 因为与 p1 的 dedup_key 相同被去重;p4 虽然基础分较高,但在前两条证据选入后会超过剩余预算,而来自新来源的 p5 可以放入,因此最终上下文同时满足去重、多样性和预算约束。
验证与生产边界
上线前不要只看“是否小于最大上下文”。更有价值的是记录每次请求的候选数、去重后数量、最终证据数、证据 token、各来源占比以及被丢弃原因。若大量高相关证据总因预算被截掉,应优先调整切块大小或压缩片段,而不是盲目扩大窗口。
排序权重也不应永久写死。客服政策类知识通常更看重权威来源与新鲜度,产品 FAQ 可能更看重语义相关性。无论怎样调权重,都应保留一个原则:先确定回答预算,再让有限的证据空间承载尽可能少的重复和尽可能高的可信信息。