
大模型应用开发 / 系统课时
对比切分召回与重排参数
对比切分召回与重排参数
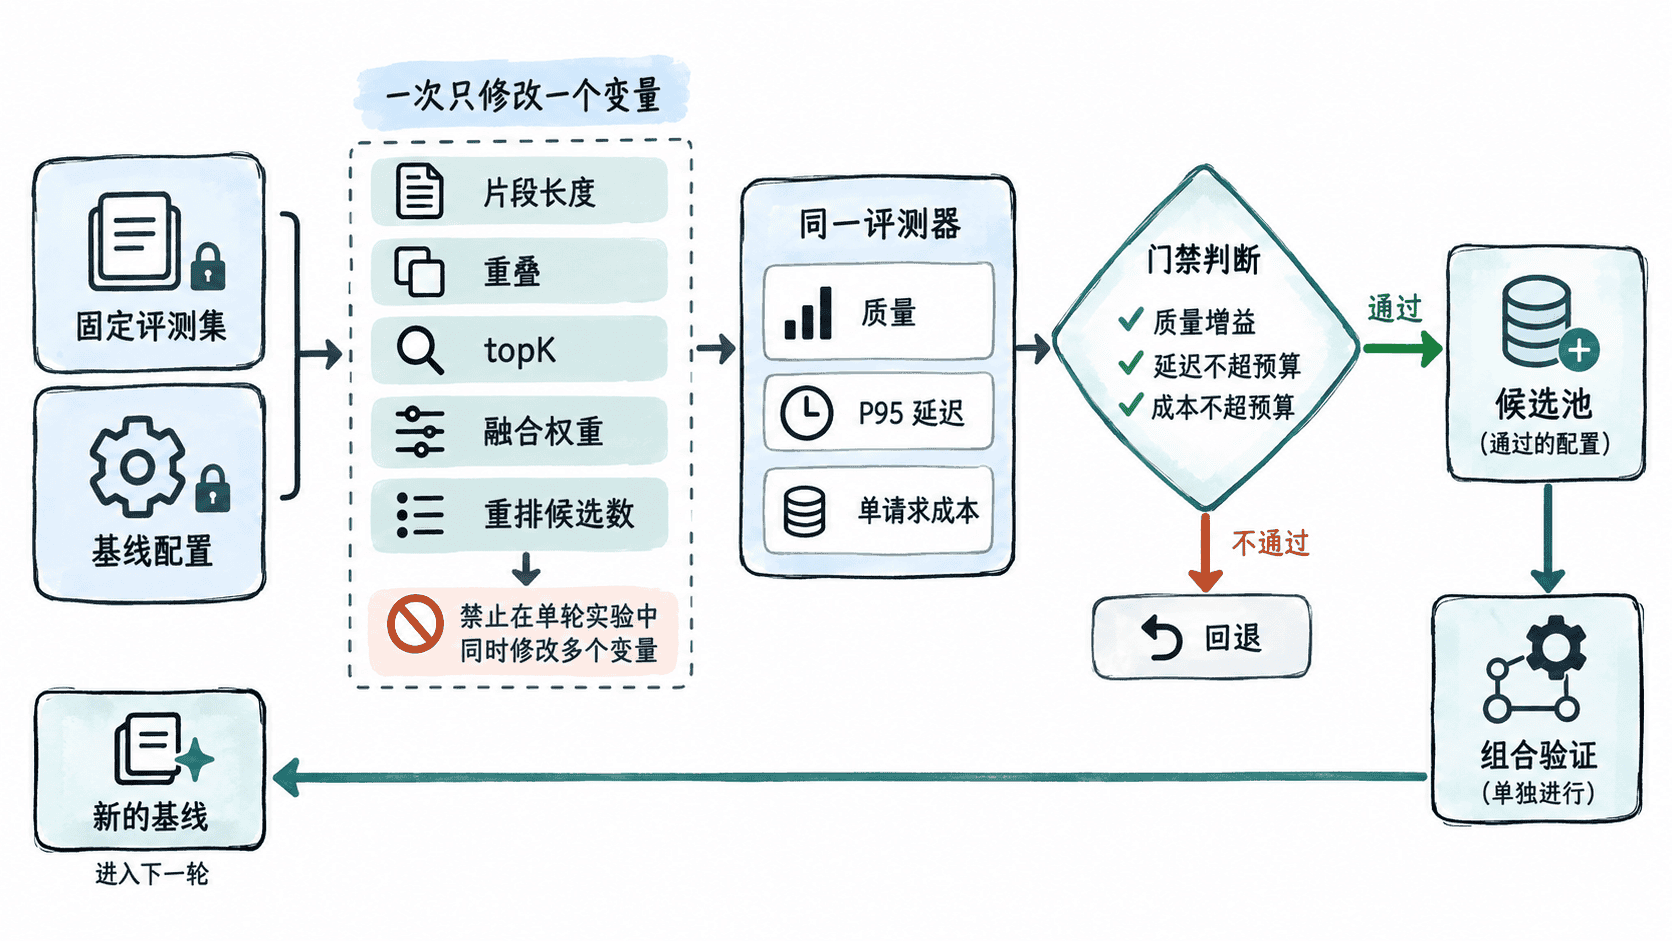
RAG 参数调优最容易犯的错误,是一次同时改片段长度、重叠、topK、融合权重和重排候选数,结果质量变了却无法知道原因。这一节用固定评测集和单变量实验,把质量、延迟与成本放在同一张记录里,再决定哪些改动值得进入下一轮组合验证。
学习目标
- 用固定评测集和固定基线执行单变量对照实验
- 比较片段长度、重叠、topK、融合权重和重排候选数对质量、延迟与成本的影响
- 用增量指标和约束条件筛选候选配置,避免把偶然提升误判为有效优化
先冻结评测集和基线
开始调参前先固定四样东西:评测问题集合、知识库版本、生成模型版本和评测方法。任何一个在实验中变化,都会引入新的混杂变量。基线配置也要完整记录,例如 chunk_size=600、overlap=100、topK=5、融合权重 0.5、重排候选数 20。
每一轮只修改一个参数,其余配置与基线保持不变。片段长度和重叠主要改变索引中的证据边界;topK 影响召回覆盖和下游上下文规模;融合权重改变稀疏检索与向量检索的相对贡献;重排候选数则直接影响重排阶段的算力和延迟。它们的作用位置不同,因此不能把“参数值更大”简单理解成“效果更好”。
记录三类结果而不是只看质量分
每次实验至少保留质量、延迟和成本三组数据。质量可以是命中率、上下文相关性、端到端答案得分等固定指标;延迟至少记录同口径的 P50 或 P95;成本则记录每请求 token、重排调用量或折算后的单请求费用。
| 实验 | 唯一改动 | 质量分 | P95 延迟 | 单请求成本 |
|---|---|---|---|---|
| baseline | 无 | 0.78 | 420 ms | 0.012 |
| chunk-800 | chunk_size=800 | 0.81 | 435 ms | 0.0125 |
| overlap-160 | overlap=160 | 0.80 | 442 ms | 0.0130 |
| topk-8 | topK=8 | 0.83 | 490 ms | 0.0150 |
| fusion-0.7 | fusion_weight=0.7 | 0.82 | 425 ms | 0.0120 |
| rerank-30 | rerank_candidates=30 | 0.84 | 520 ms | 0.0180 |
表中的值只是演示如何记录,不代表通用最优参数。真正有意义的是同一评测集、同一统计口径下的相对变化。
按单变量增量筛选候选配置
下面的脚本把每个实验与同一个基线比较,并同时检查质量提升、延迟上限和成本上限。这样可以避免“质量涨了 1 分,但延迟翻倍”的配置被误判为优化。
baseline = {"quality": 0.78, "p95_ms": 420, "cost": 0.012}

experiments = [
    ("chunk_size=800", 0.81, 435, 0.0125),
    ("overlap=160", 0.80, 442, 0.0130),
    ("topK=8", 0.83, 490, 0.0150),
    ("fusion_weight=0.7", 0.82, 425, 0.0120),
    ("rerank_candidates=30", 0.84, 520, 0.0180),
]

for name, quality, p95_ms, cost in experiments:
    quality_gain = quality - baseline["quality"]
    latency_ok = p95_ms <= baseline["p95_ms"] * 1.20
    cost_ok = cost <= baseline["cost"] * 1.25
    accepted = quality_gain >= 0.02 and latency_ok and cost_ok
    print(
        f"{name:24} "
        f"gain={quality_gain:+.2f} "
        f"p95={p95_ms}ms "
        f"cost={cost:.4f} "
        f"{'ACCEPT' if accepted else 'REJECT'}"
    )
预期输出
chunk_size=800           gain=+0.03 p95=435ms cost=0.0125 ACCEPT
overlap=160              gain=+0.02 p95=442ms cost=0.0130 ACCEPT
topK=8                   gain=+0.05 p95=490ms cost=0.0150 ACCEPT
fusion_weight=0.7        gain=+0.04 p95=425ms cost=0.0120 ACCEPT
rerank_candidates=30     gain=+0.06 p95=520ms cost=0.0180 REJECT
阈值要根据业务设定。在线客服通常对尾延迟敏感,可以先设定最大 P95,再在满足时延约束的配置里比较质量;离线辅助场景则可能允许更高延迟来换取更好的答案。
组合验证要另开一轮
单变量实验只能告诉你“这个参数单独变化时发生了什么”,不能证明多个优选值叠加后仍然有效。比如更大的 topK 与更大的重排候选数同时启用,可能让质量继续上升,也可能因为噪声候选增加而降低重排稳定性。
因此,先从单变量实验中挑出满足约束的少量候选,再创建一个新的组合实验,并把它当作独立配置重新跑完整评测集。只有组合结果稳定优于旧基线,才更新基线并进入下一轮。这样每一次提升都有清楚的来源,回归时也能快速定位是哪一个参数或哪一组交互造成变化。