
大模型应用开发 / 系统课时
用超时重试限流保护依赖
用超时重试限流保护依赖
这一节把客服链路里的检索、重排、模型和工具调用包进统一保护层:每次调用都有超时,只有安全操作才有限重试,同时限制并发并在连续失败时熔断,让单个依赖变慢时系统仍能快速降级,而不是排队雪崩。
学习目标
- 为不同依赖设置超时、有限重试和并发上限
- 用熔断与降级阻止慢依赖持续占用资源
- 区分可重试读操作与可能重复执行的写操作
先按副作用给依赖分组
保护策略的第一步不是“统一重试三次”,而是判断调用有没有副作用。检索、查询模型状态这类只读请求通常可以在超时或临时网络错误后重试;创建工单、扣减额度、发送消息等写操作如果没有幂等保证,重试可能产生重复结果。
超时也应按依赖分别设置。检索通常需要更短的预算,模型生成可以更长,工具调用则取决于下游 SLA。单个依赖的超时必须小于整条客服请求的剩余预算,否则上游已经放弃,下游仍会继续消耗资源。
请求进入依赖前的保护顺序
一次外部调用可以按“并发门控 → 熔断检查 → 单次超时 → 是否重试 → 降级”的顺序处理。重试必须共享同一份总预算,不能每次失败后重新获得完整超时时间。
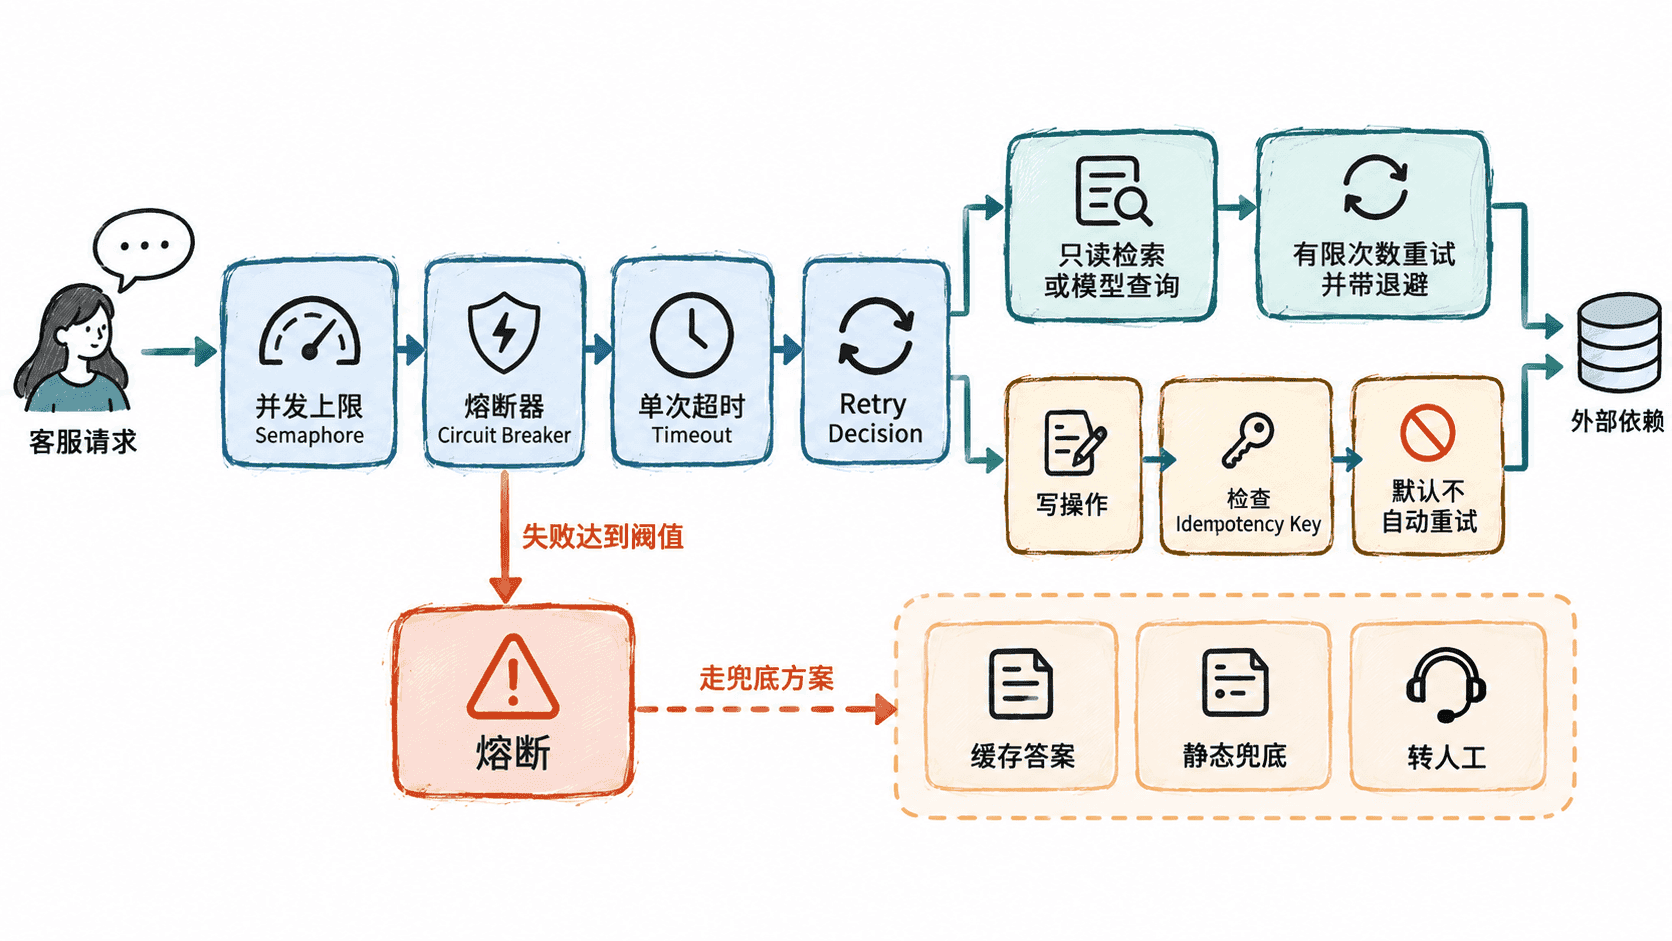
熔断器解决的是“明知依赖已经坏了,还不断发请求”的问题。连续失败达到阈值后,在一段时间内直接失败并执行降级;恢复窗口结束后再允许少量探测请求。并发上限解决的是“依赖变慢导致在途请求越来越多”的问题,两者职责不同,通常要同时存在。
实现一个最小保护器
下面的 Python 3.11 示例同时包含并发上限、单次超时、有限重试和熔断。搜索调用前两次故意超时,第三次成功;写操作即使传入重试次数,也因为 retry_safe=False 只执行一次。重复写入由幂等键识别,而不是依赖客户端盲目重试。
import asyncio
import time

class DependencyGuard:
    def __init__(self, max_concurrency=2, failure_threshold=3, open_seconds=1.0):
        self.semaphore = asyncio.Semaphore(max_concurrency)
        self.failure_threshold = failure_threshold
        self.open_seconds = open_seconds
        self.failures = 0
        self.open_until = 0.0

    async def call(self, name, operation, *, timeout_s, retries, retry_safe):
        async with self.semaphore:
            if time.monotonic() < self.open_until:
                raise RuntimeError(f"{name} circuit open")

            max_attempts = 1 + retries if retry_safe else 1
            for attempt in range(1, max_attempts + 1):
                try:
                    result = await asyncio.wait_for(operation(), timeout=timeout_s)
                    self.failures = 0
                    return result
                except (TimeoutError, OSError):
                    self.failures += 1
                    print(f"{name} attempt={attempt} failed")
                    if self.failures >= self.failure_threshold:
                        self.open_until = time.monotonic() + self.open_seconds
                    if attempt == max_attempts or time.monotonic() < self.open_until:
                        raise
                    await asyncio.sleep(0.01 * attempt)

async def main():
    guard = DependencyGuard()
    search_attempts = 0
    created = set()

    async def search():
        nonlocal search_attempts
        search_attempts += 1
        if search_attempts <= 2:
            await asyncio.sleep(0.08)
        return "docs=3"

    async def create_ticket(idempotency_key):
        if idempotency_key in created:
            return "deduplicated"
        created.add(idempotency_key)
        return "created"

    result = await guard.call(
        "search", search, timeout_s=0.05, retries=2, retry_safe=True
    )
    print(result)

    first = await guard.call(
        "ticket",
        lambda: create_ticket("req-42"),
        timeout_s=0.05,
        retries=2,
        retry_safe=False,
    )
    second = await guard.call(
        "ticket",
        lambda: create_ticket("req-42"),
        timeout_s=0.05,
        retries=2,
        retry_safe=False,
    )
    print(first)
    print(second)

asyncio.run(main())
预期输出
search attempt=1 failed
search attempt=2 failed
docs=3
created
deduplicated
这里的时间值只是演示。生产环境应从各依赖的延迟分位数和端到端 SLA 反推预算,并把超时、重试次数、并发上限和熔断阈值放进可热更新配置,而不是散落在业务代码里。
写操作的重试边界
写操作只有在“服务端能可靠去重”时才适合自动重试,例如下游接受 Idempotency-Key,并把同一个键绑定到唯一业务结果。仅仅在客户端生成 UUID 并不等于幂等;下游必须持久化这个键,并在重复请求时返回原结果。
如果下游不支持幂等,超时后的真实状态可能是“请求已成功,但响应丢了”。此时再次提交会重复写入,正确做法通常是查询业务状态、进入补偿流程或转人工,而不是无限重试。
生产参数要形成一套预算
可以把每类依赖的保护参数整理成小表,并通过压测持续校准。关键不是追求某个固定数值,而是保证“单次超时 × 最大尝试次数 + 退避时间”不会突破调用方剩余的总时限。
| 依赖类型 | 超时重点 | 重试策略 | 并发与降级 |
|---|---|---|---|
| 检索/重排 | 较短,优先保护首字延迟 | 仅临时错误有限重试 | 达上限后用缓存或缩小召回 |
| 模型生成 | 受模型与输出长度影响 | 连接类错误可重试,生成中断需谨慎 | 限制在途生成数,必要时切小模型 |
| 工具读操作 | 按下游 SLA 设置 | 只读请求可有限重试 | 熔断后跳过非关键工具 |
| 工具写操作 | 保留状态确认空间 | 无幂等保证时不自动重试 | 失败进入查询、补偿或人工处理 |
当依赖开始变慢时,系统应该先减少进入下游的请求,再尽快失败并降级;而不是依靠更多重试“把成功率顶上去”。这样才能把局部故障限制在依赖边界内,避免客服主链路被拖成全局雪崩。