
大模型应用开发 / 系统课时
设计租户与文档访问隔离
设计租户与文档访问隔离
企业客服最危险的错误不是答错一句话,而是把别的租户、别的角色或无权访问的知识检索出来。本节建立用户、租户、角色与知识空间的服务端授权链,并把同一套校验延伸到检索、引用、工具调用和日志查询,避免任何一处绕过权限。
学习目标
- 建立用户、租户、角色和知识空间之间的最小授权模型
- 在检索与引用阶段强制执行服务端过滤,避免跨租户召回
- 让工具调用和审计日志继续复用同一套租户边界,而不是只保护向量库
把权限边界放在服务端
客户端传来的 tenantId、role 或 spaceId 只能当作请求参数,不能当作可信权限。服务端必须根据登录身份解析用户所属租户和角色,再决定允许访问哪些知识空间。否则攻击者只需改一个参数,就可能读取别的租户数据。
最小模型可以理解为:用户属于一个租户,用户在租户内拥有若干角色,角色被授权访问一个或多个知识空间,文档必须绑定所属租户和知识空间。检索时先求出允许空间,再把租户条件和空间条件一起下推到数据库或向量检索层。
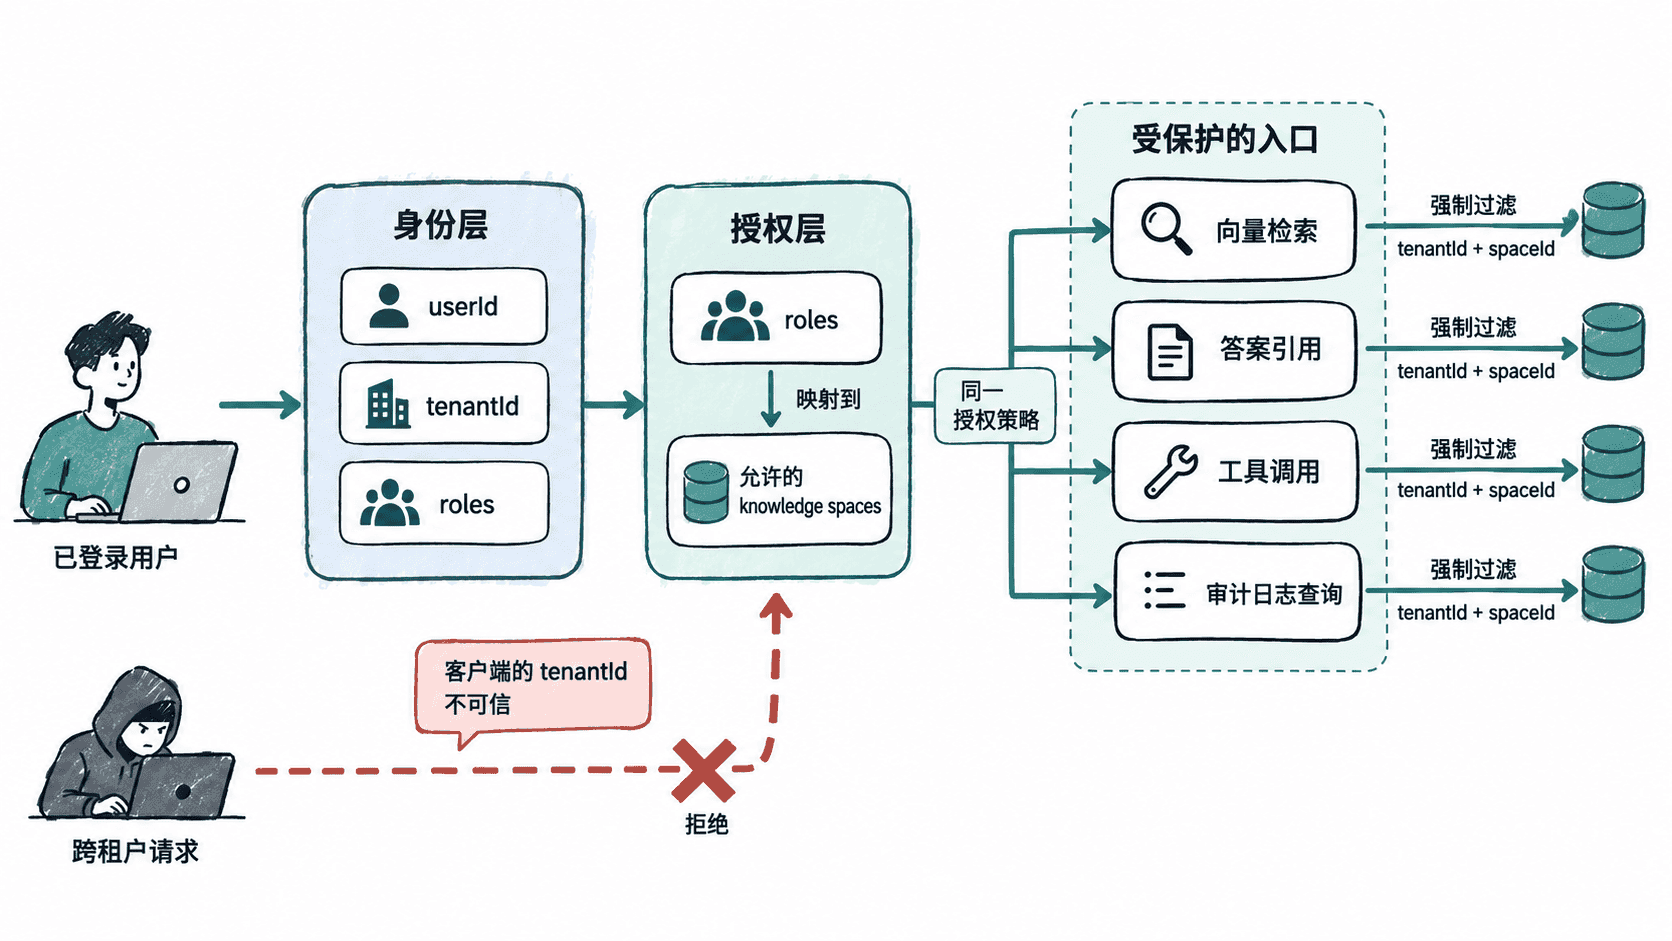
在每个数据入口复用同一授权策略
权限校验最容易失败在“主链路安全、旁路不安全”。例如向量检索加了租户过滤,但引用接口可以按文档 ID 直接读取;工具调用可以查询任意客户;日志后台按会话 ID 就能查看完整内容。解决方法不是分别写四套规则,而是让每个入口都调用同一个授权策略。
下面用纯 Python 演示一个最小服务端实现。它把租户和知识空间检查封装在 authorize_doc 中,检索与直接引用都复用这条规则;跨租户文档即使知道 ID 也无法读取。
from dataclasses import dataclass

@dataclass(frozen=True)
class Principal:
    user_id: str
    tenant_id: str
    allowed_spaces: frozenset[str]

@dataclass(frozen=True)
class Document:
    doc_id: str
    tenant_id: str
    space_id: str
    text: str

DOCS = [
    Document("doc-a1", "tenant-a", "support", "A 租户退款规则"),
    Document("doc-b1", "tenant-b", "support", "B 租户退款规则"),
]

def authorize_doc(principal: Principal, doc: Document) -> bool:
    return (
        doc.tenant_id == principal.tenant_id
        and doc.space_id in principal.allowed_spaces
    )

def retrieve(principal: Principal, keyword: str) -> list[Document]:
    return [
        doc for doc in DOCS
        if keyword in doc.text and authorize_doc(principal, doc)
    ]

def get_citation(principal: Principal, doc_id: str) -> Document:
    doc = next(doc for doc in DOCS if doc.doc_id == doc_id)
    if not authorize_doc(principal, doc):
        raise PermissionError("document access denied")
    return doc

alice = Principal("u-1", "tenant-a", frozenset({"support"}))
print([doc.doc_id for doc in retrieve(alice, "退款")])

try:
    get_citation(alice, "doc-b1")
except PermissionError as exc:
    print(exc)
预期输出
['doc-a1']
document access denied
这里的关键不是 Python 写法,而是授权顺序:先从可信身份得到租户与角色,再计算允许空间,最后把约束应用到实际资源。不要让调用方直接声明“我属于哪个租户”,也不要先取全量结果再在应用层删掉不允许的数据。
把工具与日志也纳入租户边界
工具调用必须携带服务端生成的主体上下文,例如 user_id、tenant_id 和授权范围。下游 CRM、工单或订单服务再次校验这些字段,不能因为请求来自“内部客服服务”就默认拥有全局权限。对于高风险工具,还应检查动作级权限,例如只读角色不能执行退款或修改客户资料。
日志查询同样要按租户隔离。对话内容、检索文档 ID、工具参数和模型输出都可能包含敏感信息,因此日志索引本身也要写入租户字段,并在查询层强制过滤。运维人员如果需要跨租户排障,应走单独的受审计权限,而不是给普通客服后台开放全局搜索。
验收访问隔离
上线前至少验证四条路径:同租户授权文档可检索;跨租户文档即使关键词完全匹配也不可召回;知道越权文档 ID 也无法获取引用;工具和日志接口在修改 tenantId、spaceId 或资源 ID 后仍返回拒绝结果。
真正可靠的租户隔离不是“向量库加一个过滤条件”,而是把服务端身份、资源归属和授权策略串成同一条链路,并让检索、引用、工具和日志都无法绕过这条链。