
大模型应用开发 / 系统课时
在日志中脱敏敏感字段
在日志中脱敏敏感字段
生产环境的客服日志既要支持排障和审计,又不能把手机号、令牌、会话内容或工具参数原样写入日志。本节建立统一脱敏入口,用掩码、带密钥哈希和不落盘三类策略保护数据,并把必要的原始审计数据隔离到受控存储。
学习目标
- 为请求体、会话、工具参数和模型响应定义可执行的敏感字段规则
- 在统一日志入口实施掩码、带密钥哈希和不落盘策略
- 将普通运维日志与受控原始审计数据分离,并验证访问边界
先给字段分级再决定如何处理
不要等日志写出后再做全文正则替换。更稳妥的做法是在结构化日志进入日志系统前,根据字段语义执行策略。字段名只是第一道信号,真正的规则应由数据分类和业务用途决定。
| 数据类型 | 典型字段 | 推荐动作 | 原因 |
|---|---|---|---|
| 凭证与密钥 | authorization、cookie、password |
不落盘 | 一旦泄露可直接被滥用 |
| 直接身份信息 | phone、email、bank_account |
掩码 | 排障通常只需要识别部分特征 |
| 稳定内部标识 | user_id、customer_id |
带密钥哈希 | 允许跨日志关联,又不暴露原值 |
| 模型完整响应 | model_response |
默认不落盘或仅存摘要 | 可能回显客户输入或知识库敏感内容 |
普通 SHA-256 不适合直接处理手机号、邮箱等低熵标识,因为攻击者可以枚举原值。需要稳定关联时,应使用服务端密钥参与的 HMAC,并把密钥放在密钥管理系统中而不是代码仓库。
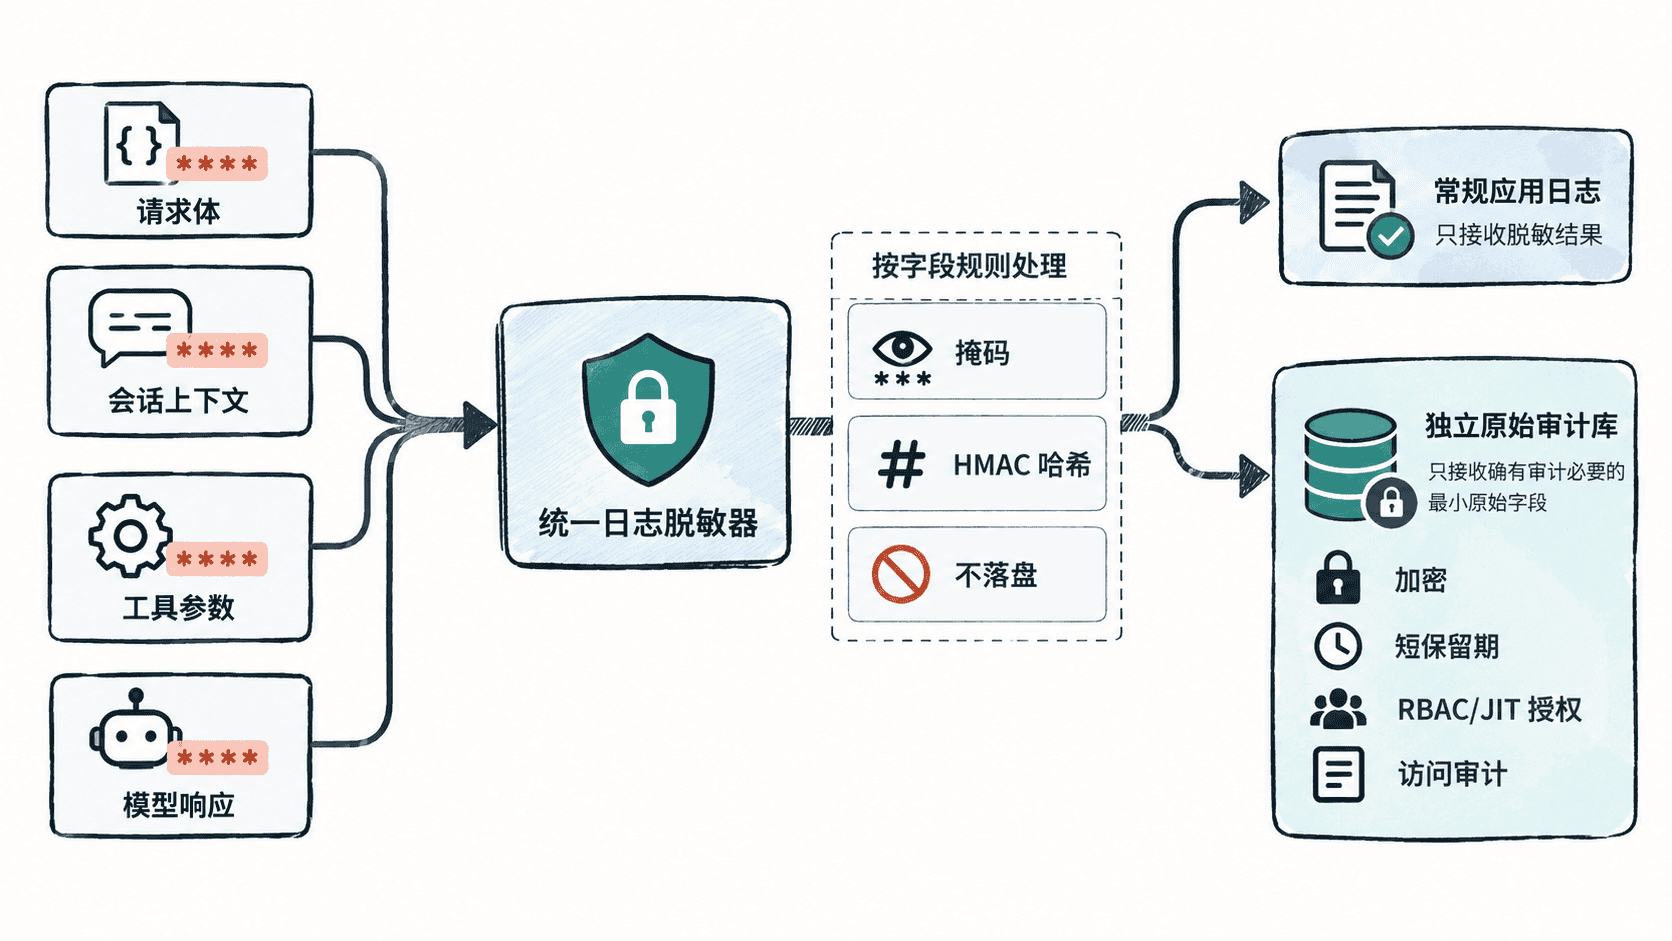
在日志入口统一脱敏
下面的可运行示例对任意嵌套字典和列表统一处理。示例中的 HMAC 密钥只为得到确定输出,生产环境必须从密钥管理系统注入。
import hashlib
import hmac
import json

DROP_FIELDS = {"authorization", "cookie", "password", "model_response"}
MASK_FIELDS = {"phone", "email", "bank_account"}
HASH_FIELDS = {"user_id", "customer_id"}
DEMO_HASH_KEY = b"demo-only-key"

def mask(value):
    text = str(value)
    if len(text) <= 4:
        return "*" * len(text)
    return text[:2] + "*" * (len(text) - 4) + text[-2:]

def stable_hash(value):
    digest = hmac.new(
        DEMO_HASH_KEY,
        str(value).encode("utf-8"),
        hashlib.sha256,
    ).hexdigest()[:24]
    return f"hmac256:{digest}"

def sanitize(value):
    if isinstance(value, dict):
        result = {}
        for key, item in value.items():
            if key in DROP_FIELDS:
                continue
            if key in MASK_FIELDS:
                result[key] = mask(item)
            elif key in HASH_FIELDS:
                result[key] = stable_hash(item)
            else:
                result[key] = sanitize(item)
        return result
    if isinstance(value, list):
        return [sanitize(item) for item in value]
    return value

event = {
    "request_id": "req-001",
    "authorization": "Bearer demo-secret",
    "phone": "13800138000",
    "session": {"user_id": "user-1001", "topic": "refund"},
    "tool_args": {
        "bank_account": "6222020202020202",
        "order_id": "O-100",
    },
    "model_response": "Refund approved for the customer.",
}

print(json.dumps(sanitize(event), ensure_ascii=False, sort_keys=True))
预期输出:
{"phone": "13*******00", "request_id": "req-001", "session": {"topic": "refund", "user_id": "hmac256:89bcd58139808ac47b998afe"}, "tool_args": {"bank_account": "62************02", "order_id": "O-100"}}这里最重要的不是这组字段名,而是所有日志写入都必须走同一个入口。如果 HTTP 中间件做了脱敏,但工具调用模块又直接 logger.info(tool_args),敏感信息仍会绕过规则。
单独保护必要的原始审计数据
有些争议处理、合规调查或安全事件确实需要回看原始数据,但这不意味着普通日志系统应该保留一份完整副本。更合理的边界是:常规日志只保存脱敏后的诊断信息,原始审计库只保存完成审计目标所必需的最小字段。
原始审计库至少要具备独立加密密钥、短且明确的保留期、最小权限角色、按需临时授权以及完整的读取审计记录。客服、研发和运维人员不应因为能查普通日志,就自动获得查看原始审计数据的权限。
用泄漏测试验证规则
上线前应构造一组只用于测试的假敏感值,例如假令牌、假手机号和假账号,让请求完整经过网关、客服服务、工具调用与模型响应链路。随后在普通日志存储中搜索这些原值:任何一次命中都说明存在绕过统一脱敏入口的路径。
验证还要覆盖异常分支。序列化失败、模型超时、工具报错和堆栈记录最容易把整个请求对象写入错误日志。只有正常路径与异常路径都无法检索到测试原值,同时授权用户仍能在受控审计库中按流程取到必要证据,脱敏设计才算真正生效。