
大模型应用开发 / 系统课时
压缩长会话避免上下文膨胀
压缩长会话避免上下文膨胀
长会话不能简单把旧消息删掉,也不能只让模型生成一段“看起来合理”的摘要。本节把历史压缩成可验证的结构化上下文:保留已确认事实、用户约束、未解决问题及原始消息索引,在降低 Token 成本的同时仍能追溯关键细节。
学习目标
- 设计包含事实、约束、待办和来源索引的会话摘要结构
- 判断何时触发压缩,并避免重复摘要造成信息漂移
- 用可运行示例验证压缩结果能回溯到原始消息
为什么不能只保留一段自然语言摘要
一段自由文本摘要容易把“用户明确说过”与“模型推断出来”混在一起。经过多轮再摘要后,数量、时间、订单号、否定条件等细节还可能被改写,最终让后续回答建立在错误上下文上。
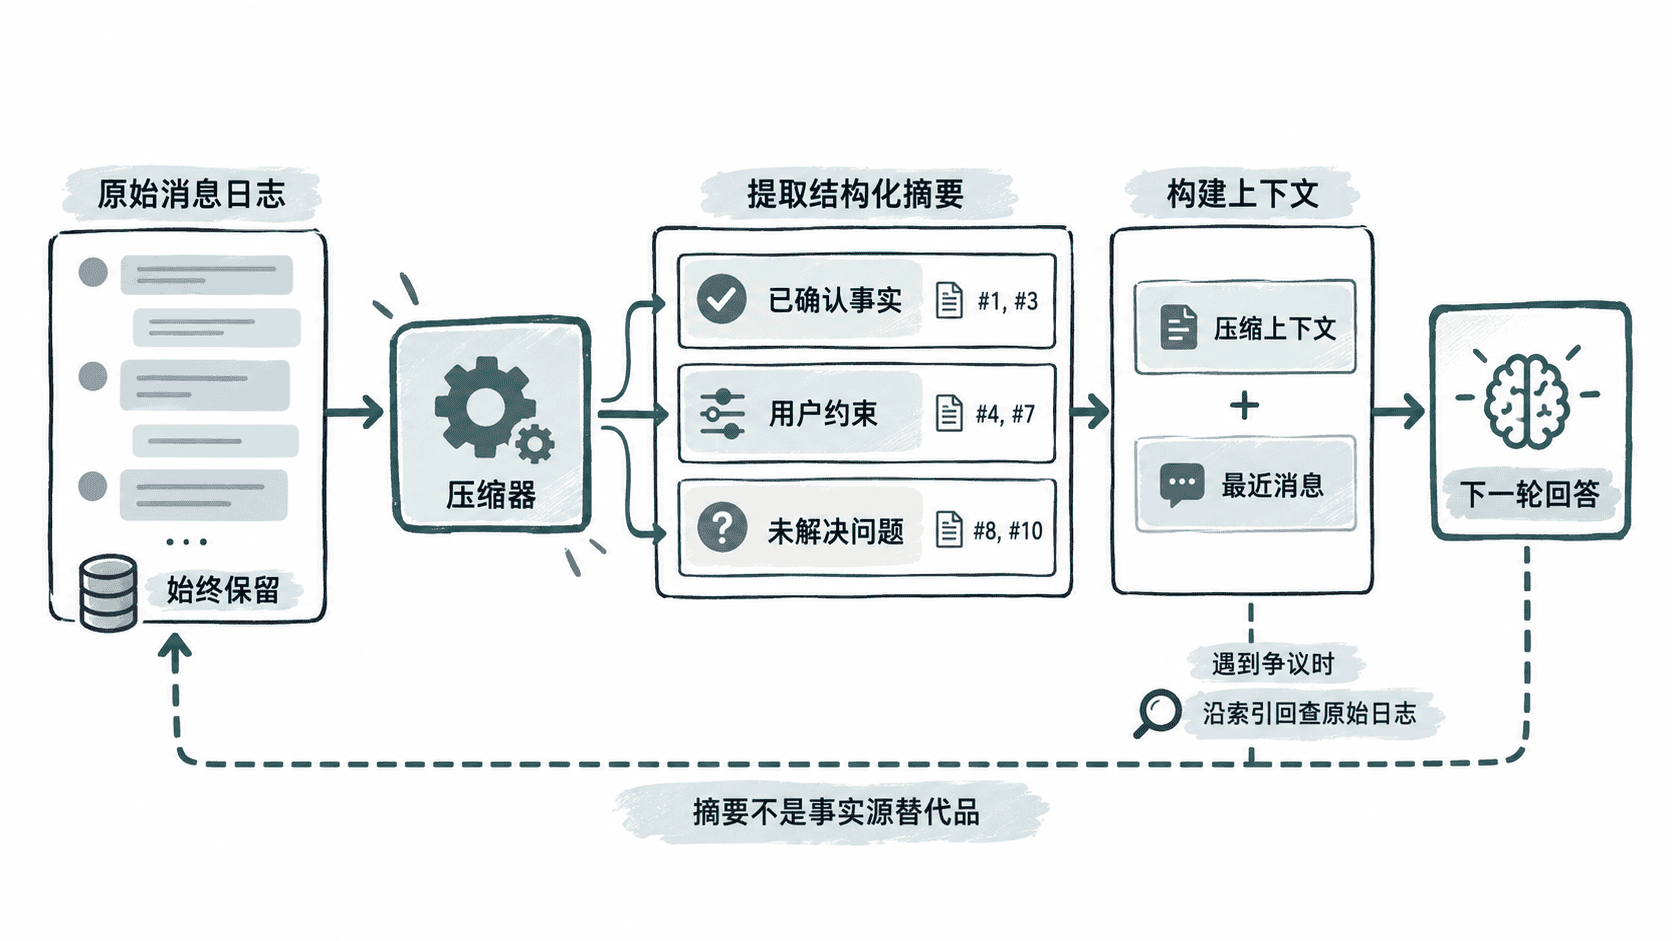
更稳妥的做法是把会话状态拆成四类:已确认事实、用户约束、未解决问题和最近少量原始消息;每条压缩信息都记录对应的消息编号。原始会话日志仍单独保存,摘要只是检索和推理入口,不是唯一事实源。
什么时候触发压缩
触发条件应围绕上下文预算,而不是固定“聊了多少轮”。当历史消息接近模型可用上下文的一定比例,或单次请求的输入成本、延迟超过服务阈值时再压缩;刚发生的重要确认、正在执行的业务动作和最近若干轮消息通常保持原文。
压缩时应从上一次稳定摘要继续增量更新,只处理新增消息。不要每轮都把“旧摘要 + 全量历史”重新总结,因为这种递归改写会放大摘要漂移,也浪费额外 Token。
构造可验证的压缩上下文
下面的本地示例用简单规则模拟“提取已确认信息”的结果,重点不是自然语言理解能力,而是摘要结构和可追溯性。生产环境可把提取步骤替换成结构化输出模型,但仍保留相同的来源索引约束。
import json

messages = [
    {"id": 1, "role": "user", "content": "我的订单号是 A1024。"},
    {"id": 2, "role": "user", "content": "不要电话联系,只发短信。"},
    {"id": 3, "role": "user", "content": "请问什么时候发货?"},
]

def compact(items):
    facts = []
    constraints = []
    unresolved = []

    for item in items:
        text = item["content"]
        if "订单号是" in text:
            order_id = text.split("订单号是", 1)[1].rstrip("。")
            facts.append({"text": f"订单号={order_id}", "sourceMessageIds": [item["id"]]})
        if "不要电话联系" in text:
            constraints.append({"text": "禁止电话联系,仅短信", "sourceMessageIds": [item["id"]]})
        if "什么时候发货" in text:
            unresolved.append({"text": "查询发货时间", "sourceMessageIds": [item["id"]]})

    return {
        "facts": facts,
        "constraints": constraints,
        "unresolved": unresolved,
        "summaryVersion": 1,
    }

print(json.dumps(compact(messages), ensure_ascii=False, indent=2))
预期输出
{
  "facts": [
    {
      "text": "订单号=A1024",
      "sourceMessageIds": [
        1
      ]
    }
  ],
  "constraints": [
    {
      "text": "禁止电话联系,仅短信",
      "sourceMessageIds": [
        2
      ]
    }
  ],
  "unresolved": [
    {
      "text": "查询发货时间",
      "sourceMessageIds": [
        3
      ]
    }
  ],
  "summaryVersion": 1
}
这里最重要的是 sourceMessageIds。当后续模型准备执行退款、修改联系方式或给出承诺时,可以先根据索引回查原文,确认摘要没有把条件、金额或用户意图压错。
压缩后还要做哪些校验
压缩结果至少要检查三件事:摘要中的事实必须能找到来源消息;仍未解决的问题不能被误标为已完成;带否定词、范围、时间和数值的约束不能在改写中丢失。无法确认的内容应标成“待确认”,不要强行变成事实。
当摘要继续增长时,可以按稳定事实、当前任务和短期上下文分层保存。稳定事实低频更新,当前任务随状态变化,最近消息保留原文;这样既控制输入规模,又能避免“为了省 Token 把证据一起删掉”。