
大模型应用开发 / 系统课时
分开评估检索与生成质量
分开评估检索与生成质量
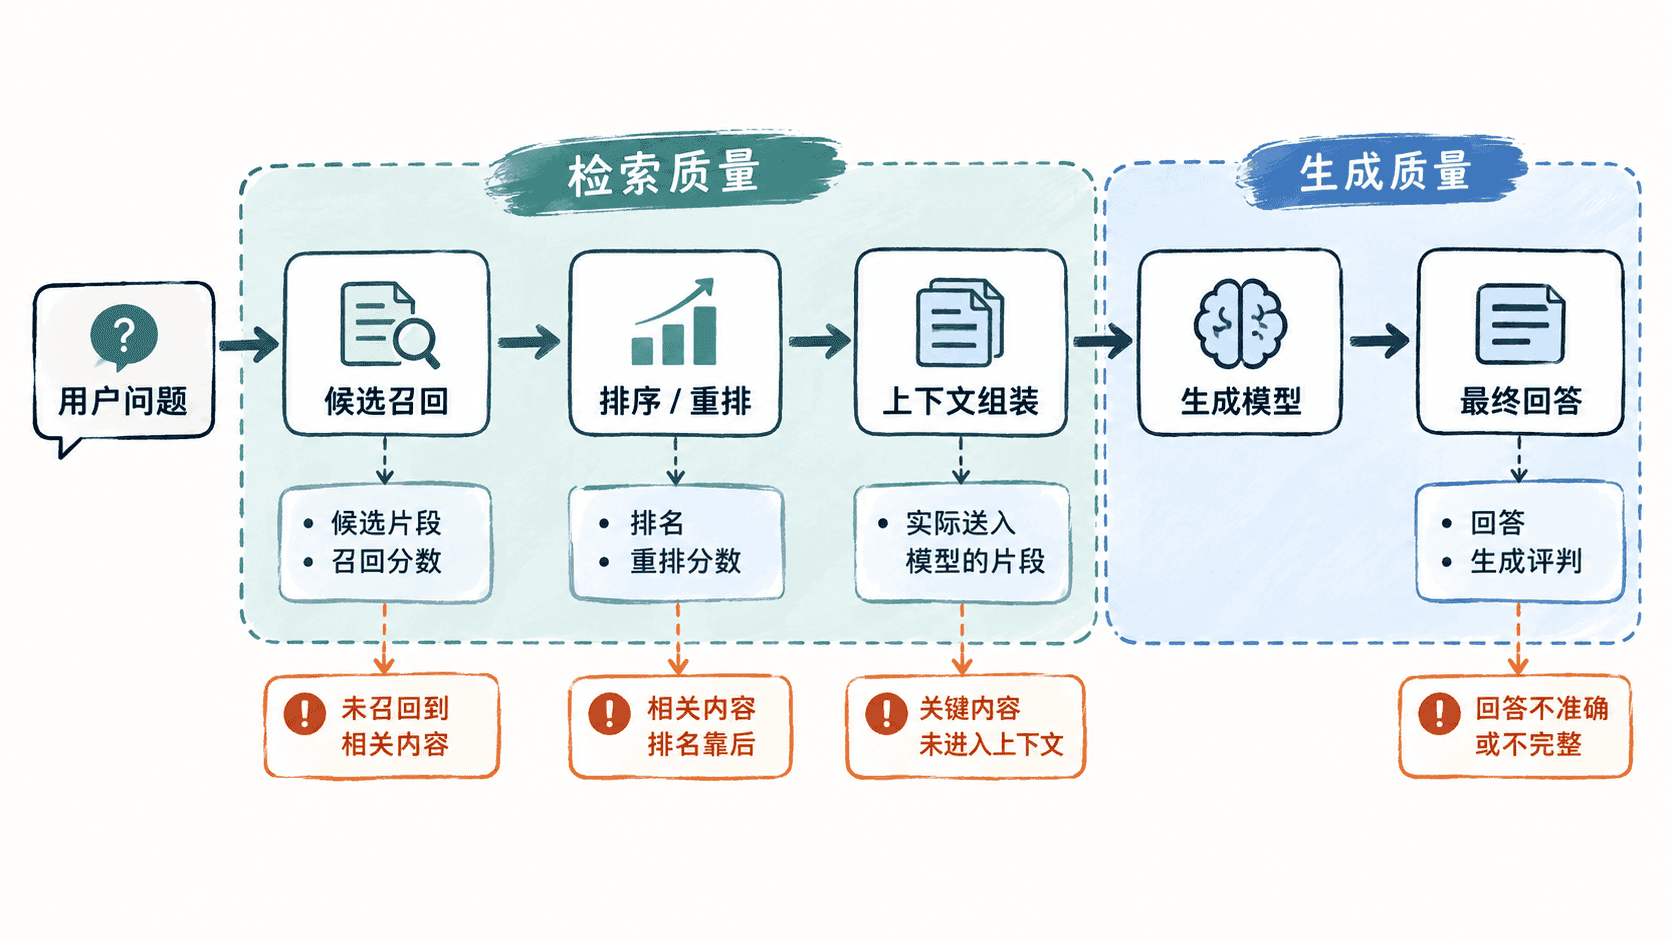
端到端回答看起来正确,并不代表检索阶段真的找对了证据。本节把一次 RAG 请求拆成候选召回、排序、最终上下文和回答四个可观测位置,让检索失败与生成失败能够被分别发现和修复。
学习目标
- 区分检索质量与生成质量,避免只看最终回答得分
- 设计能保存候选片段、排名、最终上下文与回答的评测记录
- 根据分层结果判断问题应该优先修检索还是修生成
为什么不能只评最终回答
RAG 的最终答案同时受检索和生成影响。如果只给回答打一个总分,就会把两类性质完全不同的问题混在一起:检索可能已经漏掉正确证据,但模型凭参数知识猜对了;也可能正确证据已经进入上下文,模型却遗漏、曲解或编造了答案。
因此,至少要分别回答两个问题:正确证据有没有被找到并送进模型,以及模型有没有忠实利用这些证据回答问题。前者属于检索层,后者属于生成层。
| 检索 | 生成 | 典型现象 | 优先动作 |
|---|---|---|---|
| 通过 | 通过 | 正确证据进入上下文,回答也正确 | 保持当前方案 |
| 失败 | 通过 | 模型碰巧答对,但证据缺失 | 修切分、召回、排序 |
| 通过 | 失败 | 证据充分,回答却遗漏或幻觉 | 修提示词、模型或生成约束 |
| 失败 | 失败 | 找错资料,回答也错误 | 先修检索,再重新评生成 |
保存可追溯的评测记录
一条评测记录不能只保存问题和回答。为了复盘检索链路,应保留原始候选、候选顺序、各阶段分数、最终选入上下文的片段,以及人工标注的相关证据。生成侧则至少保存最终回答和针对忠实性、完整性的判定。
片段示例:下面的数据结构表示一次评测记录,字段名可以按实际系统调整,但四个观测位置不应被合并掉。
{
  "question": "企业报销单需要保存多久?",
  "goldEvidenceIds": ["policy-17#p3"],
  "candidates": [
    {"id": "policy-09#p2", "score": 0.81},
    {"id": "policy-17#p3", "score": 0.78}
  ],
  "rankedCandidateIds": ["policy-17#p3", "policy-09#p2"],
  "finalContextIds": ["policy-17#p3"],
  "answer": "报销单及其附件应保存 10 年。",
  "answerJudgement": {
    "faithful": true,
    "complete": true
  }
}验证这类记录时,应确认候选集合能够还原召回结果,排名能够还原重排结果,finalContextIds 与真实发送给模型的上下文一致,并且回答判定基于同一次请求,而不是事后重新生成的内容。
按固定顺序定位失败
诊断时先看检索,再看生成,可以避免把上游错误误判成模型能力问题。
- 检查人工标注的相关证据是否出现在候选集合中。没有出现,说明召回阶段已经失败。
- 检查相关证据在排序后的名次。候选中存在但排得过低,说明排序或重排需要优化。
- 检查相关证据是否真正进入最终上下文。排名足够靠前却被截断,通常是上下文预算、去重或过滤规则的问题。
- 只有证据已经正确进入上下文后,再评价回答是否忠实、完整并直接回答问题。
让两层实验互不干扰
评估检索方案时,应尽量固定生成模型、提示词和上下文组装规则,只比较切分方式、Embedding、混合召回或重排的变化。这样候选命中和排序变化才能归因到检索策略本身。
评估生成方案时,则应固定一组已经确认正确的上下文,再比较提示词、模型版本、引用约束或解码参数。否则检索结果同时变化,就无法判断回答提升究竟来自模型还是来自更好的证据。
上线后的评测记录也应保留这两个层次。这样当端到端正确率下降时,可以先判断是相关证据没有进入上下文,还是模型没有正确使用已经提供的证据,再把优化资源投入真正失败的环节。