
大模型应用开发 / 系统课时
识别意图并路由处理链路
识别意图并路由处理链路
客服系统不能把所有问题都送进同一条 RAG 链路:订单查询需要业务接口,账户操作需要鉴权与确认,投诉和转人工又有不同的处理要求。本节建立“规则优先、模型补充、统一审计”的意图路由器,让每条请求进入正确处理器。
学习目标
- 划分 FAQ/RAG、订单查询、账户操作、投诉和转人工等核心意图
- 组合高精度规则与模型分类,并定义冲突时的路由优先级
- 为所有分支输出一致的审计信息,便于追踪和复盘
先把意图映射到真正不同的处理链路
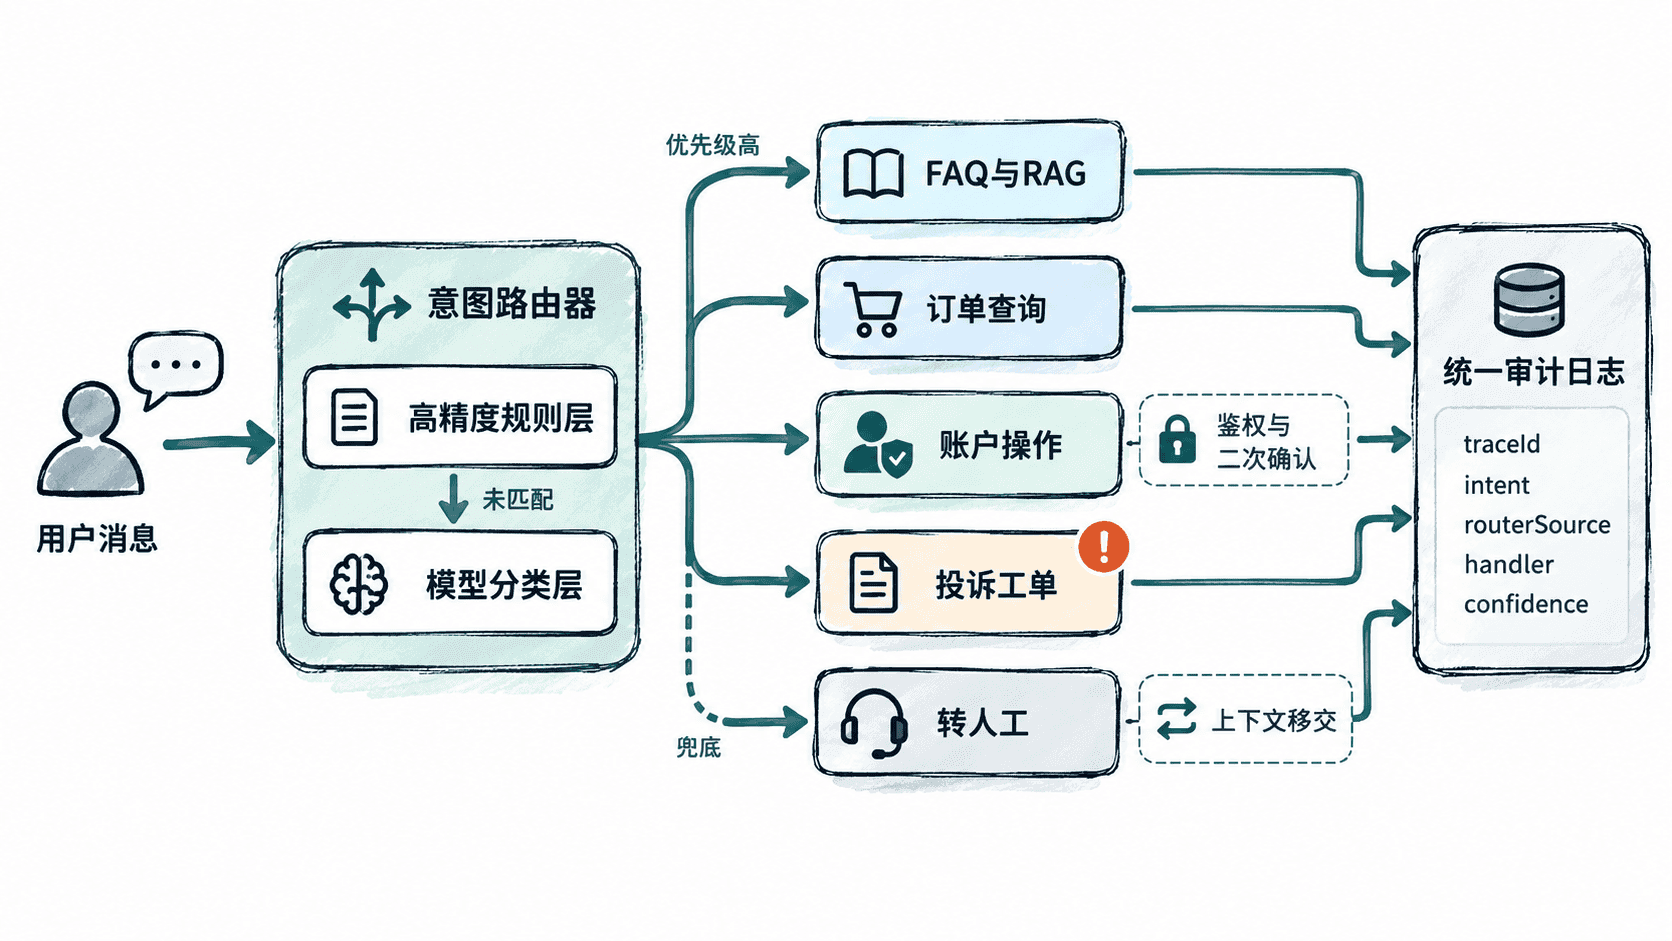
意图分类的价值不在标签本身,而在于它决定后续能力边界。FAQ/RAG 只读知识库;订单查询读取业务系统;账户操作可能产生写入,必须增加鉴权与二次确认;投诉需要进入工单或升级流程;转人工则应尽快停止自动回答并携带上下文移交。
规则和模型怎样配合
规则适合少量高风险、高确定性的表达,例如“转人工”“注销账户”“投诉”。这些意图一旦误分,代价通常高于 FAQ 误分,因此应优先命中。模型分类用于覆盖表达多样、边界模糊的普通咨询,并输出置信度;低置信度时可以回退到澄清问题或人工队列。
当一条消息同时命中多个意图时,要有明确优先级。例如显式转人工通常高于其他分类;投诉可高于普通订单查询;账户写操作则不能因为同时包含知识问句就被送去 RAG。优先级应作为可配置策略,而不是散落在多个处理器里的隐式判断。
实现一个最小可运行路由器
为了让示例可以直接运行,下面用规则处理高风险意图,并用一个可替换的 model_classify 函数模拟普通模型分类结果。生产环境接入真实分类模型时,保持统一的返回字段即可。
import json

RULES = [
    ("human_handoff", ("转人工", "人工客服")),
    ("complaint", ("投诉", "强烈不满")),
    ("account_action", ("注销账户", "修改手机号", "重置密码")),
    ("order_query", ("订单", "物流", "发货")),
]

HANDLERS = {
    "faq_rag": "rag_handler",
    "order_query": "order_handler",
    "account_action": "account_handler",
    "complaint": "complaint_handler",
    "human_handoff": "human_handler",
}

def model_classify(text):
    # 本地示例固定回退到 FAQ/RAG;生产中替换成真实分类模型。
    return "faq_rag", 0.73

def route(text, trace_id="<ID>"):
    for intent, keywords in RULES:
        if any(keyword in text for keyword in keywords):
            return {
                "traceId": trace_id,
                "intent": intent,
                "routerSource": "rule",
                "confidence": 1.0,
                "handler": HANDLERS[intent],
            }

    intent, confidence = model_classify(text)
    return {
        "traceId": trace_id,
        "intent": intent,
        "routerSource": "model",
        "confidence": confidence,
        "handler": HANDLERS[intent],
    }

for text in ["我要转人工", "订单 A1024 什么时候发货", "如何查看电子发票"]:
    print(json.dumps(route(text), ensure_ascii=False))
预期输出
{"traceId": "<ID>", "intent": "human_handoff", "routerSource": "rule", "confidence": 1.0, "handler": "human_handler"}
{"traceId": "<ID>", "intent": "order_query", "routerSource": "rule", "confidence": 1.0, "handler": "order_handler"}
{"traceId": "<ID>", "intent": "faq_rag", "routerSource": "model", "confidence": 0.73, "handler": "rag_handler"}
实际系统中的 <ID> 应替换为请求级唯一追踪标识。模型分支还应记录模型版本或路由策略版本,方便回放“为什么当时被分到这条链路”。
统一审计而不是各分支各记一套
路由完成后,所有处理器至少共享 traceId、消息 ID、意图、分类来源、置信度、目标处理器和策略版本。高风险动作还要记录鉴权结果、确认步骤和业务操作 ID,但不要把密码、完整身份证号等敏感数据直接写入普通审计日志。
审计信息应在进入处理器前就生成,这样即使某个下游接口超时,也能区分“路由错误”和“处理器执行失败”。投诉和转人工还应保留会话摘要或消息引用,避免用户再次完整复述问题。
给低置信度和业务动作留安全出口
不要把分类器的最高分强行当成正确答案。普通知识问答可以设置低置信度澄清;账户写操作若不能确定意图,应拒绝直接执行并要求用户明确确认;明确要求人工时,应优先尊重转人工意图,而不是继续尝试自动回答。
一个可靠的路由器最终追求的不是“分类准确率越高越好”,而是让不同错误的业务代价可控:低风险问答允许回退,高风险动作必须多一道确认,任何分支都能通过统一审计信息还原当时的路由决策。