
大模型应用开发 / 系统课时
转人工时完整交接上下文
转人工时完整交接上下文
转人工不是把聊天窗口“甩”给客服,而是把人工接手所需的信息压缩成可追踪的交接包。本节给出一套可落地的摘要结构:既让客服快速理解用户诉求,也保留身份、证据、工具结果与失败原因,并把会话和工单绑定起来。
学习目标
- 设计一份覆盖诉求、身份、关键证据、工具结果和失败原因的交接摘要
- 区分“给客服看的摘要”与“给系统追踪的结构化字段”
- 让会话、工单和引用证据能够被后续审计与复盘
交接包要解决什么问题
人工客服最怕两种交接:一种只有“用户要求转人工”,另一种把整段聊天原样塞过去。前者缺上下文,后者让客服重新阅读几十轮消息。有效交接应该回答六个问题:用户要什么、身份是否核验、已经确认了什么、引用了哪些知识、调用过什么工具、为什么机器人没能继续处理。
因此交接内容要分成两层。面向客服的是短摘要,强调当前诉求和下一步动作;面向系统的是结构化字段,用于绑定会话、工单、知识引用和工具调用记录。二者不能混成一段长文本,否则既难读,也不利于检索和审计。
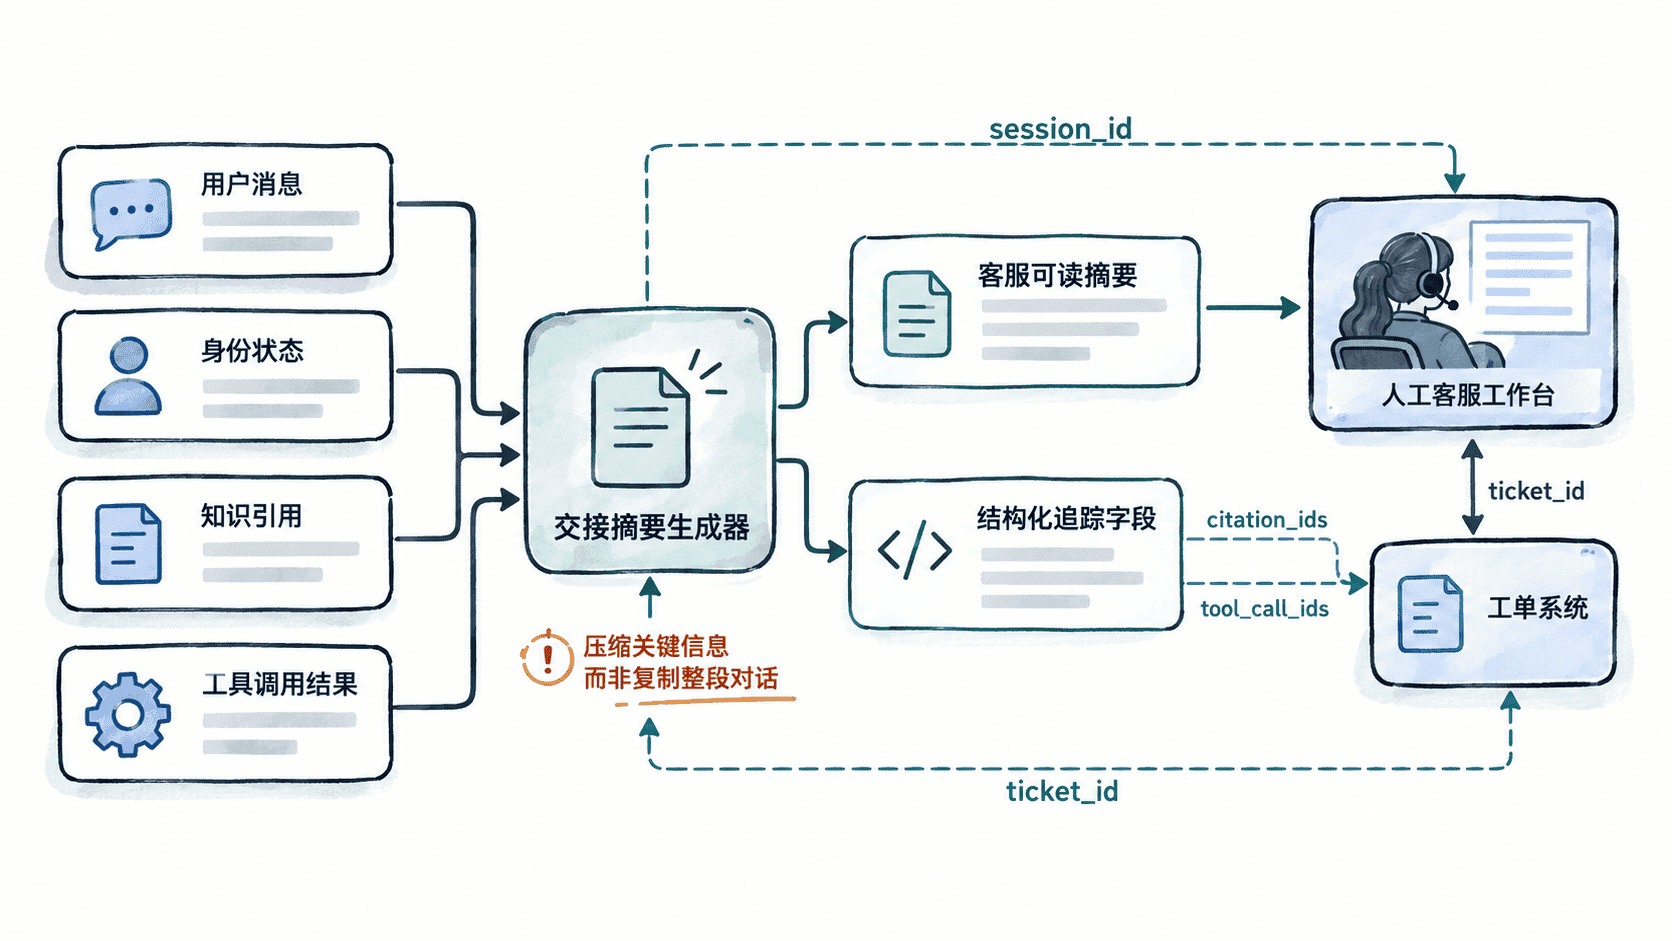
摘要只保留能推动处理的信息
摘要建议控制在客服一眼能扫完的长度。第一句写用户当前诉求,随后补充身份与权限状态,再列出已经完成的关键动作和仍未解决的阻塞。聊天里的寒暄、重复追问和无效尝试不应进入摘要。
例如,用户想查询退款进度,但机器人发现订单归属与当前账号不一致,此时摘要重点不是“聊了哪些话”,而是“用户要查退款、身份校验未通过、已查询到订单存在、因账号不匹配无法继续”。客服接手后就知道先做人工核验,而不是再次询问问题背景。
用结构化字段保存追踪关系
下面的 Python 示例把会话状态整理成一个可直接提交给工单服务的交接对象。它刻意把“人读摘要”和“系统字段”分开,并保留引用与工具调用的 ID,方便后续回放证据链。
import json

def build_handoff():
    return {
        "session_id": "<ID>",
        "ticket_id": "<ID>",
        "summary": "用户查询退款进度;身份未完成核验;已确认订单存在,但账号归属不一致,需要人工继续核验。",
        "identity_status": "verification_required",
        "user_intent": "query_refund_status",
        "key_messages": [
            "用户提供订单号并询问退款到账时间",
            "系统发现订单账号与当前登录账号不一致"
        ],
        "citation_ids": ["<ID>"],
        "tool_results": [
            {
                "tool_call_id": "<ID>",
                "tool": "get_order",
                "status": "success",
                "result": "order_found"
            }
        ],
        "failure_reason": "account_owner_mismatch"
    }

print(json.dumps(build_handoff(), ensure_ascii=False, indent=2))
预期输出
{
  "session_id": "<ID>",
  "ticket_id": "<ID>",
  "summary": "用户查询退款进度;身份未完成核验;已确认订单存在,但账号归属不一致,需要人工继续核验。",
  "identity_status": "verification_required",
  "user_intent": "query_refund_status",
  "key_messages": [
    "用户提供订单号并询问退款到账时间",
    "系统发现订单账号与当前登录账号不一致"
  ],
  "citation_ids": [
    "<ID>"
  ],
  "tool_results": [
    {
      "tool_call_id": "<ID>",
      "tool": "get_order",
      "status": "success",
      "result": "order_found"
    }
  ],
  "failure_reason": "account_owner_mismatch"
}
其中 <ID> 代表运行时生成的会话、工单、引用或工具调用标识,实际值会不同。生产环境还应保存交接时间、摘要版本和生成模型版本,但这些字段属于追踪元数据,不需要堆进客服可读摘要。
关联会话和工单后再完成转接
创建工单时,应先持久化 ticket_id 与 session_id 的双向关系,再把交接包提交给人工队列。这样客服后续补充处理结果时,系统能回写到原会话;质量团队复盘某次失败时,也能从工单定位到当时的知识引用和工具调用。
如果工单创建失败,不应先结束机器人会话,否则用户会看到“已转人工”却没有真实工单。更稳妥的顺序是:生成交接包、创建工单、写入关联关系、确认进入人工队列,最后再向用户返回转接成功。
验收交接是否完整
上线前可以用一个简单标准验收:人工客服在不重读完整对话的情况下,能否在一分钟内说出用户诉求、当前身份状态、已执行动作、失败点和下一步。若做不到,摘要缺信息;若必须翻阅大量原始消息才能理解,摘要又过于依赖上下文。
高质量转人工的目标不是“保存更多文本”,而是把机器人已经获得的上下文转换成可读、可追踪、可继续执行的工作状态。