
大模型应用开发 / 系统课时
保存多轮会话的必要上下文
保存多轮会话的必要上下文
多轮客服并不需要把完整聊天记录永久塞给模型。更稳定的做法是把订单号、产品、时间范围和当前任务等必要信息结构化保存,同时区分短期对话、稳定用户资料和可丢弃闲聊,让后续每一轮只携带真正影响回答的上下文。
学习目标
- 区分短期会话状态、稳定用户信息与可丢弃内容
- 将订单、产品、时间范围和当前意图保存为结构化字段
- 用受控的上下文组装替代无限增长的完整聊天历史
不要把聊天记录等同于会话状态
假设用户先问“昨天买的耳机什么时候发货”,下一轮只说“那能改地址吗”。第二句话虽然没有订单号,但客服必须知道“那”指的是刚才讨论的订单。真正需要保存的是当前订单、商品和用户正在执行的任务,而不是前面每一句寒暄。
可以把上下文分为三类:短期状态只服务当前会话,例如正在查询的订单;稳定信息来自可信用户资料,例如会员等级或默认语言;闲聊、重复确认和已经结束的话题通常可以丢弃。稳定信息应来自业务系统,而不是仅凭模型从聊天中猜测后永久写入。
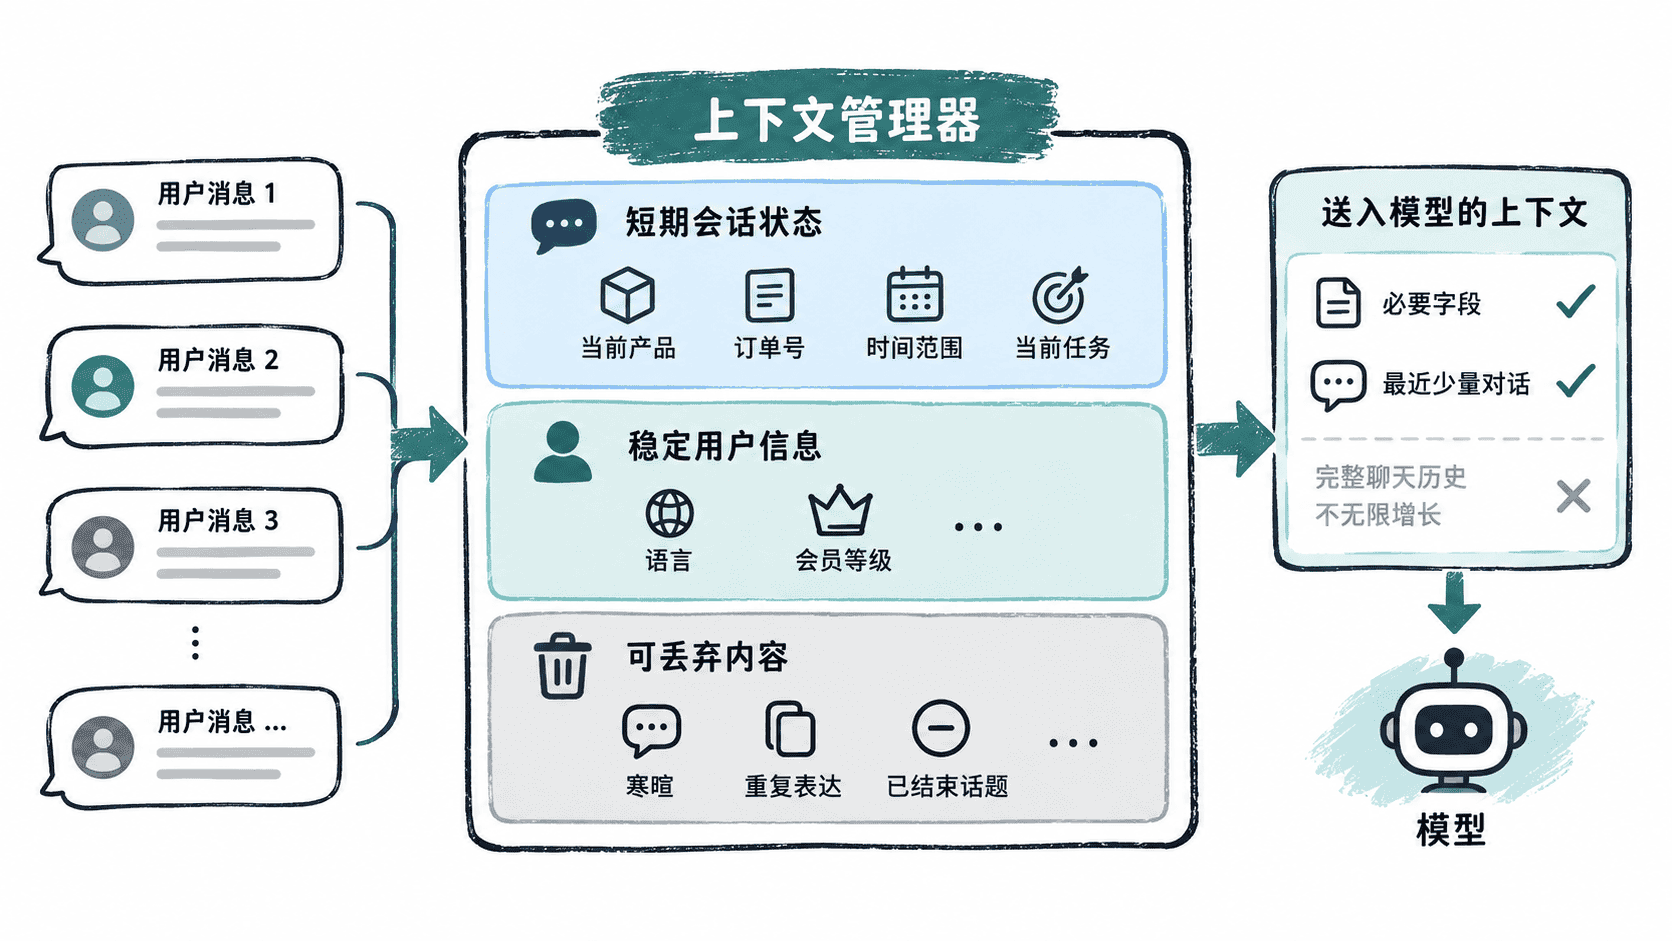
用结构化字段保存真正需要继承的信息
自然语言摘要适合压缩背景,但订单号、日期和产品标识等业务字段更适合显式保存,因为后续代码需要可靠地读取和校验它们。字段还应带有来源和生命周期:例如订单号来自用户选择的订单,可在任务结束后清除;默认语言来自账户资料,可以跨会话保留。
下面的 Python 示例只保留当前客服任务所需的结构化状态,并用新一轮确认的信息覆盖旧值。
from dataclasses import dataclass, asdict
from typing import Optional

@dataclass
class ConversationState:
    product: Optional[str] = None
    order_id: Optional[str] = None
    time_range: Optional[str] = None
    active_task: Optional[str] = None

    def update(self, **changes: str) -> None:
        for key, value in changes.items():
            if hasattr(self, key) and value:
                setattr(self, key, value)

def main() -> None:
    state = ConversationState()
    state.update(product="无线耳机", order_id="ORD-1008", time_range="昨天")
    state.update(active_task="修改收货地址")
    print(asdict(state))

if __name__ == "__main__":
    main()
预期输出
{'product': '无线耳机', 'order_id': 'ORD-1008', 'time_range': '昨天', 'active_task': '修改收货地址'}真实系统中,像 order_id 这样的字段还应在使用前重新校验是否属于当前用户,不能因为它曾经出现在历史消息里就默认可信。
每轮只组装当前任务需要的上下文
发送给模型的内容可以由四部分组成:固定系统规则、当前用户问题、与当前任务相关的结构化状态,以及本轮检索到的知识证据。最近几轮原始对话可以作为补充,但应设置明确窗口,而不是随着会话长度无限增长。
例如用户已经从“查询物流”切换到“咨询退货政策”时,可以清除 active_task 中的物流状态;如果新的问题不再依赖某个时间范围,也不必继续携带它。这样既减少 token 消耗,也降低旧信息干扰新问题的概率。
处理冲突与过期信息
上下文不是写入后永久有效。用户可能先说“查订单 A”,几轮后又明确改成“看订单 B”;此时最新明确选择应覆盖旧订单。时间范围、当前任务和临时筛选条件也应在任务结束、超时或主题切换时清理。
稳定资料的更新则要更谨慎。例如用户在聊天中说“以后都用英文”,可以把它视为本次会话偏好,但是否写回账户长期设置,应经过明确确认并调用对应业务接口。这样可以避免模型把一句临时表达误当成永久用户属性。
用三个问题判断是否值得保存
设计字段时可以逐项检查:下一轮回答是否真的依赖它;它的值是否来自可信来源或经过用户确认;什么时候应该覆盖或删除。如果一个信息既不会影响后续决策,也没有明确生命周期,就不应该进入长期状态。
多轮体验的关键不是记得越多越好,而是让系统持续保留当前任务所需的最小事实集合。结构化状态负责精确继承业务实体,少量近期对话负责语言连贯,稳定资料由可信系统提供,三者分开管理后,会话长度增长也不会迫使模型反复携带全部历史。