
大模型应用开发 / 系统课时
清洗 PDF 网页与表格内容
清洗 PDF 网页与表格内容
企业资料进入 RAG 前,最容易被忽略的是“可读但不可检索”的脏数据。本节把 PDF、网页和表格统一清洗为保留标题、段落与关键字段的结构化文本,并用一个可运行示例验证去噪与去重结果。
学习目标
- 区分 PDF、网页和表格中应删除的噪声与必须保留的语义结构
- 将不同来源统一为适合后续切分与检索的结构化文本块
- 用可回答性、重复率和乱码检查验收清洗结果
清洗目标是保留可检索语义
清洗不是把文本“删得越短越好”,而是去掉不会帮助回答问题的内容,同时保留能解释上下文的结构。页眉、页脚、导航和重复版权声明通常会制造大量相似片段;标题层级、条款编号、表头、单位和字段名则直接决定片段是否能独立回答问题。
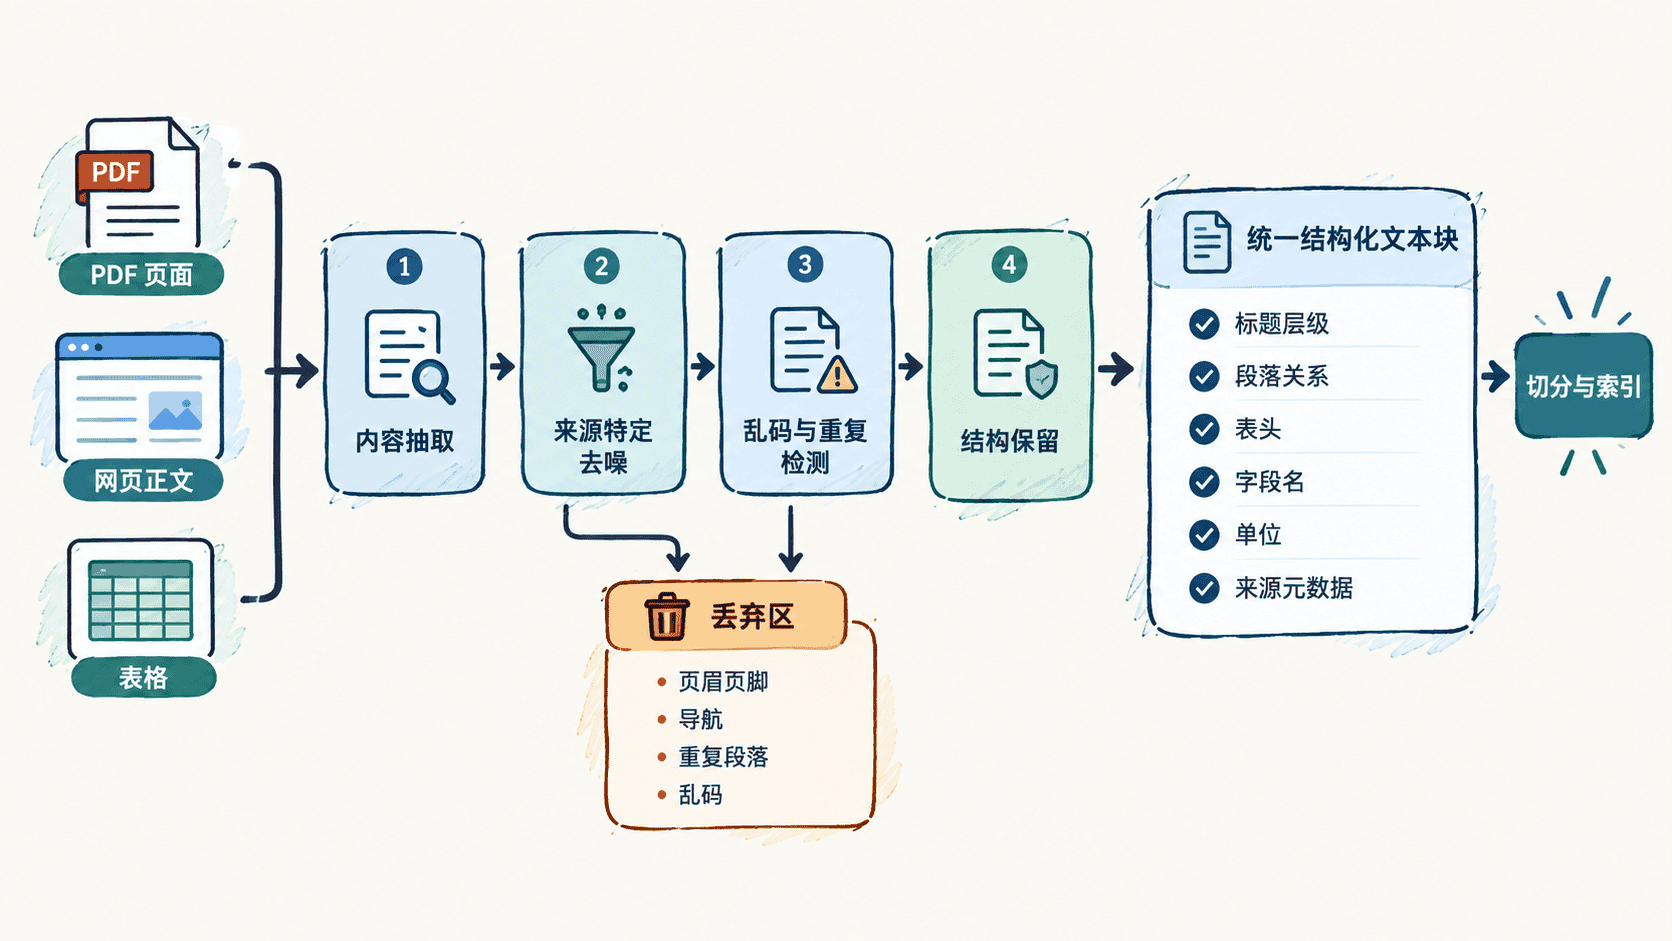
同一条规则不能机械套到所有来源。例如网页中的导航应删除,但产品文档正文里的“上一页/下一页”若属于流程说明就不能按关键词误删;PDF 的页码可以删除,但页码对应的来源定位信息可以单独保存在元数据里,而不是彻底丢失。
分来源处理噪声与结构
| 来源 | 优先清理 | 必须保留 |
|---|---|---|
| 重复页眉页脚、独立页码、OCR 断行、跨页重复文本 | 标题层级、条款编号、列表关系、图表标题、页或章节来源 | |
| 网页 | 导航、广告、Cookie 提示、相关推荐、站点页脚 | 正文标题、段落、FAQ 问答关系、列表与必要链接文本 |
| 表格 | 空行、装饰性合并单元格、重复表头、无意义占位值 | 列名、行主键、单位、数值、状态字段及行内对应关系 |
表格尤其不能只抽取单元格值。把“1 个工作日”单独写入向量库几乎没有意义;写成“场景:重复扣款;处理时限:1 个工作日”后,字段和值仍保持绑定,检索时才有机会直接命中问题。
统一成结构化中间表示
实际系统可以让 PDF、HTML 和表格解析器先输出统一的 block,再做通用去噪。下面的示例模拟已经完成抽取的 block:删除页眉、页脚和导航,合并 Unicode 形态,去掉相邻重复段落,并把表格行改写为“字段:值”的可检索文本。
from __future__ import annotations
import unicodedata

def normalize_text(text: str) -> str:
    # NFKC 可统一全角字符等兼容形态,split 再 join 同时压缩异常空白。
    text = unicodedata.normalize("NFKC", text).replace(chr(160), " ")
    return " ".join(text.split())

def clean_blocks(blocks: list[dict]) -> list[str]:
    cleaned: list[str] = []
    last_paragraph: str | None = None
    for block in blocks:
        kind = block["kind"]
        if kind in {"header", "footer", "nav"}:
            continue
        if kind == "title":
            level = block.get("level", 2)
            cleaned.append("#" * level + " " + normalize_text(block["text"]))
        elif kind == "paragraph":
            text = normalize_text(block["text"])
            # 只去掉相邻完全重复段落,避免误删正文中真正重复出现的条款。
            if text and text != last_paragraph:
                cleaned.append(text)
                last_paragraph = text
        elif kind == "table":
            for row in block["rows"]:
                # 表头与单元格值一起输出,保留字段和值的对应关系。
                cleaned.append(";".join(
                    f"{key}:{normalize_text(str(value))}" for key, value in row.items()
                ))
    return cleaned

blocks = [
    {"kind": "header", "text": "ACME 客服手册"},
    {"kind": "title", "level": 2, "text": "退款规则"},
    {"kind": "paragraph", "text": "付款后 7 天内可申请退款。"},
    {"kind": "paragraph", "text": "付款后 7 天内可申请退款。"},
    {"kind": "nav", "text": "首页 > 帮助中心"},
    {"kind": "table", "rows": [{"场景": "重复扣款", "处理时限": "1 个工作日"}]},
    {"kind": "footer", "text": "第 12 页"},
]
print("\n".join(clean_blocks(blocks)))
预期输出
## 退款规则
付款后 7 天内可申请退款。
场景:重复扣款;处理时限:1 个工作日
这里故意没有把所有重复文本都做全局去重。企业制度中可能在不同章节重复同一句限制条件,如果只按文本哈希全局删除,会破坏章节完整性。更稳妥的做法是先按来源、章节和位置判断重复是否属于版式噪声,再决定是否删除。
用可回答性验收清洗结果
清洗完成后不要只看“字符数减少了多少”。应抽样检查原文与清洗稿:标题是否仍能约束下方段落,条款编号和否定条件是否保留,表格字段是否仍与值绑定,重复导航是否消失,乱码是否被标记而不是静默吞掉。
最终标准是清洗后的文本能否在脱离原页面布局后仍回答真实客服问题。只要片段还需要读者猜“这个数值属于哪个字段”或“这句话位于哪个规则下面”,就说明清洗过度或结构保留不足,还不适合进入切分和向量化阶段。