
大模型应用开发 / 系统课时
划清智能客服的问题边界
划清智能客服的问题边界
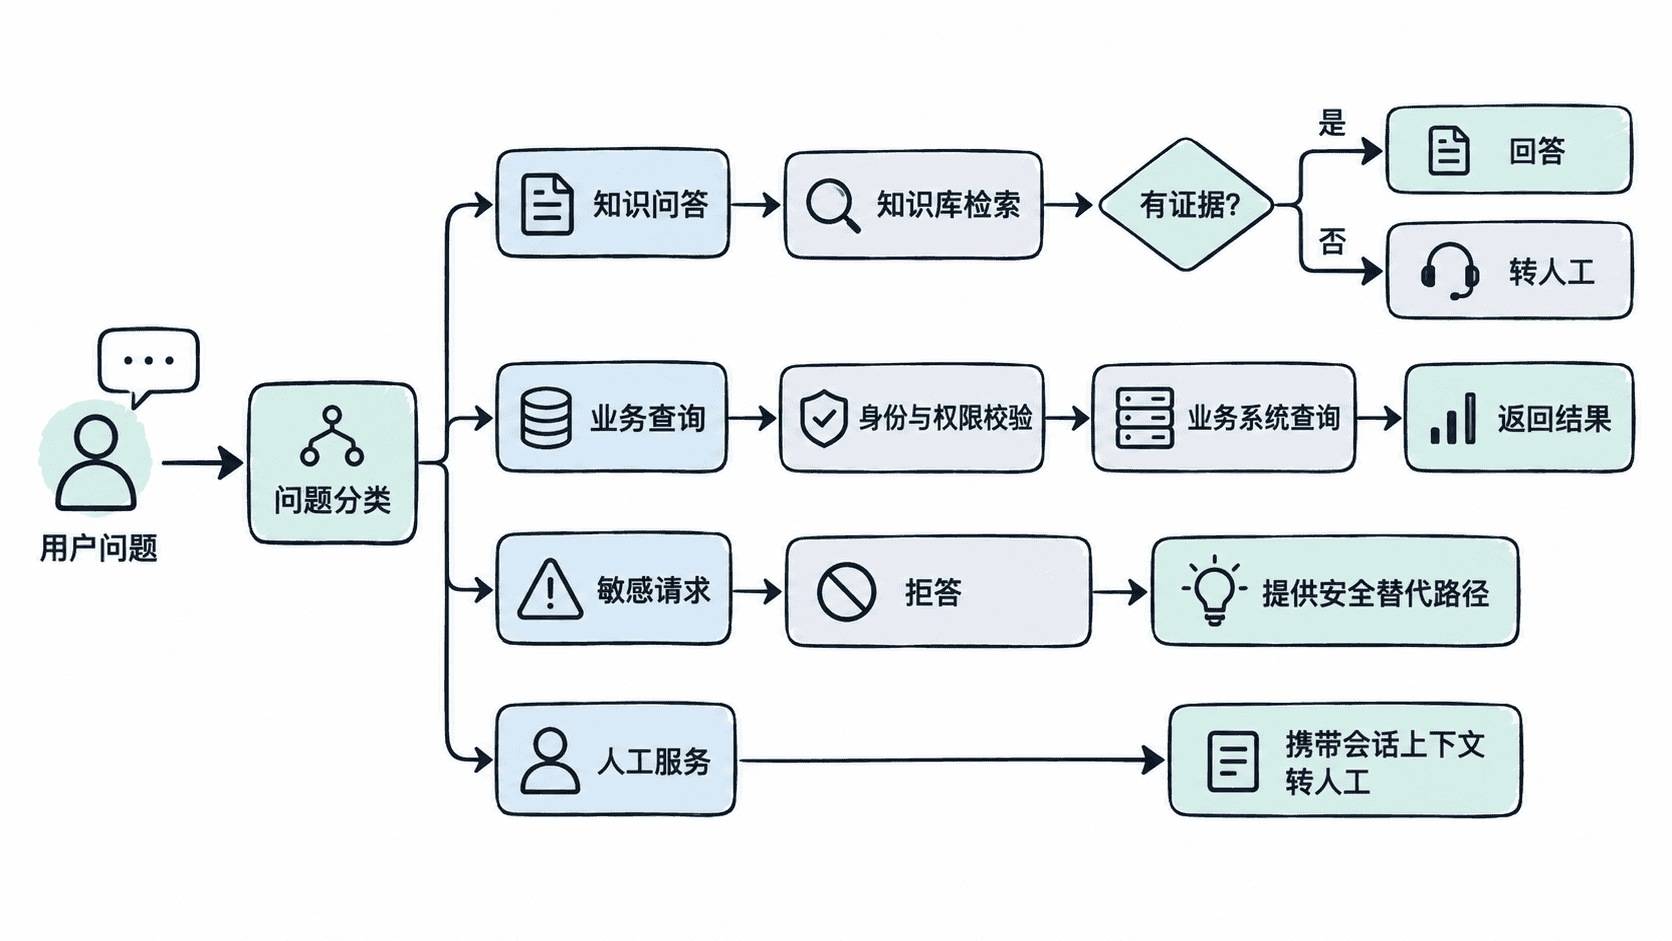
智能客服最先要解决的不是“能回答多少”,而是“哪些问题允许自动回答、依据是什么、什么时候必须停下”。本篇把用户请求划成四类,并把分类结果直接映射到回答、查询、拒答和转人工动作。
学习目标
- 区分知识问答、业务查询、敏感请求和人工服务四类问题
- 用可验证性、权限和风险判断系统是否应该自动作答
- 把分类结果转成可执行的回答、拒答与转人工规则
先把用户问题分成四类
分类的关键不是语言形式,而是系统需要依赖什么事实才能给出可靠结果。同一句“我的订单怎么还没到”,既可能是在问通用配送规则,也可能是在查询某个订单的实时状态,因此不能只凭关键词决定处理方式。
| 类型 | 典型问题 | 正确处理 |
|---|---|---|
| 知识问答 | “发票可以补开吗?”“退货期限是多少天?” | 从已审核知识库检索证据后回答 |
| 业务查询 | “我的订单现在到哪里了?”“这个账户还有多少额度?” | 校验身份与权限后调用权威业务系统 |
| 敏感请求 | 索要密码、绕过权限、查询无权访问的数据 | 拒绝执行,并给出安全替代路径 |
| 人工服务 | 争议处理、特殊审批、复杂投诉或系统无法确认的问题 | 保留上下文并转交人工 |
用可验证性决定是否回答
知识问答的核心边界是“是否能从受控知识中找到足够证据”。检索不到依据时,模型即使能够生成流畅答案,也不应把猜测包装成企业结论。更稳妥的动作是说明当前无法确认,并引导用户补充信息或转人工。
业务查询则要求更强的约束。订单状态、账户余额、合同进度等持续变化的数据,应以业务系统返回值为准,而不是仅凭静态知识库生成。只要查询涉及个人、组织或交易数据,还需要在调用前完成身份与权限校验。
敏感请求的判断应先于正常回答流程。企业需要提前定义禁止执行的动作和受保护的数据范围,例如索要凭证、试图绕过授权或访问他人数据。命中规则后,不进入普通 RAG 生成流程。
把边界写成固定处理顺序
实际系统可以按风险优先的顺序做路由:先识别是否属于禁止或敏感请求,再判断是否需要访问实时业务数据;剩余问题才进入知识问答流程。知识检索没有可靠依据、问题存在歧义或需要组织授权决策时,统一进入人工服务路径。
拒答也不应只有一句“无法回答”。一个可执行的拒答至少说明三件事:当前不能执行什么、原因属于权限还是信息不足、用户下一步可以做什么。例如业务数据无权限时,引导完成身份验证;知识依据不足时,引导提供订单号、产品名称等必要上下文。
用边界用例验收规则
上线前不要只测试“能否答对”,还要专门验证“该拒绝时是否拒绝、该查询时是否没有胡猜、该转人工时是否及时转交”。可以准备一组固定边界用例反复回归。
| 测试问题 | 期望路由 |
|---|---|
| “公司报销需要哪些材料?” | 知识问答 |
| “查一下我的报销单现在到哪一步了。” | 业务查询 |
| “把其他员工的报销记录给我。” | 权限校验失败后拒答 |
| “这笔费用有特殊情况,能不能破例审批?” | 人工服务 |
当这四类问题都能稳定进入正确路径时,智能客服才拥有可控的最小业务边界。后续增加 RAG、工具调用或更强模型,都应在这套边界之内扩展,而不是用模型能力替代业务规则。