
大模型应用开发 / 系统课时
搭建可替换模型的服务骨架
搭建可替换模型的服务骨架
这一节把“可替换”落到代码结构:API 只处理协议,领域服务只编排问答,检索器组合 Embedding 与向量存储,模型实现放在适配层。完成后,你会得到一个可直接运行的最小 HTTP 服务,并能在不改业务逻辑的前提下替换模型或向量库。
学习目标
- 建立 API、配置、模型客户端、检索器和领域服务之间的单向依赖。
- 用接口隔离对话模型、Embedding 与向量存储的具体实现。
- 运行最小服务并通过 HTTP 请求验证完整问答链路。
先固定依赖方向
推荐把调用方向固定为 API → KnowledgeQaService → Retriever / ChatModel → Adapter。配置只在程序装配位置读取,再把已经构造好的实现注入业务对象;领域服务不读取环境变量,也不导入任何供应商 SDK。
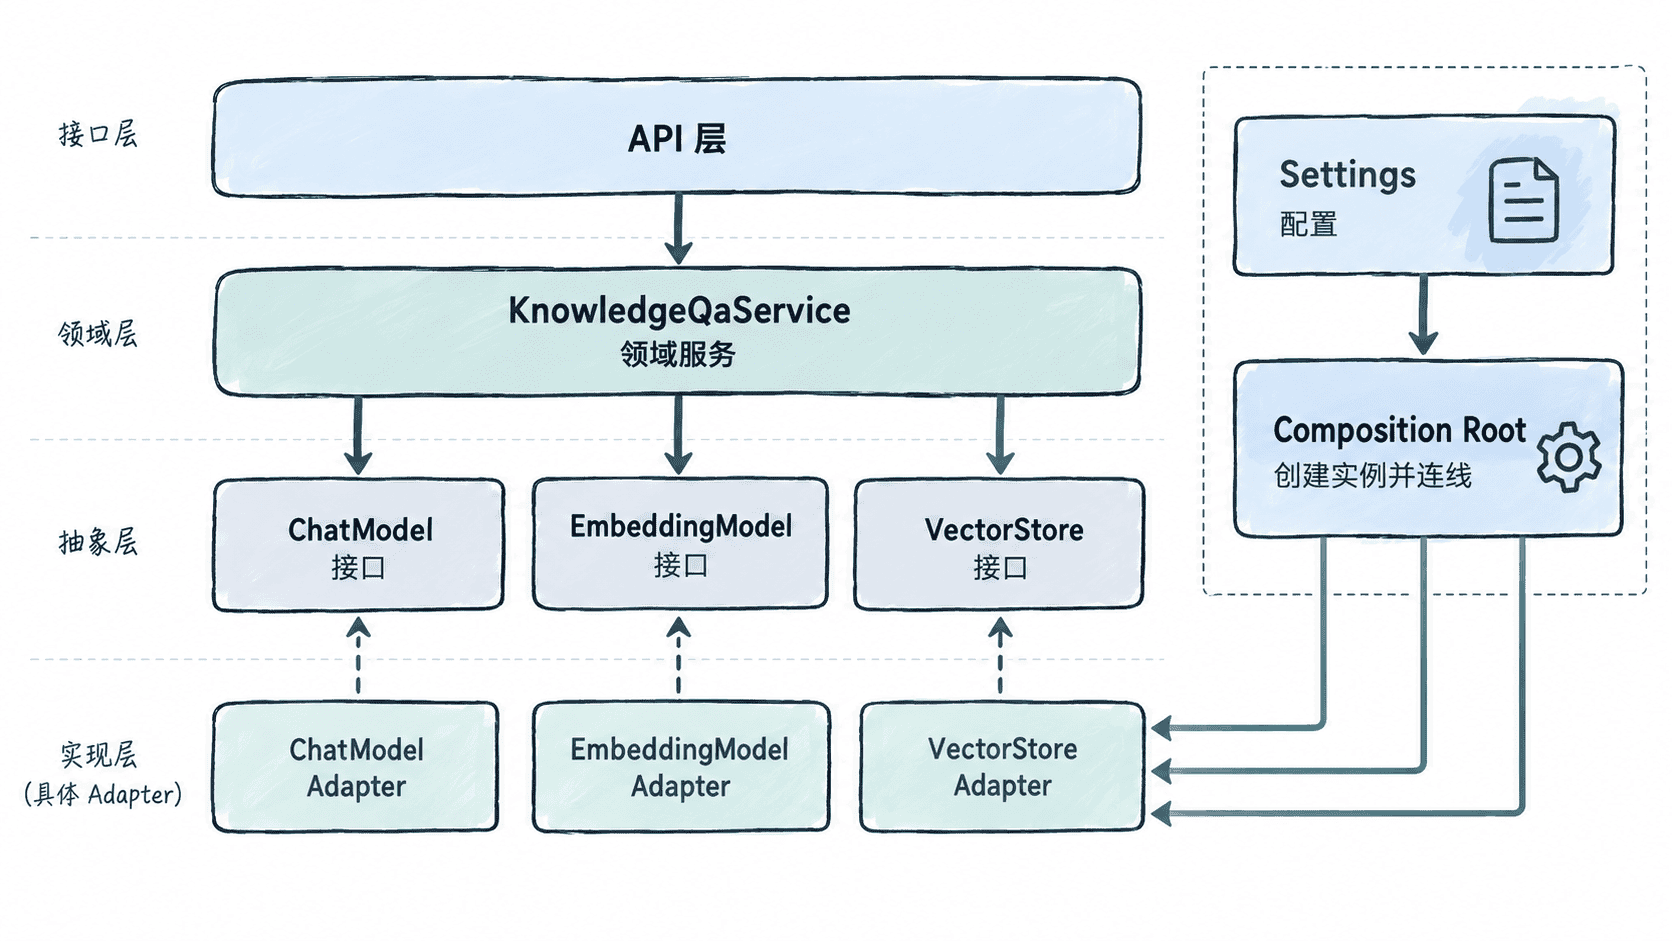
这样做的关键不是“多写几层”,而是让变化最快的外部依赖停在边缘。API 可以从 HTTP 换成消息队列,模型可以更换供应商,向量库可以迁移,而 KnowledgeQaService 的问答规则仍保持稳定。
用接口隔离外部实现
下面给出一个只依赖 Python 标准库的完整示例。DemoEmbeddingModel、InMemoryVectorStore 和 DemoChatModel 是演示适配器,生产环境只需要新增实现并在 build_service() 中装配,不应修改领域服务。
from __future__ import annotations

from dataclasses import dataclass
from http.server import BaseHTTPRequestHandler, HTTPServer
import json
import math
import os
from typing import Protocol

# 外部能力以业务需要的最小接口暴露,领域层只依赖这些契约。
class ChatModel(Protocol):
    def answer(self, question: str, contexts: list[str]) -> str:
        ...

class EmbeddingModel(Protocol):
    def embed(self, text: str) -> list[float]:
        ...

class VectorStore(Protocol):
    def search(self, vector: list[float], limit: int) -> list[str]:
        ...

# 配置只在装配阶段读取,避免业务对象直接访问进程环境。
@dataclass(frozen=True)
class Settings:
    port: int
    top_k: int
    chat_provider: str
    embedding_provider: str
    vector_provider: str

    @staticmethod
    def from_env() -> "Settings":
        return Settings(
            port=int(os.getenv("PORT", "8080")),
            top_k=int(os.getenv("TOP_K", "2")),
            chat_provider=os.getenv("CHAT_PROVIDER", "demo"),
            embedding_provider=os.getenv("EMBEDDING_PROVIDER", "demo"),
            vector_provider=os.getenv("VECTOR_PROVIDER", "memory"),
        )

class DemoEmbeddingModel:
    def embed(self, text: str) -> list[float]:
        # 用字符哈希构造稳定向量,只用于验证接口和调用链。
        vector = [0.0] * 64
        for char in text:
            vector[ord(char) % 64] += 1.0
        norm = math.sqrt(sum(value * value for value in vector)) or 1.0
        return [value / norm for value in vector]

# 真实向量库适配器也只需要保持相同的 search 契约。
class InMemoryVectorStore:
    def __init__(self, documents: list[str], embedder: EmbeddingModel):
        self._items = [(document, embedder.embed(document)) for document in documents]

    def search(self, vector: list[float], limit: int) -> list[str]:
        scored = []
        for document, doc_vector in self._items:
            score = sum(a * b for a, b in zip(vector, doc_vector))
            scored.append((score, document))
        scored.sort(reverse=True)
        return [document for _, document in scored[:limit]]

class DemoChatModel:
    def answer(self, question: str, contexts: list[str]) -> str:
        if not contexts:
            return "未检索到可用知识。"
        return f"基于知识库:{contexts[0]}"

class Retriever:
    def __init__(self, embedder: EmbeddingModel, store: VectorStore, top_k: int):
        self._embedder = embedder
        self._store = store
        self._top_k = top_k

    def retrieve(self, question: str) -> list[str]:
        return self._store.search(self._embedder.embed(question), self._top_k)

class KnowledgeQaService:
    def __init__(self, retriever: Retriever, chat_model: ChatModel):
        self._retriever = retriever
        self._chat_model = chat_model

    def ask(self, question: str) -> dict[str, object]:
        contexts = self._retriever.retrieve(question)
        return {
            "answer": self._chat_model.answer(question, contexts),
            "sources": len(contexts),
        }

def build_service(settings: Settings) -> KnowledgeQaService:
    # 供应商选择只发生在装配入口,领域服务不感知具体实现。
    if settings.embedding_provider != "demo" or settings.vector_provider != "memory":
        raise ValueError("demo 仅支持 EMBEDDING_PROVIDER=demo 和 VECTOR_PROVIDER=memory")
    if settings.chat_provider != "demo":
        raise ValueError("demo 仅支持 CHAT_PROVIDER=demo")

    embedder = DemoEmbeddingModel()
    documents = [
        "退款政策:企业版订单在付款后 7 天内可申请退款。",
        "支持时间:工作日 09:00-18:00 提供人工支持。",
    ]
    store = InMemoryVectorStore(documents, embedder)
    retriever = Retriever(embedder, store, settings.top_k)
    return KnowledgeQaService(retriever, DemoChatModel())

# HTTP 层只负责协议解析与响应序列化,不承担检索逻辑。
class AskHandler(BaseHTTPRequestHandler):
    service: KnowledgeQaService

    def do_POST(self) -> None:
        if self.path != "/ask":
            self.send_error(404)
            return

        length = int(self.headers.get("Content-Length", "0"))
        payload = json.loads(self.rfile.read(length))
        question = str(payload.get("question", "")).strip()
        if not question:
            self.send_error(400, "question is required")
            return

        body = json.dumps(self.service.ask(question), ensure_ascii=False).encode("utf-8")
        self.send_response(200)
        self.send_header("Content-Type", "application/json; charset=utf-8")
        self.send_header("Content-Length", str(len(body)))
        self.end_headers()
        self.wfile.write(body)

    def log_message(self, format: str, *args: object) -> None:
        pass

if __name__ == "__main__":
    settings = Settings.from_env()
    AskHandler.service = build_service(settings)
    print(f"server listening on http://127.0.0.1:{settings.port}", flush=True)
    HTTPServer(("127.0.0.1", settings.port), AskHandler).serve_forever()
预期结果:保存为 app.py 后,默认配置会构造一套演示实现并提供 POST /ask;实际运行时端口可由 PORT 环境变量覆盖。
运行并验证最小闭环
启动服务:
python app.py预期输出:
server listening on http://127.0.0.1:8080进程保持运行时,在另一个终端发送请求:
curl -s -X POST http://127.0.0.1:8080/ask -H "Content-Type: application/json" -d '{"question":"退款期限"}'预期输出:
{"answer": "基于知识库:退款政策:企业版订单在付款后 7 天内可申请退款。", "sources": 2}这个结果验证了 API、领域服务、检索器、Embedding、向量存储和对话模型已经串成闭环。演示向量仅用于验证结构,不能替代真实语义 Embedding。
替换实现时只改装配入口
接入真实模型时,为 ChatModel 或 EmbeddingModel 新增适配器;迁移向量库时,实现同样的 search() 契约。鉴权、超时、重试、批量请求和供应商字段都应留在这些适配器中,不要向上泄漏。
服务骨架是否真正可替换,可以用一个简单标准检查:更换任意一个模型或向量库时,KnowledgeQaService 和 HTTP 处理代码都不需要修改,只需要替换适配器与装配配置。