
大模型应用开发 / 系统课时
用元数据过滤缩小候选范围
用元数据过滤缩小候选范围
高相关不等于可展示。企业知识库还必须考虑租户、用户角色、产品线、地区、语言和文档状态。本节把这些上下文编译成检索过滤条件,让无权限、过期或不适用的文档在进入重排和生成之前就被排除。
学习目标
- 区分相关性条件与访问控制、业务适用性条件。
- 根据用户上下文构造可执行的元数据过滤逻辑。
- 处理缺省字段、多值字段和文档状态等常见边界。
过滤为什么要早于重排
如果先把所有文档召回并重排,再在最后一步删除不可见内容,系统已经浪费了重排成本,还可能让无权限文档参与分数竞争、日志记录甚至提示词拼接。更安全的做法是尽可能在检索查询阶段应用元数据过滤,并确保任何候选在进入重排前都通过权限与状态检查。
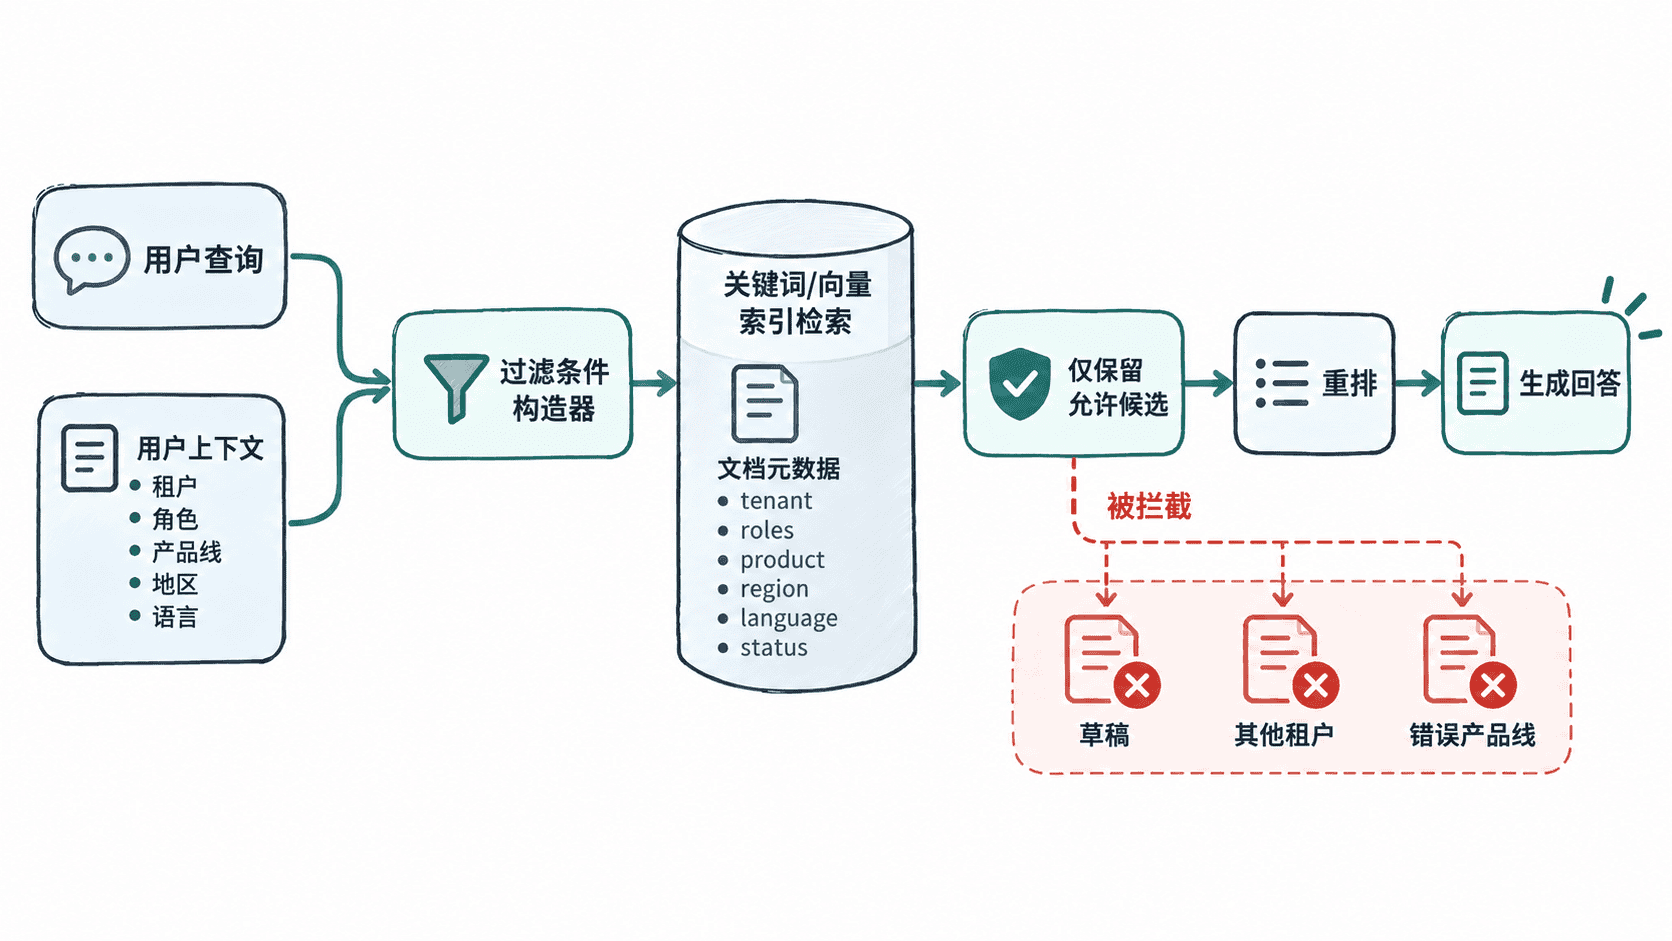
这里有两类条件。租户、角色和文档状态通常属于硬约束,不能因为相关性高就放宽;产品线、地区和语言也常是硬约束,但可以按业务规则设计明确的回退,例如地区允许 GLOBAL,语言允许在没有本地化文档时回退到英文。回退必须显式定义,不能靠检索器“猜”。
把上下文编译成过滤条件
过滤器应从可信的服务端上下文生成,而不是直接相信用户在问题里声称的身份。一个常见规则是:租户必须相等,产品必须属于用户可访问集合,地区和语言符合当前会话,状态必须是已发布,并且文档允许角色与用户角色至少有一个交集。
下面用可运行的 Python 示例模拟这条过滤逻辑。真实向量库或搜索引擎中,应把等价条件下推到查询过滤器,并在服务端保留同样的授权校验。
user = {
    "tenant": "acme",
    "products": {"router-x"},
    "region": "MY",
    "language": "zh-CN",
    "roles": {"support-agent"},
}

docs = [
    {"id": "kb-001", "tenant": "acme", "product": "router-x", "region": "MY", "language": "zh-CN", "status": "published", "roles": {"support-agent", "admin"}},
    {"id": "kb-002", "tenant": "acme", "product": "router-x", "region": "MY", "language": "zh-CN", "status": "draft", "roles": {"support-agent"}},
    {"id": "kb-003", "tenant": "beta", "product": "router-x", "region": "MY", "language": "zh-CN", "status": "published", "roles": {"support-agent"}},
    {"id": "kb-004", "tenant": "acme", "product": "router-y", "region": "MY", "language": "zh-CN", "status": "published", "roles": {"support-agent"}},
]

def visible(doc, ctx):
    return (
        doc["tenant"] == ctx["tenant"]
        and doc["product"] in ctx["products"]
        and doc["region"] == ctx["region"]
        and doc["language"] == ctx["language"]
        and doc["status"] == "published"
        and bool(doc["roles"] & ctx["roles"])
    )

print([doc["id"] for doc in docs if visible(doc, user)])
预期输出
['kb-001']kb-002 因为仍是草稿被排除,kb-003 属于其他租户,kb-004 属于未授权产品线。即使这些文档与查询文本高度相似,也不应该进入后续重排候选。
处理缺省字段和多值字段
权限相关字段建议采用“默认拒绝”。例如文档缺少 tenant、roles 或 status 时,不要自动解释成“所有人可见”;先阻止进入线上索引,或在查询侧明确过滤掉。这样能避免数据生产链路漏字段时意外扩大可见范围。
多值字段要明确集合语义。roles 常用“存在交集即可访问”,而 products 可能要求文档产品属于用户授权集合;地区则可能支持 {MY, GLOBAL} 这样的允许集合。不同字段的逻辑不能统一写成简单字符串相等。
上线前验证过滤没有泄漏
测试集要包含“高相关但必须拒绝”的反例,例如其他租户的同名产品文档、已下线版本、草稿和仅管理员可见的故障手册。对这些查询,验收标准不是“排得靠后”,而是它们根本不能进入重排候选。
日志中可以记录过滤前候选数、过滤后候选数和拒绝原因类别,但不要把无权限文档正文写入普通业务日志。最终应能回答两个问题:为什么某篇文档被允许进入候选,以及为什么另一篇被拒绝;只有这样,相关性优化和权限边界才能同时保持稳定。