
大模型应用开发 / 系统课时
排查知识更新后答案仍旧
排查知识更新后答案仍旧
文档明明已经修改,客服却继续回答旧内容时,不要直接重建整个知识库。最有效的做法是沿着“源内容→增量任务→索引→缓存→会话状态”逐层比对同一版本标识,找到第一个仍停留在旧版本的环节,再只刷新这一层及其下游。
学习目标
- 用内容指纹判断新文档是否真的进入增量链路。
- 按顺序检查增量任务、索引、缓存键和旧会话摘要,定位刷新断点。
- 设计一次可重复的端到端验证,确认修复后新答案稳定生效。
从请求链定位刷新断点
“答案仍旧”不是单一故障,而是一条链上任意一层仍保存旧状态。排查时先为新内容计算稳定指纹,例如对标准化后的正文计算 SHA-256,并让摄取记录、索引元数据和缓存元数据都携带这个指纹。这样每一层都能回答同一个问题:你现在服务的是哪个版本?
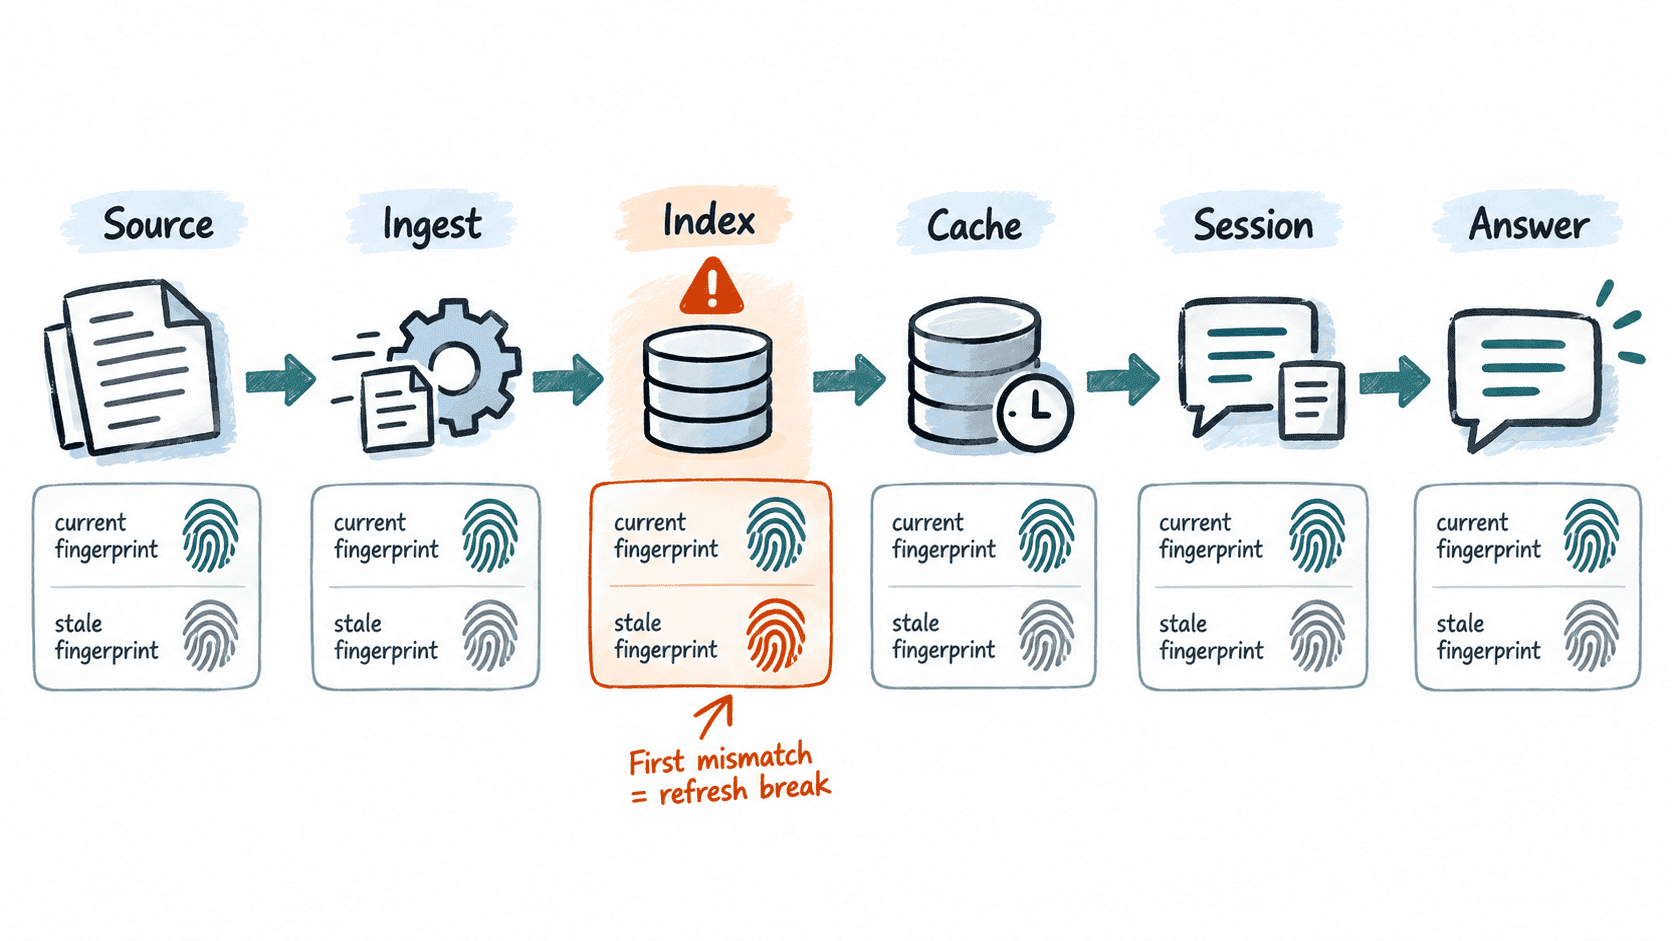
优先找“第一个旧层”,而不是从最终答案倒推。若源内容指纹已经是新值,但摄取记录还是旧值,问题在增量任务;若摄取和索引一致,而命中缓存的条目仍绑定旧指纹,问题就在缓存失效策略。这样可以避免把正常索引反复重建。
用内容指纹确认源内容
先确认用于入库的内容是否真的是用户刚修改的版本。常见误区包括读取了旧对象存储版本、抽取器仍使用旧附件、正文标准化后被错误去重,或者更新只改了标题而正文指纹没有变化。
下面的可运行脚本模拟一次分层诊断。实际系统中可把这些字段替换为日志、任务表或调试接口返回的真实值。
trace = {
    'expected': 'fp-new',
    'ingest': 'fp-new',
    'index': 'fp-old',
    'cache': 'fp-old',
    'session_has_old_summary': True,
}

layers = ['ingest', 'index', 'cache']
for layer in layers:
    if trace[layer] != trace['expected']:
        print(f'first_stale_layer={layer}')
        break
else:
    print('first_stale_layer=none')

print(f"session_has_old_summary={trace['session_has_old_summary']}")
预期输出
first_stale_layer=index
session_has_old_summary=True
这个结果表示增量摄取已经拿到新内容,但索引仍是旧版本;即使随后清空缓存,也只能让系统重新查询旧索引,所以应先修复索引更新,再处理缓存和会话状态。
检查增量任务与索引状态
增量任务至少要核对四件事:是否收到更新事件、是否成功完成抽取与切分、是否写入目标索引、是否把新版本标记为可查询。只看到“任务成功”还不够,因为任务可能成功处理了零条记录,或写入了另一个环境、租户、索引别名。
索引侧则重点比较文档 ID、分块 ID、内容指纹和可见版本。若新旧分块并存,要确认检索过滤条件会排除旧版本;若采用异步刷新,还要区分“写入成功”和“搜索可见”两个时刻。必要时直接用文档 ID 查询索引元数据,而不是只看客服最终回答。
排除缓存和旧会话摘要
索引已经是新版本,但答案仍旧时,下一步看缓存键是否包含知识版本。若缓存只按“用户问题”生成键,相同问题可能长期命中旧答案。更稳妥的键至少要纳入知识库版本、租户和重要检索配置;知识更新后,也可以按文档版本定向失效,而不是粗暴清空全部缓存。
还要区分答案缓存和会话记忆。长对话里,系统可能把早期旧答案压缩进会话摘要;即使当前检索拿到新证据,模型仍会同时看到旧摘要。诊断时应新建无历史会话重复同一问题。若新会话正确、旧会话错误,问题就不在索引,而在会话摘要刷新或冲突信息优先级。
用一次端到端验证收口
修复后不要只验证“后台已经更新”,而要从用户入口做一次完整回归:先记录新文档指纹,再确认增量任务、索引和缓存都指向同一版本;随后分别在新会话和旧会话中提问,并记录本次检索命中的文档版本。若旧会话仍携带过期摘要,应清理或重算摘要后再次验证。
最终的闭环标准不是“某个组件状态正常”,而是同一次请求中的源内容、索引证据、缓存版本和会话上下文都指向新版本,且客服答案引用的新事实可以稳定复现。