
PostgreSQL / 系统课时
表文件与数据页
表文件与数据页
这一课把“表”从 SQL 对象落到磁盘与页面:你会看到堆表如何对应关系文件、一个页面内部如何分配空间,以及 ctid 为什么能用“块号 + 行指针序号”定位某个行版本。
学习目标
- 说清堆表 main、FSM、VM 等关系文件与数据页的职责边界。
- 读懂堆页中的页头、行指针、空闲区和元组数据布局。
- 用
pg_relation_filepath()、block_size与ctid验证物理位置。
从表对象到关系文件
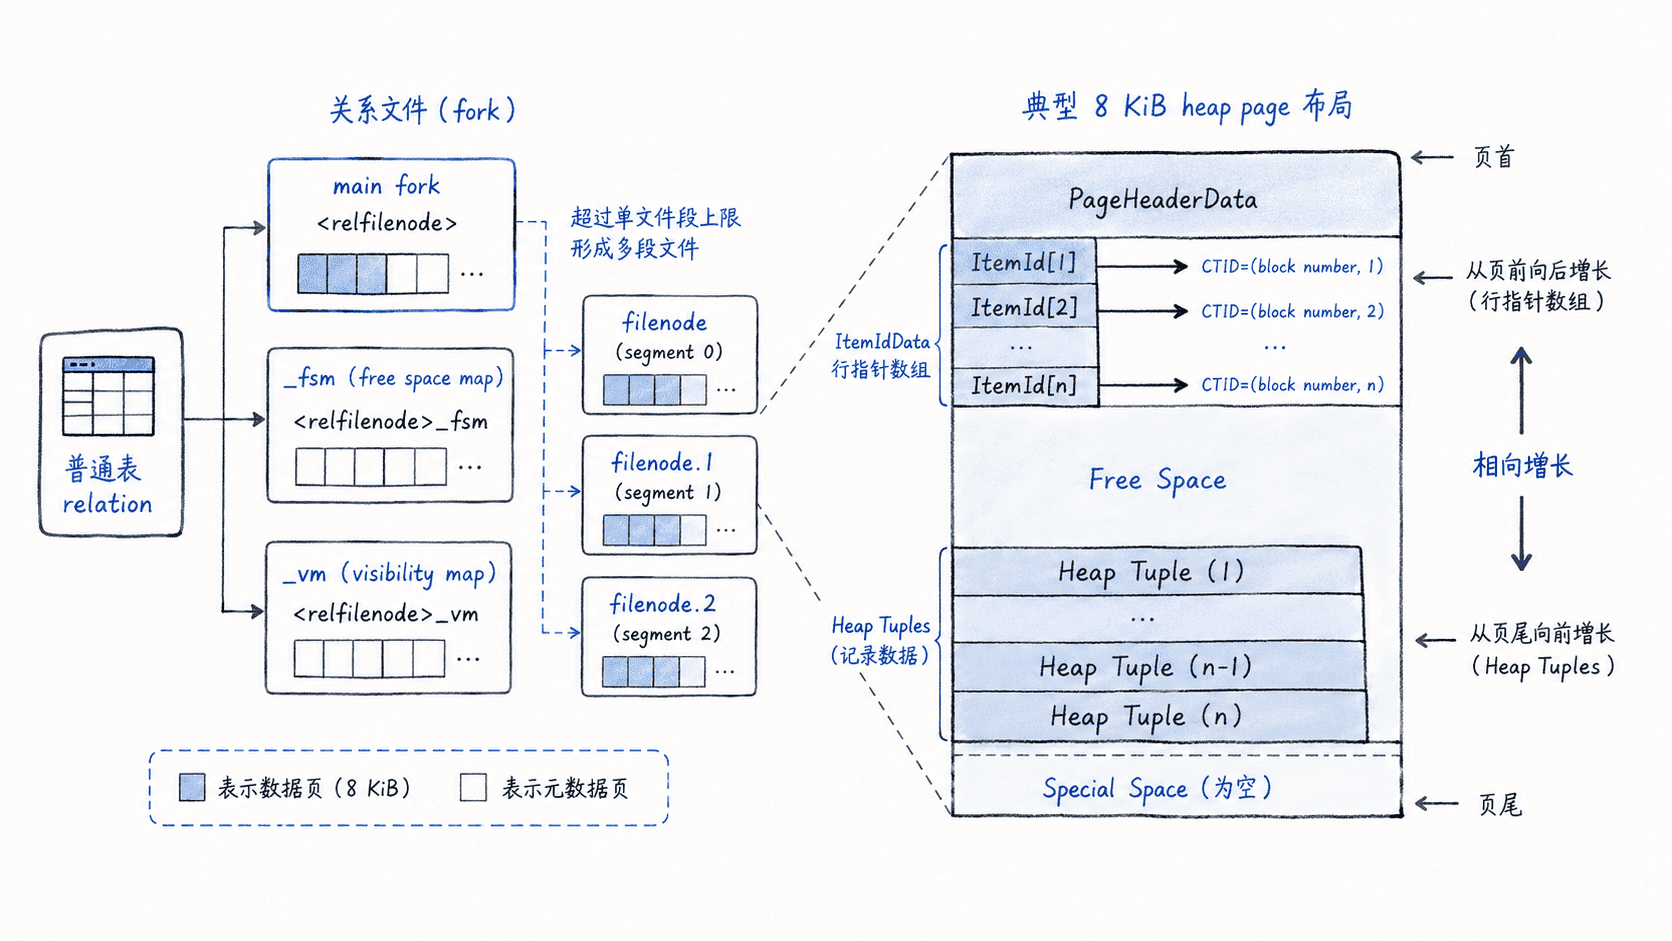
PostgreSQL 的普通表默认使用 heap 访问方法。表在系统目录中是一个 relation,实际存储由 filenode 对应到文件;因此表的 OID 与当前 filenode 不应被当成同一个概念。TRUNCATE、CLUSTER 等操作可能在逻辑对象不变时替换 filenode。
一个堆表至少关注三类 fork:main fork 保存真实堆页,FSM 记录各页可用空间,VM 记录页面是否 all-visible、all-frozen 等可见性状态。未记录表还会有初始化 fork。main fork 足够大时会继续拆成 .1、.2 等文件段,所以“一个表”并不等于“一个操作系统文件”。
数据页内部如何排列
常见构建使用 8 KiB 页面。普通 heap 页可理解为四个主要区域:固定页头、行指针数组、中央空闲空间和从页尾向前增长的元组区;heap 页的 special space 通常为空。页头保存 LSN、校验相关字段以及 pd_lower、pd_upper、pd_special 等边界。
行指针不是“行内容”,而是指向页内元组的短条目。新增行指针从页前部向后增长,元组数据从页尾向前增长,两者之间就是可分配空闲空间。这样 PostgreSQL 可以在页内整理元组位置,而索引仍通过块号和行指针序号定位条目。
用 SQL 观察文件与 CTID
下面在当前会话创建一张临时堆表。它足够小,三行通常都会落在第 0 号数据块;ctid 的第二个数字就是该块中的行指针序号。
CREATE TEMP TABLE heap_page_demo (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    payload text NOT NULL
);

INSERT INTO heap_page_demo (payload)
VALUES ('alpha'), ('beta'), ('gamma');

SELECT current_setting('block_size') AS block_size,
       pg_relation_filepath('heap_page_demo') AS relative_path;

SELECT ctid, id, payload
FROM heap_page_demo
ORDER BY ctid;
预期结果
CREATE TABLE
INSERT 0 3
 block_size | relative_path
------------+----------------
 <VALUE>    | <PATH>

 ctid  | id | payload
-------+----+---------
 (0,1) |  1 | alpha
 (0,2) |  2 | beta
 (0,3) |  3 | gamma
<VALUE> 由服务器编译时页面大小决定,常见值为 8192;<PATH> 是相对 PGDATA 的实际关系路径,临时表还会带会话相关命名。若表持续增长,ctid 的块号会变成 1、2、3 等更大的页号。
行指针为什么重要
ctid=(0,2) 不表示“第 2 行业务数据”,而表示“第 0 块中的第 2 个 item slot”。索引项保存的也是这种物理 TID,而不是元组在页中的绝对字节偏移。页内清理或压缩可以移动元组内容,只要相应行指针仍能正确指向它即可。
这也解释了为什么 ctid 适合诊断物理布局,却不适合作为业务主键:UPDATE 会创建新行版本并通常获得新的 ctid,VACUUM FULL 等重写操作也会改变物理位置。把 relation 文件、page、line pointer 和 tuple 这四层关系连起来,才能继续理解 HOT 更新、可见性图和索引指向的真正对象。