
PostgreSQL / 系统课时
共享内存与缓存
共享内存与缓存
PostgreSQL 读取和修改数据时会同时依赖数据库自身的共享缓冲区、WAL 缓冲区以及操作系统文件缓存。把这三者的职责和数据流分清,才能正确理解缓存命中、写盘时机,以及为什么“内存越大”不等于简单把 shared_buffers 调到最大。
学习目标
- 区分
shared_buffers、WAL buffers 与操作系统页缓存的职责。 - 理解数据页读取、脏页写回和 WAL 先行写入之间的协作关系。
- 能用 PostgreSQL 自带视图和
EXPLAIN ... BUFFERS验证缓存行为。
三类缓存分别缓存什么
shared_buffers 是 PostgreSQL 共享内存中的数据页缓存。后端进程读取表或索引页时,会先检查目标页是否已经在共享缓冲区;命中时可以直接使用,未命中时才需要从文件系统读取页面。
WAL buffers 用来暂存已经生成、但尚未写入 WAL 文件的日志记录。事务修改数据页时,必须先产生对应 WAL 记录;在需要保证持久性时,相关 WAL 必须先落到持久存储,再允许对应脏数据页安全写回,这就是 WAL 的“先日志、后数据”原则。
操作系统页缓存位于 PostgreSQL 之外。即使某个数据页没有命中 shared_buffers,对数据文件的读取仍可能命中 OS page cache,因此一次 PostgreSQL 层面的 shared read 并不一定等于一次真实磁盘随机 I/O。
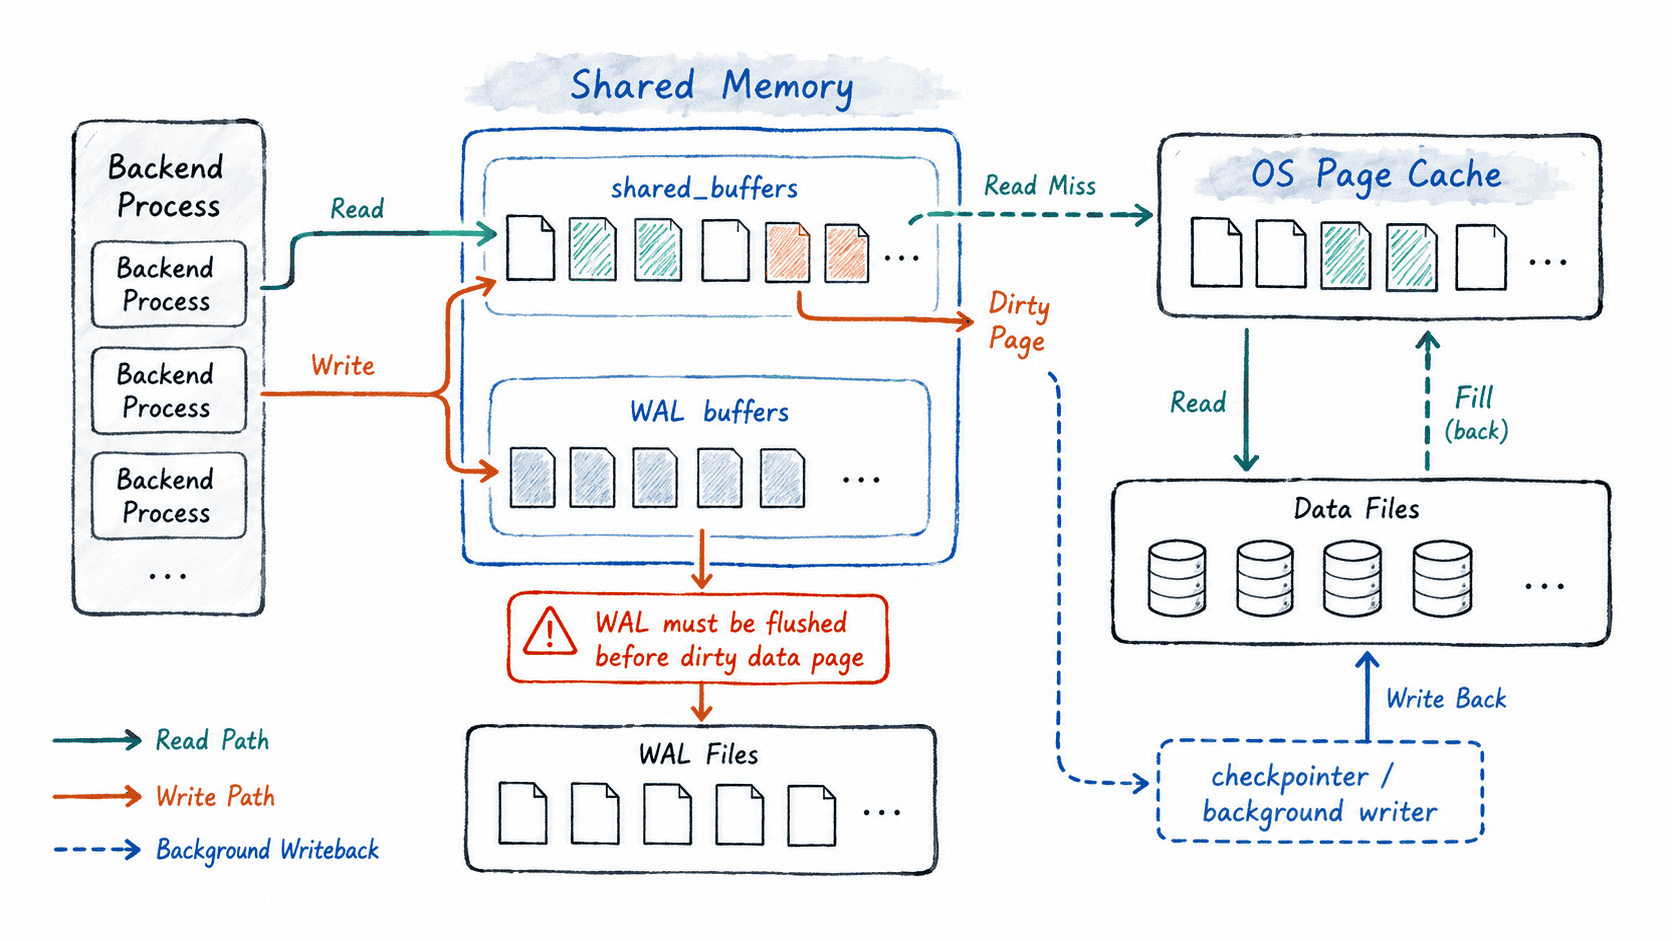
一次读取和一次更新如何流动
读取数据页时,后端首先在 shared_buffers 中查找。如果没有命中,PostgreSQL 发起文件读取;操作系统可能直接从页缓存返回,也可能真正访问存储设备。拿到的数据页随后进入 shared_buffers,供当前和后续后端共享使用。
更新数据时,后端通常先修改 shared_buffers 中的数据页,把它标记为脏页,同时生成 WAL 记录进入 WAL buffers。事务提交需要持久化时,WAL 先被刷入 WAL 文件;脏数据页则可以稍后由 checkpointer、background writer 或必要时由后端写回数据文件。
查看缓存相关配置
下面的 SQL 直接读取当前实例的关键配置值。
SELECT name, setting, unit
FROM pg_settings
WHERE name IN ('shared_buffers', 'wal_buffers', 'effective_cache_size')
ORDER BY name;
预期结果
         name         | setting | unit
----------------------+---------+------
 effective_cache_size | <VALUE> | 8kB
 shared_buffers       | <VALUE> | 8kB
 wal_buffers          | <VALUE> | 8kB
<VALUE> 取决于实例配置。effective_cache_size 不是一块实际分配的缓存,它只是优化器用于估计可用于查询的数据缓存规模,通常用于反映 PostgreSQL 与操作系统缓存的综合效果。
用 BUFFERS 观察共享缓冲区命中
对系统目录执行同一条查询两次,可以观察共享缓冲区访问情况。第一次可能包含读取,后续再次访问时更容易出现更多 shared hit。
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF, TIMING OFF, SUMMARY OFF)
SELECT count(*)
FROM pg_catalog.pg_class;
预期结果
Aggregate
  Buffers: shared hit=<VALUE>
  ->  Seq Scan on pg_class
        Buffers: shared hit=<VALUE>
如果执行时仍需从文件系统取得页面,输出还会出现 read=<VALUE>;具体计数取决于版本、并发和当前缓存热度。这里的 hit 表示命中 PostgreSQL 共享缓冲区,而 read 只表示 PostgreSQL 发起了读取,不能据此断言发生了物理磁盘 I/O。
调优时应看协作而不是单个参数
shared_buffers 太小会让常用数据页频繁被替换,但设置过大也可能挤压操作系统页缓存和其他内存需求。WAL buffers 通常由 PostgreSQL 自动选择即可,只有极高 WAL 生成速率等场景才值得单独验证。
真正的调优顺序是先确认工作集、缓存命中与 I/O 压力,再结合总内存、连接数、排序和哈希操作的内存需求评估参数。数据库缓存与 OS 缓存是协作关系,不是二选一;理解这一点后,才能避免用“把缓存参数调满”替代实际的性能分析。