
PostgreSQL / 系统课时
复制延迟诊断
复制延迟诊断
复制“慢”并不等于网络慢。PostgreSQL 流复制从主库生成 WAL,到发送、备库接收写入、刷盘,再到恢复进程重放,任一阶段都可能形成积压。本课用 LSN 差值把延迟拆成可定位的五段,并给出从指标到根因的排查顺序。
学习目标
- 能用
pg_stat_replication区分发送、传输/写入、刷盘和重放阶段的积压 - 能把 LSN 字节差与时间延迟结合起来判断瓶颈位置
- 能按固定顺序验证网络、磁盘、恢复进程和长查询等常见根因
先把复制链路拆开
主库当前 WAL 位置不断向前推进,WAL sender 把数据发送给备库;备库 walreceiver 收到后先写入 WAL 文件,再刷到持久化存储,最后 startup/recovery 进程把 WAL 重放到数据页。延迟诊断的关键不是只看一个“秒数”,而是比较这些位置之间的距离。
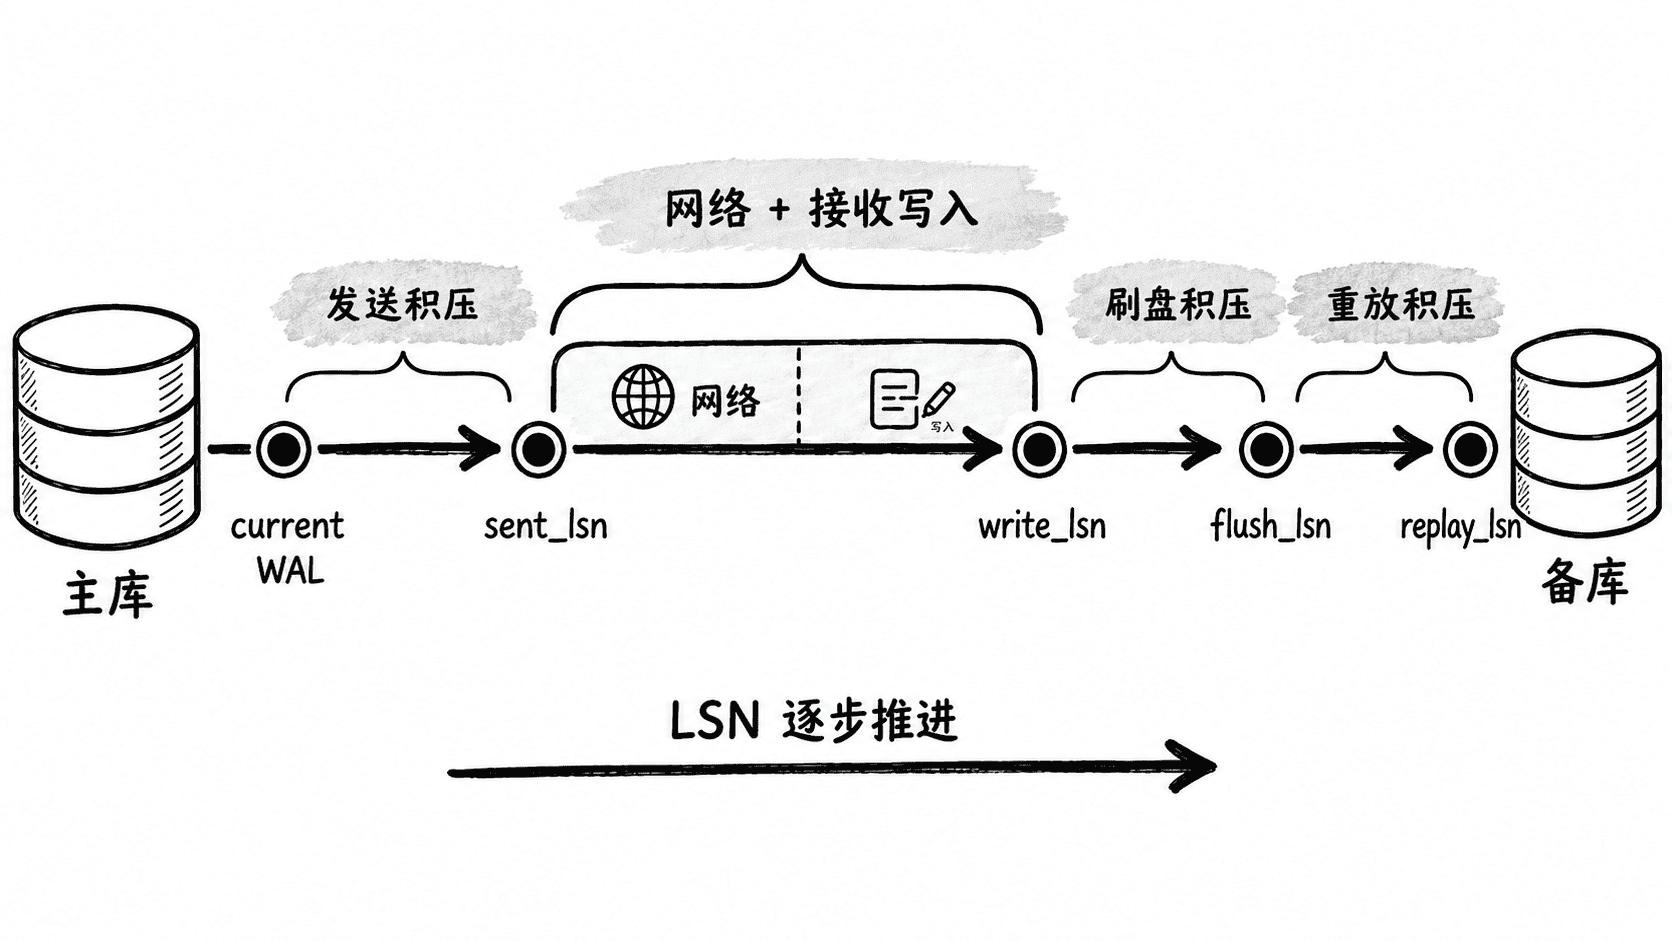
在主库执行下面的查询,可以一次看到每个复制连接的四段可观测字节差。需要注意,PostgreSQL 不单独暴露“已经到达备库内存、但尚未写 WAL 文件”的 LSN,因此 sent_lsn 到 write_lsn 只能先视为“网络 + 接收写入”组合区间;若这一段异常,再用网络与备库磁盘证据把两者拆开。
SELECT
    application_name,
    client_addr,
    state,
    sync_state,
    pg_size_pretty(
        GREATEST(pg_wal_lsn_diff(pg_current_wal_lsn(), sent_lsn), 0)::bigint
    ) AS send_backlog,
    pg_size_pretty(
        GREATEST(pg_wal_lsn_diff(sent_lsn, write_lsn), 0)::bigint
    ) AS transport_write_backlog,
    pg_size_pretty(
        GREATEST(pg_wal_lsn_diff(write_lsn, flush_lsn), 0)::bigint
    ) AS flush_backlog,
    pg_size_pretty(
        GREATEST(pg_wal_lsn_diff(flush_lsn, replay_lsn), 0)::bigint
    ) AS replay_backlog,
    write_lag,
    flush_lag,
    replay_lag
FROM pg_stat_replication
ORDER BY application_name;
预期结果
 application_name | client_addr | state     | sync_state | send_backlog | transport_write_backlog | flush_backlog | replay_backlog | write_lag | flush_lag | replay_lag
------------------+-------------+-----------+------------+--------------+-------------------------+---------------+----------------+-----------+-----------+-----------
 standby_a        | <IP>        | streaming | async      | <VALUE>      | <VALUE>                 | <VALUE>       | <VALUE>        | <VALUE>   | <VALUE>   | <VALUE>
实际数值会随写入压力和采样时刻变化。重点看哪个 backlog 持续增长,而不是某次瞬时值。
用位置差判断瓶颈在哪
send_backlog 大,说明主库已经产生 WAL,但 sender 还没有把对应位置发送出去。优先检查 sender 是否被 CPU、主库 I/O、复制带宽或连接状态限制,并观察 state 是否仍为 streaming。
transport_write_backlog 大,说明主库已发送,但备库尚未报告写入 WAL 文件。此时先看网络吞吐、丢包、连接抖动与消息接收是否异常;网络健康而差值仍扩大,再检查 walreceiver 调度和 WAL 所在磁盘的写延迟。这样才能把“网络慢”和“备库写入慢”从同一个 LSN 区间中进一步区分。
flush_backlog 大,说明 WAL 已写入操作系统缓存,但持久化落盘跟不上。此时应重点检查备库磁盘延迟、fsync 压力和存储抖动,而不是继续把注意力放在网络上。
replay_backlog 大,说明 WAL 已经安全到达并刷盘,但恢复进程没有及时应用。常见原因是备库 CPU/I/O 不足、需要重放大量数据修改,或查询与恢复发生冲突。热备查询可能因为冲突等待或被取消,具体行为还受 max_standby_streaming_delay 等参数影响。
在备库确认接收和重放状态
当主库只能看见“对端报告到哪里”时,可以登录备库直接比较已接收和已重放位置,并估算最后一次事务重放距当前时间多久。
SELECT
    pg_is_in_recovery() AS in_recovery,
    pg_last_wal_receive_lsn() AS receive_lsn,
    pg_last_wal_replay_lsn() AS replay_lsn,
    pg_size_pretty(
        GREATEST(
            pg_wal_lsn_diff(pg_last_wal_receive_lsn(), pg_last_wal_replay_lsn()),
            0
        )::bigint
    ) AS receive_replay_gap,
    now() - pg_last_xact_replay_timestamp() AS replay_time_gap;
预期结果
 in_recovery | receive_lsn | replay_lsn | receive_replay_gap | replay_time_gap
-------------+-------------+------------+--------------------+-----------------
 t           | <VALUE>     | <VALUE>    | <VALUE>            | <VALUE>
receive_replay_gap 持续扩大,基本可以确认瓶颈在备库重放侧。replay_time_gap 需要谨慎解释:如果主库长时间没有事务提交,它也会自然变大,因此不能单独作为复制故障证据。
按固定顺序排查
先确认复制连接是否仍为 streaming,以及积压是否持续增长;连接中断时,先处理认证、网络和 WAL 可用性问题。连接正常后,再按发送、传输/写入、刷盘、重放的顺序观察最大差值,避免同时排查所有组件。
如果传输/写入阶段增长,结合网络吞吐、丢包和备库 WAL 盘写延迟验证;如果刷盘阶段增长,重点看存储延迟和饱和度;如果重放阶段增长,则检查备库 CPU、数据盘 I/O、长查询与恢复冲突。修复后再次执行同一查询,确认对应 backlog 能持续下降而不是只短暂归零。
复制延迟真正可操作的指标不是“备库慢了多少秒”,而是“WAL 卡在哪一个 LSN 区间”。只要先确定积压阶段,再去查对应资源,诊断范围就能从整套数据库系统缩小到一个明确环节。