
PostgreSQL / 系统课时
RPO、RTO 与备份设计
RPO、RTO 与备份设计
备份设计的起点不是“每天备一次”或“保留七天”,而是先量化允许丢多少数据、多久必须恢复服务。本节会把 RPO、RTO 转成可验证指标,再据此组合基础备份、WAL 归档、备用节点与恢复演练。
学习目标
- 能用 RPO 和 RTO 表达业务恢复目标
- 能根据数据规模与恢复窗口选择备份组合
- 能通过备份校验和恢复演练验证设计是否达标
先把目标写成可验证指标
RPO 表示故障后最多允许回退多远,也就是可接受的数据丢失时间窗口;RTO 表示从故障发生到关键服务恢复可用的最长时间。两者都必须由业务确认,不能由 DBA 单方面用“每天备份一次”代替。
例如,业务要求 RPO 不超过 5 分钟、RTO 不超过 60 分钟,就意味着仅靠每日全量备份一定不够:它的最坏数据缺口接近 24 小时。要把 RPO 压到分钟级,通常需要持续归档 WAL;要把 RTO 压低,则还要控制备份恢复、WAL 重放、切流和验证所需的总时间。
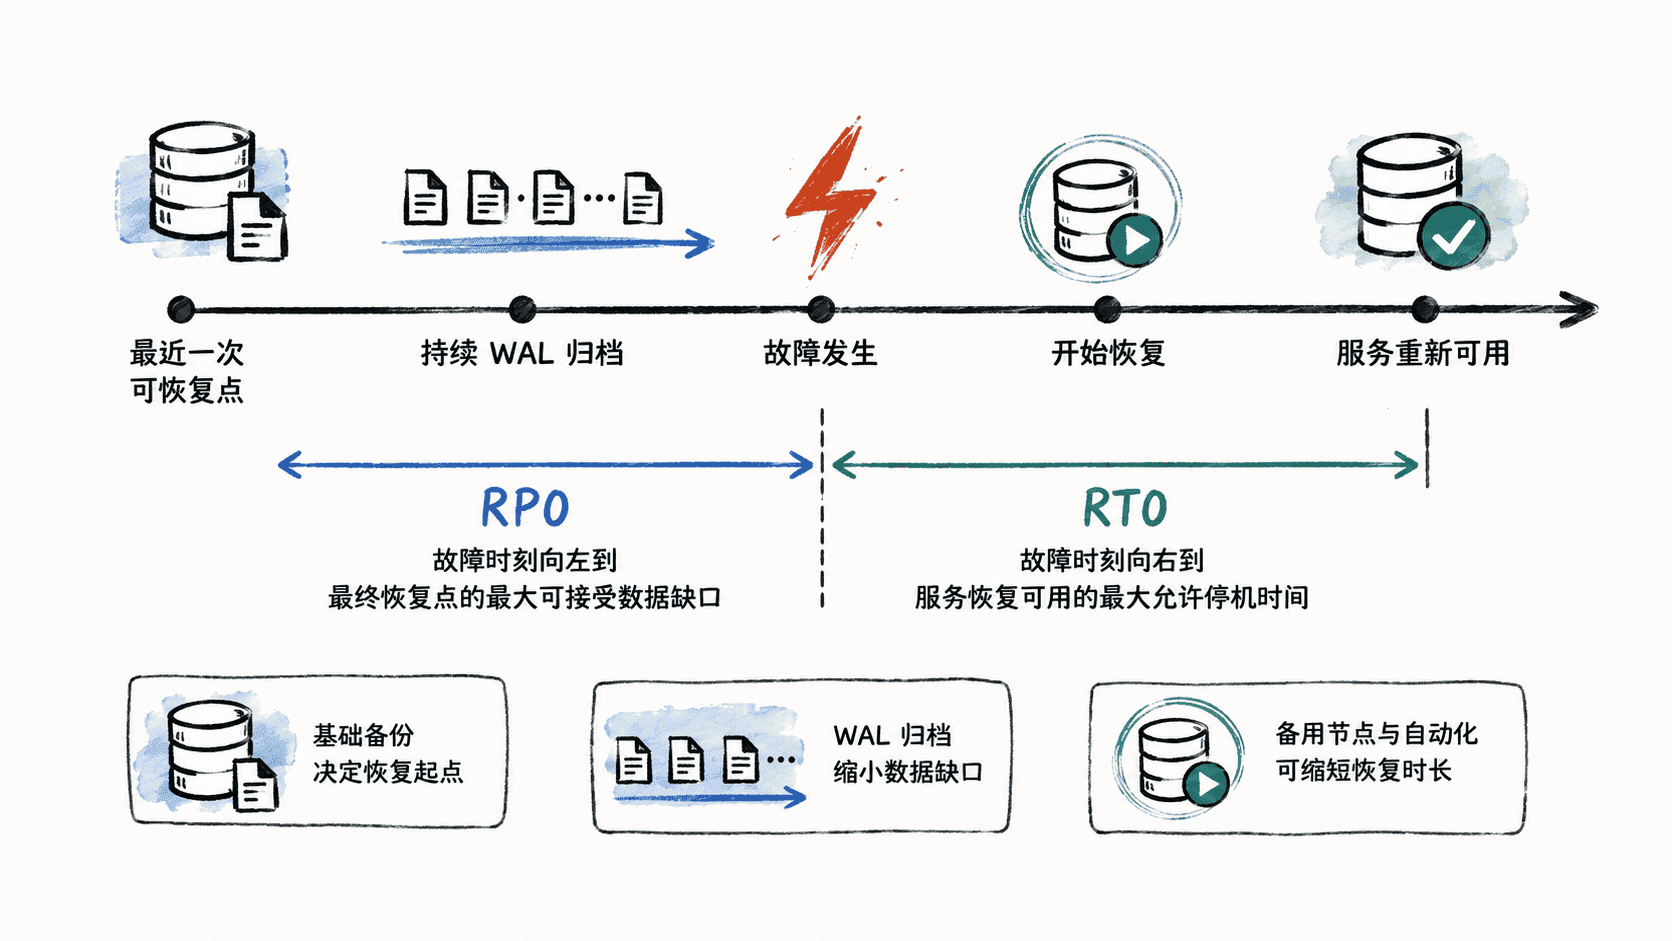
用目标反推备份组合
不同手段解决的问题不同,不能把它们互相替代。
| 手段 | 主要价值 | 对 RPO 的作用 | 对 RTO 的作用 |
|---|---|---|---|
pg_dump 逻辑备份 |
对象级恢复、迁移、长期留档 | 取决于执行频率 | 大库恢复通常较慢 |
pg_basebackup 物理基础备份 |
建立完整物理恢复基线 | 单独使用时取决于备份频率 | 通常比逻辑重建更适合整库恢复 |
| 持续 WAL 归档 | 支持 PITR,把恢复点推进到故障前 | 可降到接近归档延迟 | 需要额外 WAL 重放时间 |
| 流复制备用节点 | 快速接管服务 | 可降低数据落后,但不是备份替代品 | 可显著缩短切换时间 |
若数据库达到 TB 级、RPO 为 5 分钟且 RTO 为 60 分钟,一个常见组合是:定期物理基础备份、持续 WAL 归档、异地保留副本,并根据可用性要求配置流复制备用节点。逻辑备份可作为对象级误删恢复的补充,而不是承担全部灾难恢复职责。
建立可恢复的物理基线
下面示例创建一份物理基础备份并立刻校验清单。执行账号需要具备相应复制权限,认证信息应通过安全方式提供,而不是直接写进命令历史。
pg_basebackup -h <HOST> -p <PORT> -U backup_operator -D <PATH>/base -Fp -Xs -c fast &&
pg_verifybackup <PATH>/base >/dev/null &&
echo "BASE_BACKUP_OK"
预期输出
BASE_BACKUP_OK<HOST>、<PORT> 和 <PATH> 按实际环境替换。这个结果只能证明备份结构通过校验,不能证明业务一定能在目标 RTO 内恢复,因此仍需要真实恢复演练。
若目标 RPO 明显小于基础备份间隔,应同时启用可靠的 WAL 归档,并把归档文件写入与主库不同故障域的持久存储。生产环境还应监控归档失败、积压和存储空间,避免“配置了 archive_mode”却没有持续得到可用 WAL。
把数据规模换算成恢复时间预算
RTO 必须拆成可测量的阶段,例如“发现故障 5 分钟、准备恢复 10 分钟、还原基础备份 25 分钟、重放 WAL 10 分钟、校验与切流 10 分钟”。任何一段超时,整体 RTO 就会失守。
大库尤其要关注恢复吞吐量。假设需要还原 2 TB 数据,而可持续恢复吞吐只有 300 MB/s,仅复制数据理论上就需要接近两小时,还没计算 WAL 重放和应用校验。此时继续提高备份频率并不能解决 RTO,应该考虑更快的存储、并行恢复、预热备用节点或更自动化的切换流程。
用灾难演练证明设计有效
至少定期执行一次“从备份恢复到隔离环境”的演练,并记录开始时间、恢复完成时间、最终恢复点和关键业务校验结果。检查重点不是“备份任务显示成功”,而是能否在目标时间内恢复到业务认可的数据状态。
演练应覆盖基础备份损坏、最近一段 WAL 不可用、单个可用区失效等场景,并确认备份副本不与主库共享同一故障域。只有当实际演练同时满足允许的数据缺口和恢复时长,RPO、RTO 才从纸面目标变成可执行的恢复能力。