
PostgreSQL / 系统课时
同步复制与提交级别
同步复制与提交级别
同步复制真正要决定的不是“要不要复制”,而是一次 COMMIT 要等到哪一步才返回成功。本节把主库本地刷盘、备库写入、备库持久化和备库重放四个确认点拆开,并用 synchronous_commit 验证延迟与保障之间的取舍。
学习目标
- 区分异步复制与同步复制的配置边界
- 理解
off、local、remote_write、on、remote_apply的等待点 - 按事务切换提交级别并验证备库可见性
提交确认到底在等什么
WAL 从主库生成后,会依次经历主库本地持久化、网络发送、备库写入操作系统、备库刷入持久介质、备库重放。synchronous_commit 的不同取值,本质上就是把“向客户端返回 COMMIT 成功”的位置放在这条链路的不同节点。
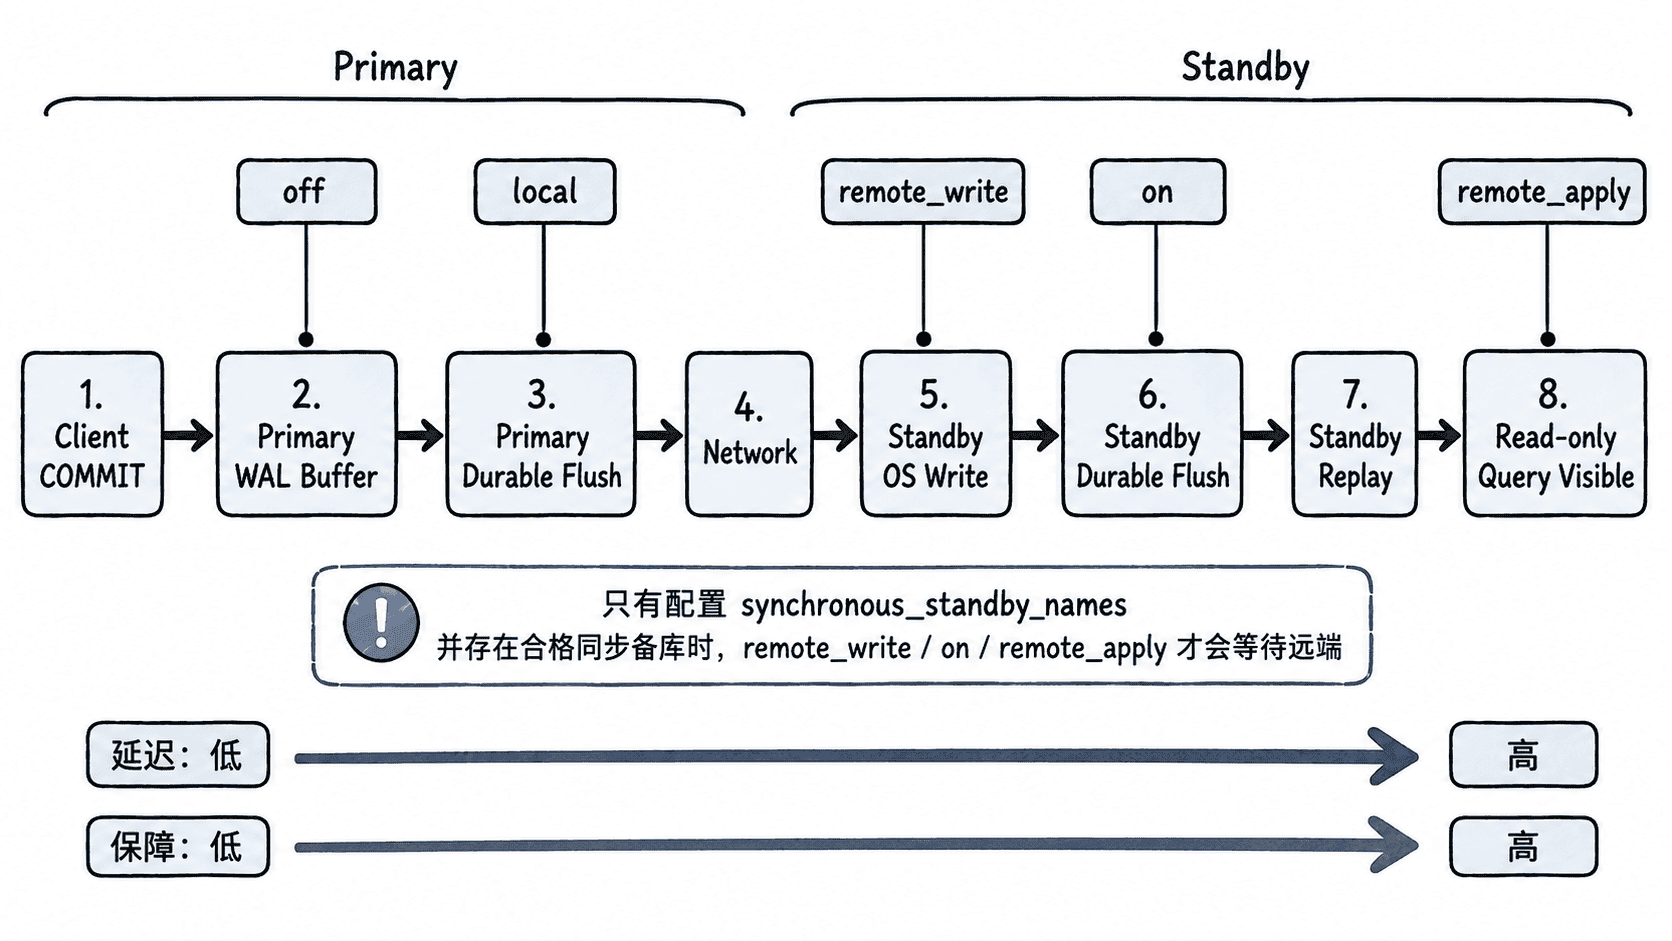
还要注意一个常见误区:synchronous_commit = on 并不会自动把任意备库变成同步备库。只有主库的 synchronous_standby_names 选中了可用备库,事务才会等待对应的远端确认。
五个提交级别的差异
| 级别 | COMMIT 至少等待到 | 主要保障 | 典型代价 |
|---|---|---|---|
off |
不等待本地 WAL 刷盘 | 吞吐优先,主库崩溃时最近事务可能丢失 | 最低延迟 |
local |
主库 WAL 持久化 | 主库单机持久性,不等待备库 | 接近普通异步复制 |
remote_write |
同步备库已写入操作系统 | 主库故障时,远端已收到 WAL,但备库操作系统崩溃仍可能丢失未刷盘数据 | 一次网络往返附近 |
on |
同步备库已持久化 WAL | 主库故障后,至少一个同步备库已有持久 WAL | 高于 remote_write |
remote_apply |
同步备库已重放事务 | COMMIT 返回后,新事务可在同步备库后续读取中看到 | 最高,受重放速度影响 |
如果没有任何同步备库被选中,remote_write、on、remote_apply 不会凭空获得远端保障。反过来,一旦配置了必须等待的同步备库,而它失联,相关提交可能阻塞。
让备库进入同步候选集合
前提是已经存在正常的物理流复制。备库连接主库时应设置稳定的 application_name,例如 standby1;如果已有 primary_conninfo,只需在原连接串中补上该字段并保留原认证信息。
primary_conninfo = 'host=<PRIMARY_IP> port=<PORT> user=repl_user application_name=standby1'在主库把它声明为第一优先级的同步备库,并重载配置:
ALTER SYSTEM SET synchronous_standby_names = 'FIRST 1 (standby1)';
SELECT pg_reload_conf();

SELECT application_name, state, sync_state
FROM pg_stat_replication
WHERE application_name = 'standby1';
预期结果:
ALTER SYSTEM
 pg_reload_conf
----------------
 t

 application_name |   state   | sync_state
------------------+-----------+-----------
 standby1         | streaming | sync
如果查询不到 standby1,先修正备库的 application_name 或复制连接;如果 state 不是 streaming,不要继续测试同步提交,否则可能把应用提交直接阻塞住。
按事务切换提交级别
synchronous_commit 可以按会话或事务覆盖,因此不必把整套系统永久切到同一保障级别。下面用一个幂等探针事务测试 remote_apply:只有当事务已经在同步备库完成重放后,主库才会返回 COMMIT。
BEGIN;
SET LOCAL synchronous_commit = 'remote_apply';

CREATE TABLE IF NOT EXISTS replication_commit_probe (
  probe_key text PRIMARY KEY,
  note text NOT NULL
);

INSERT INTO replication_commit_probe (probe_key, note)
VALUES ('remote-apply-check', 'visible after commit')
ON CONFLICT (probe_key)
DO UPDATE SET note = EXCLUDED.note;

COMMIT;
预期输出:
BEGIN
SET
CREATE TABLE
INSERT 0 1
COMMIT
随后立即在同步备库执行只读查询:
SELECT probe_key, note
FROM replication_commit_probe
WHERE probe_key = 'remote-apply-check';
预期结果:
     probe_key      |         note
--------------------+----------------------
remote-apply-check | visible after commit实际终端列宽可能不同,但行内容应一致。remote_apply 的价值正是把“主库已经提交”推进到“同步备库已经应用”;如果业务只要求远端 WAL 持久化而不要求立即可读,通常没有必要承担这一层额外重放延迟。
按业务目标选择等待点
可重放、可补算的数据可以考虑 off,但必须接受主库崩溃时最近提交丢失;大多数接受故障切换时少量数据窗口的系统,可使用异步复制并保持 local 或默认本地持久化语义。要求故障切换后尽量不丢已确认事务时,使用同步备库配合 on 更常见;只有存在“提交返回后立刻从备库读取”的一致性要求时,才优先考虑 remote_apply。
同步级别越高,提交路径越受网络 RTT、备库磁盘和重放速度影响。上线前应分别压测正常状态、同步备库高延迟和同步备库失联三种情况,确认延迟上限与故障时的阻塞策略都符合业务预期。