
PostgreSQL / 系统课时
分组集与多维聚合
分组集与多维聚合
多维报表常常既要明细维度组合,也要地区小计、商品小计和总计。分别写多条 GROUP BY 再 UNION ALL 可以实现,但维护成本高。PostgreSQL 的 GROUPING SETS、ROLLUP 和 CUBE 能在一条聚合语句里声明这些层级。
学习目标
- 能用
GROUPING SETS一次生成多个分组层级 - 能判断何时使用
ROLLUP、何时使用CUBE - 能用
GROUPING()区分真实NULL与汇总层产生的空维度
从报表层级反推分组集
假设销售数据有 region 和 product 两个维度。报表可能同时需要四类结果:地区加商品明细、地区小计、商品小计、全部总计。GROUPING SETS 的核心就是直接列出这些“希望保留的维度组合”,数据库负责在一次聚合计划中计算它们。
用 GROUPING SETS 生成多层汇总
下面的示例完全自包含,四条销售记录会被汇总成明细、两个方向的小计和总计。
WITH sales(region, product, amount) AS (
  VALUES
    ('E', 'A', 100),
    ('E', 'B', 80),
    ('N', 'A', 60),
    ('N', 'B', 40)
)
SELECT
  region,
  product,
  SUM(amount) AS total_amount,
  GROUPING(region) AS g_region,
  GROUPING(product) AS g_product
FROM sales
GROUP BY GROUPING SETS (
  (region, product),
  (region),
  (product),
  ()
)
ORDER BY
  GROUPING(region),
  GROUPING(product),
  region NULLS LAST,
  product NULLS LAST;
预期输出
 region | product | total_amount | g_region | g_product
--------+---------+--------------+----------+----------
 E      | A       |          100 |        0 |        0
 E      | B       |           80 |        0 |        0
 N      | A       |           60 |        0 |        0
 N      | B       |           40 |        0 |        0
 E      |         |          180 |        0 |        1
 N      |         |          100 |        0 |        1
        | A       |          160 |        1 |        0
        | B       |          120 |        1 |        0
        |         |          280 |        1 |        1
GROUPING(column) 返回 1 表示该列在当前汇总层被折叠,返回 0 表示该列仍是本层分组键。它比简单判断 column IS NULL 更可靠,因为源数据本身也可能真的包含 NULL。
ROLLUP 与 CUBE 的展开关系
ROLLUP(region, product) 表达的是有方向的层级链:先按地区和商品,再按地区,最后到总计。CUBE(region, product) 则生成两个维度的全部组合,因此还会多出“按商品”的横向小计。
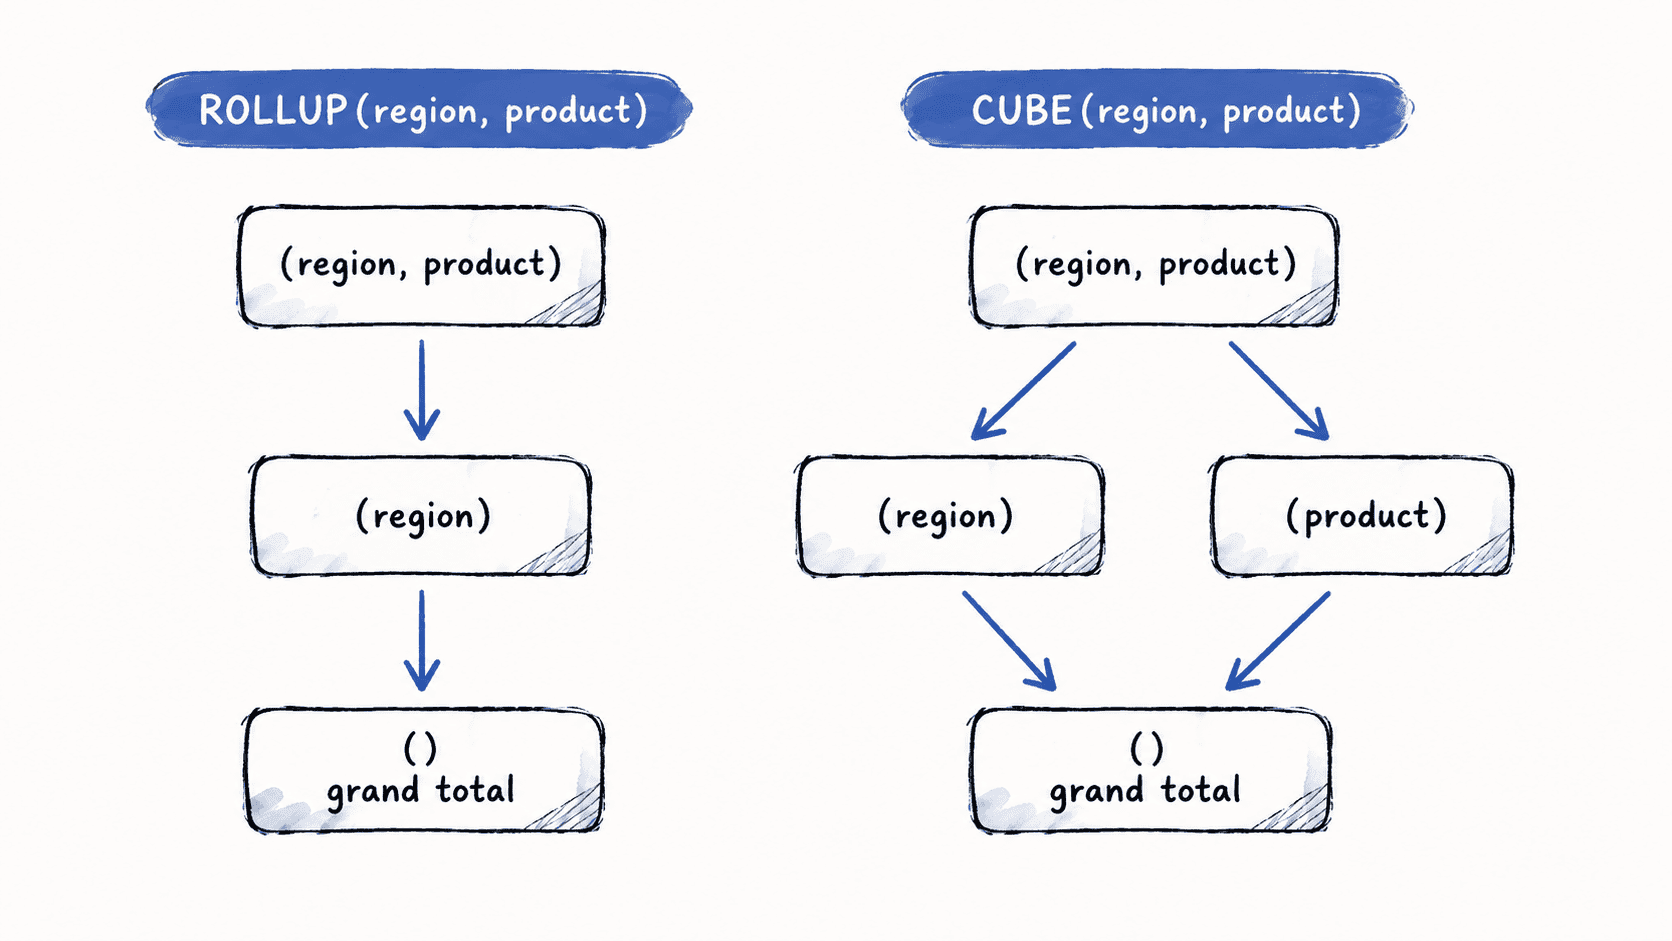
| 写法 | 等价分组集 | 典型用途 |
|---|---|---|
ROLLUP(region, product) |
(region, product), (region), () |
有父子顺序的小计与总计 |
CUBE(region, product) |
(region, product), (region), (product), () |
维度交叉分析 |
GROUPING SETS (...) |
只计算显式列出的组合 | 精确控制报表层级 |
当维度增加时,CUBE 的组合数按 增长。三个维度会产生 8 个分组集,六个维度就是 64 个,因此生产报表更常用显式 GROUPING SETS 或有业务层级的 ROLLUP,避免计算大量没人读取的组合。
让汇总结果可安全消费
展示层通常会把被汇总的维度显示为“全部地区”或“全部商品”,但不要直接用 COALESCE(region, '全部地区') 判断汇总层,因为真实数据中的 NULL 会与汇总空值混在一起。应先用 GROUPING() 确认层级,再决定显示文案或排序权重。
多维聚合的关键不是“把所有组合都算出来”,而是让分组集与报表真正需要的层级一一对应:固定层级优先 ROLLUP,完整交叉才用 CUBE,不规则组合则直接写 GROUPING SETS。