
PostgreSQL / 系统课时
VACUUM 工作过程
VACUUM 工作过程
VACUUM 的核心任务不是压缩表文件,而是在 MVCC 版本不断产生后,识别已不可再见的旧行版本,清理相关索引引用,回收页内空间,并推进冻结与可见性信息。本篇把一次普通 VACUUM 拆成可观测的执行阶段。
学习目标
- 说明 VACUUM 扫描、索引清理、堆清理与冻结之间的关系。
- 区分普通 VACUUM、冻结处理和 ANALYZE 的统计职责。
- 使用系统统计视图验证一次 VACUUM 是否真正发生。
从一次 VACUUM 观察清理结果
下面创建一张测试表,制造 4000 条可回收的旧行版本,再执行带 ANALYZE 的 VACUUM。VERBOSE 会把内部处理信息写到客户端,适合观察本次操作涉及的表和索引。
DROP TABLE IF EXISTS vacuum_demo;

CREATE TABLE vacuum_demo (
    id bigint PRIMARY KEY,
    payload text NOT NULL
);

INSERT INTO vacuum_demo
SELECT g, repeat('x', 80)
FROM generate_series(1, 10000) AS g;

DELETE FROM vacuum_demo
WHERE id <= 4000;

VACUUM (VERBOSE, ANALYZE) vacuum_demo;

SELECT
    relname,
    n_live_tup,
    n_dead_tup,
    vacuum_count,
    analyze_count
FROM pg_stat_user_tables
WHERE relname = 'vacuum_demo';
预期输出(省略不同 PostgreSQL 版本可能出现的 INFO 细节):
VACUUM
   relname   | n_live_tup | n_dead_tup | vacuum_count | analyze_count
-------------+------------+------------+--------------+---------------
 vacuum_demo | <VALUE>    | <VALUE>    | <VALUE>      | <VALUE>
<VALUE> 是动态统计值。重点不是要求 n_live_tup、n_dead_tup 精确等于某个数字,而是确认命令成功,且 vacuum_count、analyze_count 相比执行前增加;统计视图中的行数本身是估算值。
扫描与清理如何配合
普通 VACUUM 会扫描堆页,依据事务可见性判断哪些旧版本已经不可能再被任何仍有效的快照访问。可安全回收的行版本会形成待清理项,随后相关索引访问方法删除指向这些旧版本的索引条目,堆页中的空间才可以继续被后续写入复用。
这不是一次“把整张表复制得更紧凑”的操作。普通 VACUUM 主要把空间归还给表自身复用,通常不会显著缩小数据文件;需要重写表并向操作系统释放更多空间时,才会涉及 VACUUM FULL 等更重的方案。
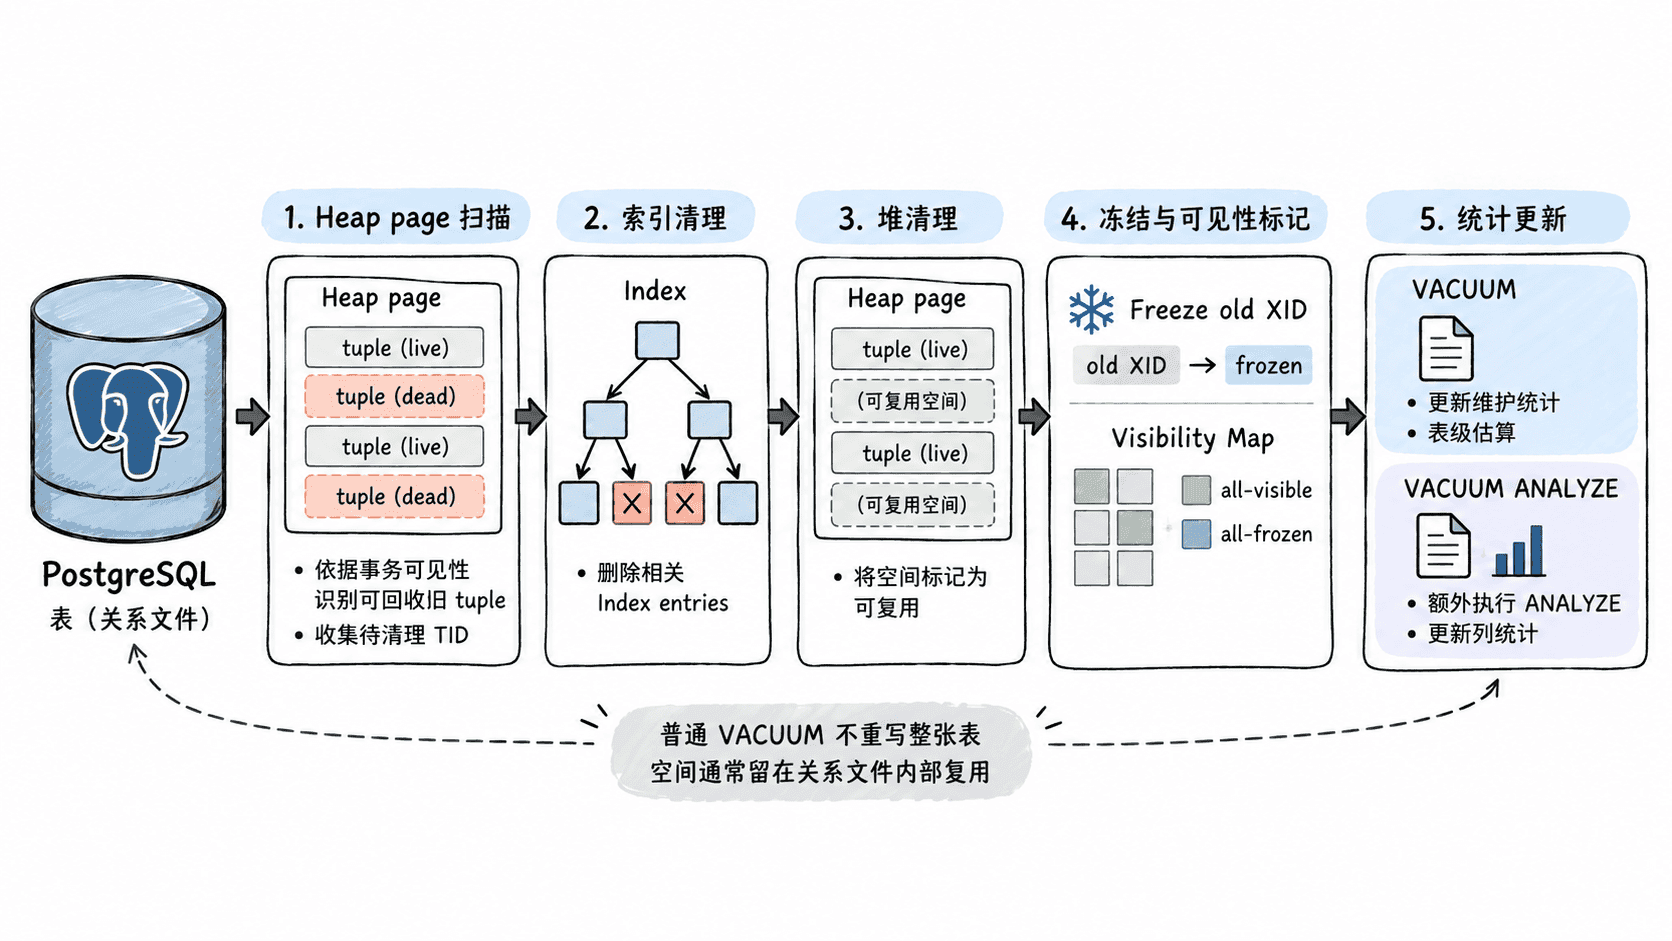
VACUUM 的实际执行并不保证每次都完整走过完全相同的工作量。死行数量、索引数量、页面状态以及维护参数都会影响是否需要索引清理、清理多少页以及扫描成本,因此应把上图理解为工作关系,而不是固定耗时流水线。
冻结解决的是事务 ID 老化
清理死行之外,VACUUM 还承担 tuple 冻结。PostgreSQL 的行版本带有事务 ID;随着事务持续推进,过老的事务 ID 必须被标记为已冻结状态,避免事务 ID 回卷导致可见性判断失效。
当页面满足条件时,VACUUM 还会维护 Visibility Map。all-visible 可帮助仅索引扫描避免再次访问部分堆页,all-frozen 则表示页面中的 tuple 不再需要未来的事务 ID 冻结处理。接近回卷安全边界时,系统会优先执行更积极的防回卷 vacuum,这类维护不能简单关闭。
统计更新要区分 VACUUM 与 ANALYZE
VACUUM 会更新维护相关计数和部分表级估算,但查询优化器依赖的列分布统计主要由 ANALYZE 采样生成。因此 VACUUM table_name 与 ANALYZE table_name 解决的是不同问题,而 VACUUM (ANALYZE) table_name 只是把两项维护串在一次命令中。
如果表经历大量 UPDATE、DELETE,重点观察死行积累和 vacuum 是否及时;如果数据分布快速变化,即使死行不多,也可能需要更频繁的 ANALYZE。判断维护是否有效时,应同时查看 pg_stat_user_tables 中的最近执行时间、累计次数、死行估算和自上次分析以来的变更量,而不是只看表文件大小。