
PostgreSQL / 系统课时
HOT 更新
HOT 更新
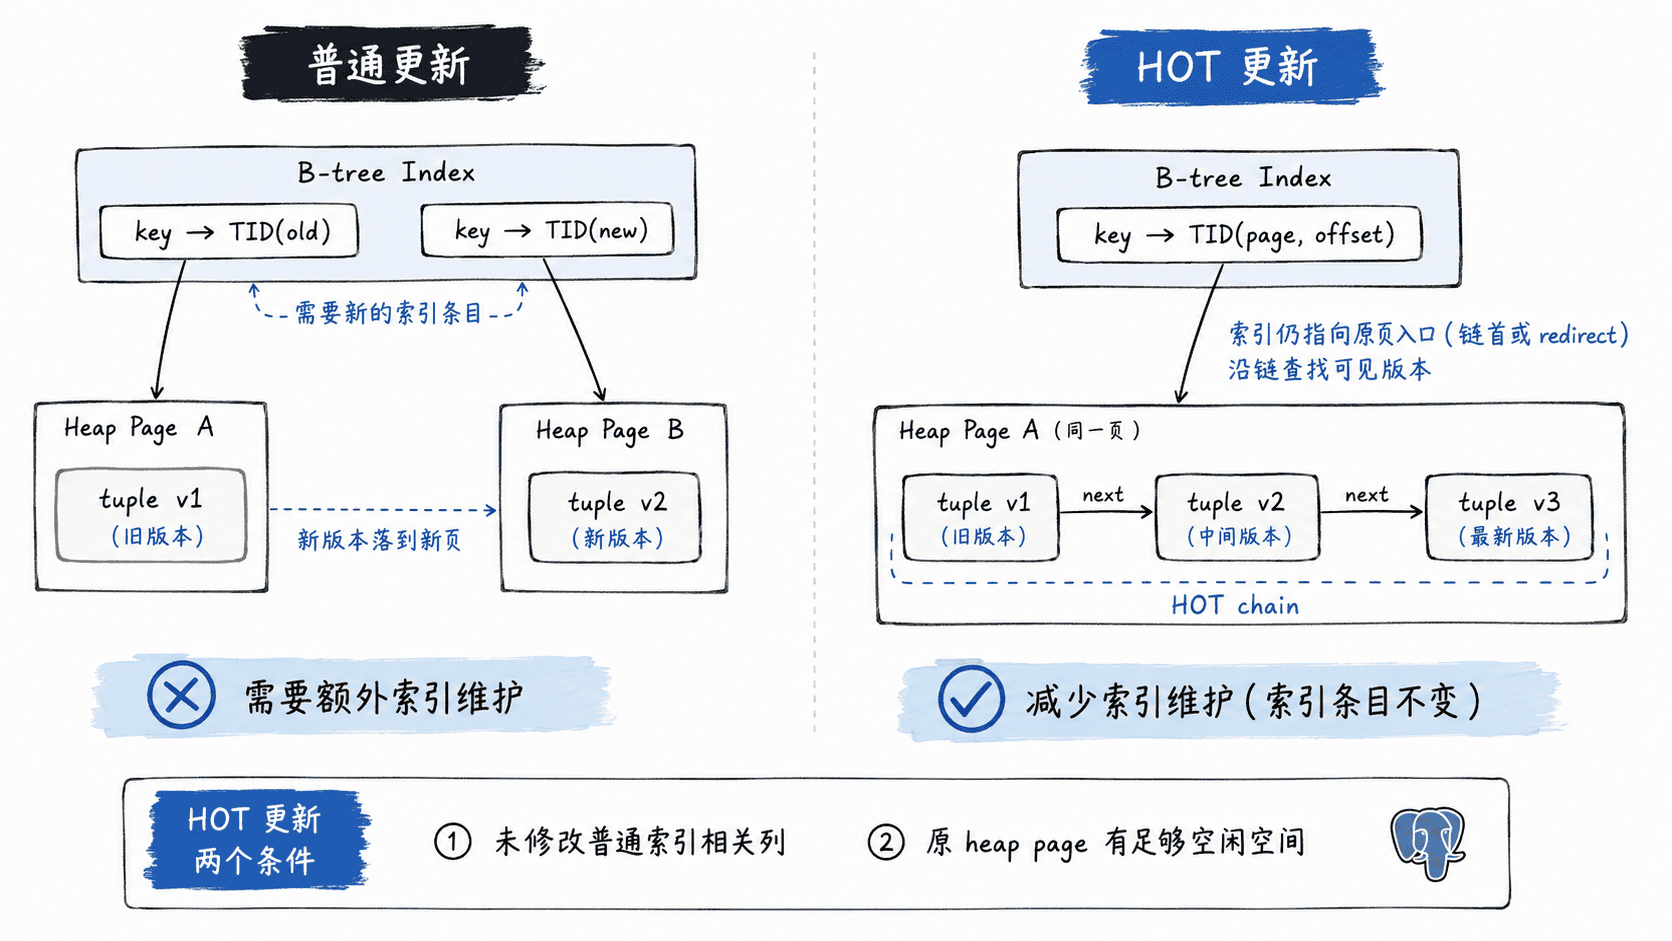
PostgreSQL 的 UPDATE 会生成新的堆元组版本,普通更新还可能同步维护多个索引。HOT(Heap-Only Tuple)让满足条件的新版本留在原堆页,并复用既有索引入口,从而降低索引写放大与后续清理成本。
学习目标
- 说清 HOT 更新为什么能避免新增普通索引条目
- 判断一次
UPDATE是否具备 HOT 的必要条件 - 用
pg_stat_user_tables观察 HOT 命中率并据此调整表设计
HOT 到底省了什么
普通 MVCC 更新会保留旧版本并创建新版本。如果新版本需要新的索引定位项,每个相关索引都要产生维护成本。HOT 的关键是让新旧版本位于同一个 heap page,并用页内 HOT chain 连接;普通索引仍可从原来的页内入口找到这条版本链,因此不必为每个新版本新增索引条目。
HOT 需要同时满足两个核心条件:本次更新不能修改会影响普通索引定位的列,并且旧元组所在页面必须有足够空间容纳新版本。fillfactor 较低可以在页内预留空间,提高第二个条件成立的概率,但它不会保证每次更新都命中 HOT。
用统计视图判断 HOT 命中率
pg_stat_user_tables.n_tup_upd 统计更新总量,其中 n_tup_hot_upd 是 HOT 更新数量。下面查询可直接找出更新量较大的表,并计算累计 HOT 比例。
SELECT
    schemaname,
    relname,
    n_tup_upd,
    n_tup_hot_upd,
    round(
        100.0 * n_tup_hot_upd / NULLIF(n_tup_upd, 0),
        1
    ) AS hot_pct
FROM pg_stat_user_tables
WHERE n_tup_upd > 0
ORDER BY n_tup_upd DESC
LIMIT 20;
预期结果
 schemaname | relname | n_tup_upd | n_tup_hot_upd | hot_pct
------------+---------+-----------+---------------+--------
 public     | orders  | <VALUE>   | <VALUE>       | <VALUE>
...这些是累计统计值,<VALUE> 会随统计重置、业务流量和页面布局变化。HOT 比例低并不自动说明有问题:如果业务经常修改索引键,非 HOT 更新本来就是必要成本。
哪些设计会让 HOT 失效
最常见的原因是“为了读性能不断加索引”。只要被更新的列参与普通索引键、表达式、部分索引谓词或作为覆盖索引的 INCLUDE 列,就可能让该次更新无法走 HOT,因为索引中保存的信息已经需要变化。核心 PostgreSQL 中的 BRIN 属于摘要型索引,行为与逐元组定位的普通索引不同,不能简单套用“任何索引列一变就绝对不能 HOT”的口号。
第二类原因是页内空间不足。即使更新的只是未索引列,如果新版本无法放进旧版本所在页面,也不能形成 HOT chain。对频繁更新且行宽较稳定的表,可以在建表时降低 fillfactor,用更多磁盘空间换取更高的页内更新机会。
CREATE TABLE hot_demo (
    id bigint PRIMARY KEY,
    state text NOT NULL,
    note text NOT NULL
) WITH (fillfactor = 80);

CREATE INDEX hot_demo_state_idx ON hot_demo (state);
预期结果
CREATE TABLE
CREATE INDEX
这里更新 note 时不会因为索引列变化而失去 HOT 资格;更新 state 时,B-tree 索引内容需要变化,因此不具备普通 HOT 的条件。是否真正命中还要看目标页剩余空间,而不是只看 SQL 里改了哪一列。
生产环境怎么用 HOT 思维
先从高更新量表统计 HOT 比例,再回到索引清单和更新语句判断原因。对“写得多、读过滤少”的字段,不要为了偶发查询轻易建立 B-tree 覆盖索引;索引越多,普通更新的维护成本越高,也越容易限制 HOT。
降低 fillfactor 也有代价:同样的数据会占用更多 heap page,顺序扫描与缓存压力可能上升。因此应把 HOT 当作写入路径的优化结果,而不是追求 100% 命中率的 KPI。最合理的目标是让索引服务真实查询,让页面保留与更新频率匹配的空间,再用实际 n_tup_hot_upd / n_tup_upd 验证取舍。