
PostgreSQL / 系统课时
全文检索
全文检索
PostgreSQL 全文检索把自然语言文本预处理成可索引的词位,再用查询表达式完成匹配与排序。本课用一张文章表串起 tsvector、tsquery、文本搜索配置、GIN 索引和相关性评分,最终得到可直接用于站内搜索的 SQL。
学习目标
- 理解
tsvector、tsquery与文本搜索配置各自负责什么 - 建立可由 GIN 加速的全文检索列,并正确生成查询表达式
- 使用
ts_rank_cd对匹配结果排序,并理解词典配置对词位的影响
从文本到可检索词位
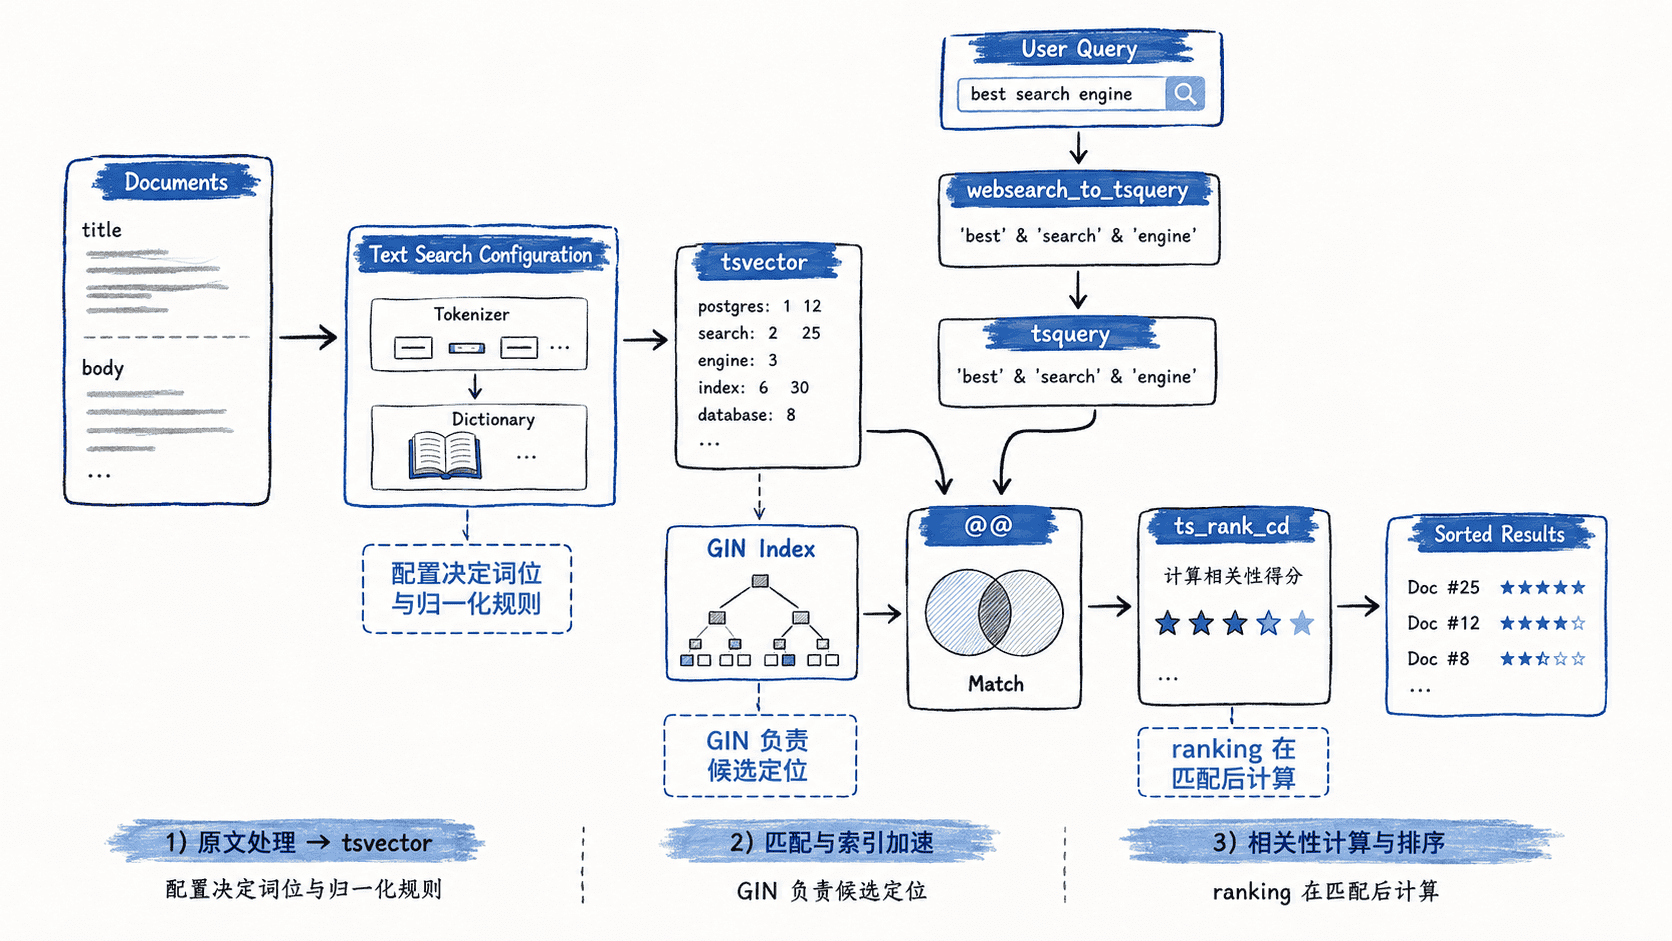
全文检索不是直接对原文做 LIKE '%关键词%'。to_tsvector 会先按文本搜索配置完成分词、停用词处理和词形归一化,再生成带位置的词位集合;tsquery 则描述要匹配的词位及其逻辑关系。两者通过 @@ 运算符完成匹配。
例如,english 配置会使用英语词典做词干归一化,因此复数或进行时可能被压缩成同一词位。先观察一个最小转换:
SELECT to_tsvector('english', 'Running databases');预期结果:
       to_tsvector
--------------------------
 'databas':2 'run':1
这里保存的是归一化后的词位而不是原句。配置选错会直接改变检索语义:中文、产品编号、日志关键字等内容通常不应机械套用英语词干规则,应根据数据语言和搜索需求选择或定制配置。
建立检索列与 GIN 索引
生产查询中不要每次都对整列临时执行 to_tsvector。更稳妥的做法是把可检索内容保存为生成列,再对该列建立 GIN 索引。下面创建三篇示例文章,并把标题和正文合并进搜索向量:
CREATE TABLE search_article_demo (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    title text NOT NULL,
    body text NOT NULL,
    search_vector tsvector GENERATED ALWAYS AS (
        to_tsvector(
            'english',
            coalesce(title, '') || ' ' || coalesce(body, '')
        )
    ) STORED
);

INSERT INTO search_article_demo (title, body) VALUES
('PostgreSQL full text search', 'PostgreSQL provides tsvector and GIN indexes for fast document search.'),
('JSON processing', 'JSONB operators are useful for semi-structured application data.'),
('Ranking search results', 'Use tsquery with ts_rank_cd to rank PostgreSQL search results.');

CREATE INDEX search_article_demo_fts_idx
ON search_article_demo
USING GIN (search_vector);
预期输出:
CREATE TABLE
INSERT 0 3
CREATE INDEX
生成列会在写入或更新 title、body 时重算,GIN 索引则保存词位到文档的倒排关系。若字段重要性不同,还可以分别构造向量并用 setweight 标记 A、B、C、D 权重,让标题命中比正文命中获得更高排名。
构造查询并按相关性排序
面向搜索框时,websearch_to_tsquery 通常比让用户手写 &、|、! 更友好;它能理解普通词、引号短语和减号排除语法。查询时先生成一次 tsquery,再复用它做过滤和排名:
WITH q AS (
    SELECT websearch_to_tsquery('english', 'postgresql search') AS query
)
SELECT
    a.id,
    a.title,
    round(ts_rank_cd(a.search_vector, q.query)::numeric, 4) AS rank
FROM search_article_demo AS a
CROSS JOIN q
WHERE a.search_vector @@ q.query
ORDER BY rank DESC, a.id;
预期结果:
 id |             title              |  rank
----+--------------------------------+---------
  1 | PostgreSQL full text search    | <VALUE>
  3 | Ranking search results         | <VALUE>
<VALUE> 是相关性分数,实际数值取决于词位位置、频率和权重;关键验证点是只有同时匹配 postgresql 与 search 的文章进入结果,并按 ts_rank_cd 从高到低排序。排名只是候选结果的排序依据,不等价于业务最终排序,常见做法是再叠加发布时间、质量分或权限过滤。
选择配置与查询函数
文本搜索配置本质上定义“哪些 token 交给哪些词典,以及词典如何规范化”。同一份文本使用不同配置,可能产生完全不同的 tsvector,因此写入向量和生成查询时必须使用一致配置;否则用户输入和索引词位可能落在不同规则下。
plainto_tsquery 适合把普通空格分隔词转换为 AND 查询;phraseto_tsquery 强调词序与距离;websearch_to_tsquery 更适合搜索框。若业务需要前缀匹配,可显式构造带 :* 的 to_tsquery,但不要把未转义的用户输入直接拼接进查询字符串。
索引与排序的边界
GIN 很适合加速 @@ 候选匹配,但它不会替你完成最终相关性排序;ts_rank 或 ts_rank_cd 仍需对命中的候选行计算分数。数据量大时,应先用 WHERE search_vector @@ query 尽量缩小集合,再计算排名,并用普通条件继续限制租户、状态和时间范围。
如果搜索需求只是精确前缀、短代码或固定标签,B-tree、pg_trgm 或普通等值索引可能更合适。全文检索真正擅长的是自然语言词位匹配:选对配置、把向量持久化、用 GIN 缩小候选,再把相关性评分放在匹配之后。