
PostgreSQL / 系统课时
分区创建与自动维护
分区创建与自动维护
分区表真正进入生产后,难点从“会创建分区”变成“不会因为缺分区、默认分区积压或历史分区失控而中断写入”。本节建立默认分区和未来月分区,并把预创建、监控、归档与删除串成一套可自动执行的生命周期。
学习目标
- 建立默认分区和未来分区,避免时间边界到来时写入失败
- 用函数批量预创建月分区,并验证数据实际路由位置
- 设计默认分区监控、历史分区归档与删除的维护顺序
默认分区只做安全网
没有匹配边界时,普通分区表会拒绝插入。DEFAULT 分区可以接住这些数据,避免业务请求立刻失败,但它不应该成为长期存放区,否则会掩盖未来分区漏建、时间字段异常或路由设计错误。
更稳妥的做法是提前创建未来若干周期的分区,同时监控默认分区行数。只要默认分区出现数据,就把它当成需要处理的异常信号,而不是“自动扩容成功”。
用函数预创建未来月分区
下面示例先创建按日期范围分区的审计表和默认分区,再定义一个函数,根据月份生成标准化分区名和边界。示例固定创建 2026 年 9 月到 11 月三个分区,便于重复理解结果。
CREATE TABLE audit_log (
    id bigint GENERATED ALWAYS AS IDENTITY,
    created_on date NOT NULL,
    payload jsonb NOT NULL
) PARTITION BY RANGE (created_on);

CREATE TABLE audit_log_default
PARTITION OF audit_log DEFAULT;

CREATE OR REPLACE FUNCTION ensure_audit_log_month(p_month date)
RETURNS text
LANGUAGE plpgsql
AS $$
DECLARE
    v_start date := date_trunc('month', p_month)::date;
    v_end date := (date_trunc('month', p_month) + interval '1 month')::date;
    v_name text := format('audit_log_%s', to_char(v_start, 'YYYY_MM'));
BEGIN
    EXECUTE format(
        'CREATE TABLE IF NOT EXISTS %I PARTITION OF audit_log
         FOR VALUES FROM (%L) TO (%L)',
        v_name,
        v_start,
        v_end
    );

    RETURN v_name;
END;
$$;

SELECT ensure_audit_log_month(d::date) AS partition_name
FROM generate_series(
    DATE '2026-09-01',
    DATE '2026-11-01',
    INTERVAL '1 month'
) AS g(d);
预期结果
    partition_name
----------------------
 audit_log_2026_09
 audit_log_2026_10
 audit_log_2026_11
生产中可以让系统调度器每天或每周调用同一函数,按当前月份向后预建若干周期。调度器可以来自操作系统、编排平台或已安装的数据库调度扩展;核心要求是“提前创建”,不要等第一条新月份数据到达后才补分区。
用实际写入检查默认分区是否被命中
继续插入三条记录,其中十二月尚未创建专用分区,因此应落入 DEFAULT 分区。这个检查同时验证了未来分区和兜底路径。
INSERT INTO audit_log (created_on, payload)
VALUES
    (DATE '2026-09-03', '{"event":"login"}'),
    (DATE '2026-10-03', '{"event":"logout"}'),
    (DATE '2026-12-03', '{"event":"export"}');

SELECT
    tableoid::regclass::text AS partition_name,
    count(*) AS rows_in_partition
FROM audit_log
GROUP BY 1
ORDER BY 1;
预期结果
    partition_name     | rows_in_partition
-----------------------+-------------------
 audit_log_2026_09     |                 1
 audit_log_2026_10     |                 1
 audit_log_default     |                 1
看到 audit_log_default 非零时,应先确认这些行是否只是未来分区漏建。如果是,就在创建新边界前迁移对应数据;如果日期本身异常,则应修复写入源,而不是无限扩大默认分区。
把维护动作串成生命周期
分区维护不是单次 DDL,而是一条持续循环的运维链路:先预创建未来分区,再让新数据稳定路由;持续监控默认分区和分区大小;超过保留期后,先从主表脱离旧分区,完成归档或审计,再决定是否删除物理表。
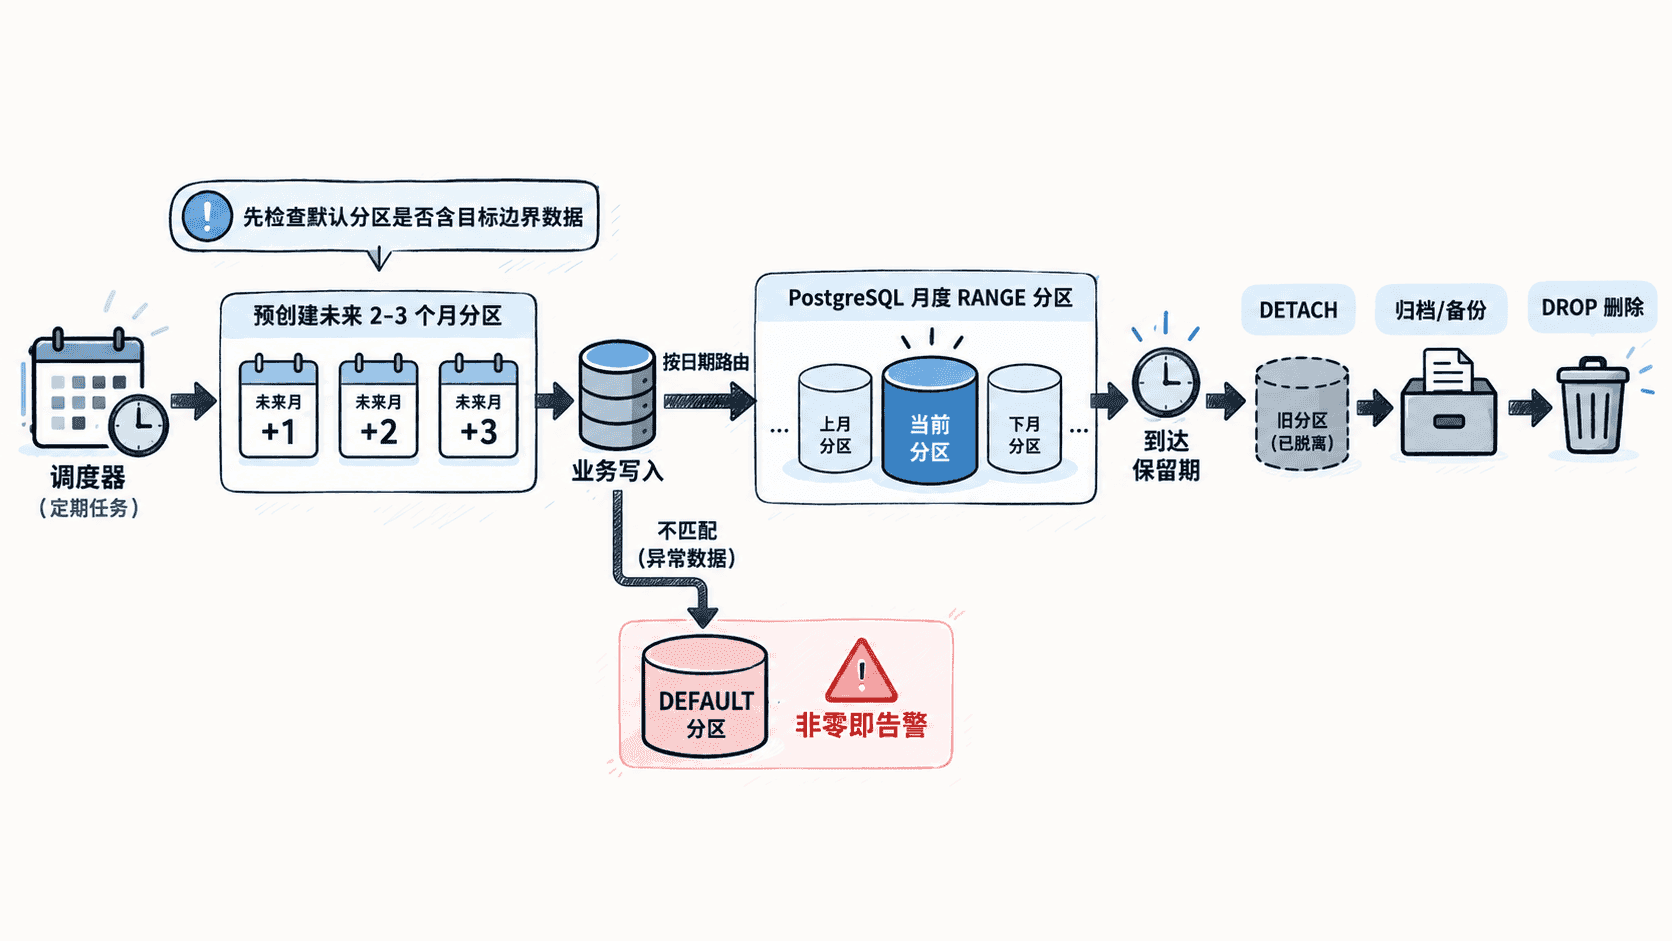
这条流程的价值在于把高风险操作分开:创建未来分区属于预防性动作,默认分区检查属于异常发现,脱离旧分区属于数据生命周期动作。它们可以有不同的执行频率和审批级别,不必绑成一个庞大脚本。
自动维护必须有可验证的护栏
至少监控三类信号:未来分区是否覆盖预定时间窗、默认分区是否出现新行、旧分区是否按保留策略退出。任何一个信号失效,都可能在时间边界上变成写入故障或存储膨胀。
删除旧分区前应先确认业务保留期、备份状态和是否仍有查询依赖。对大表而言,按分区整体脱离和删除通常比在父表上执行大范围 DELETE 更可控,也更容易把归档与恢复流程做成标准操作。
稳定的自动维护不是“定时执行 CREATE TABLE”,而是让预创建、异常兜底、监控和生命周期清理彼此闭环:未来边界始终提前存在,DEFAULT 只承担短期保险,历史分区则按明确保留策略退出主表。