
PostgreSQL / 系统课时
查询优化闭环
查询优化闭环
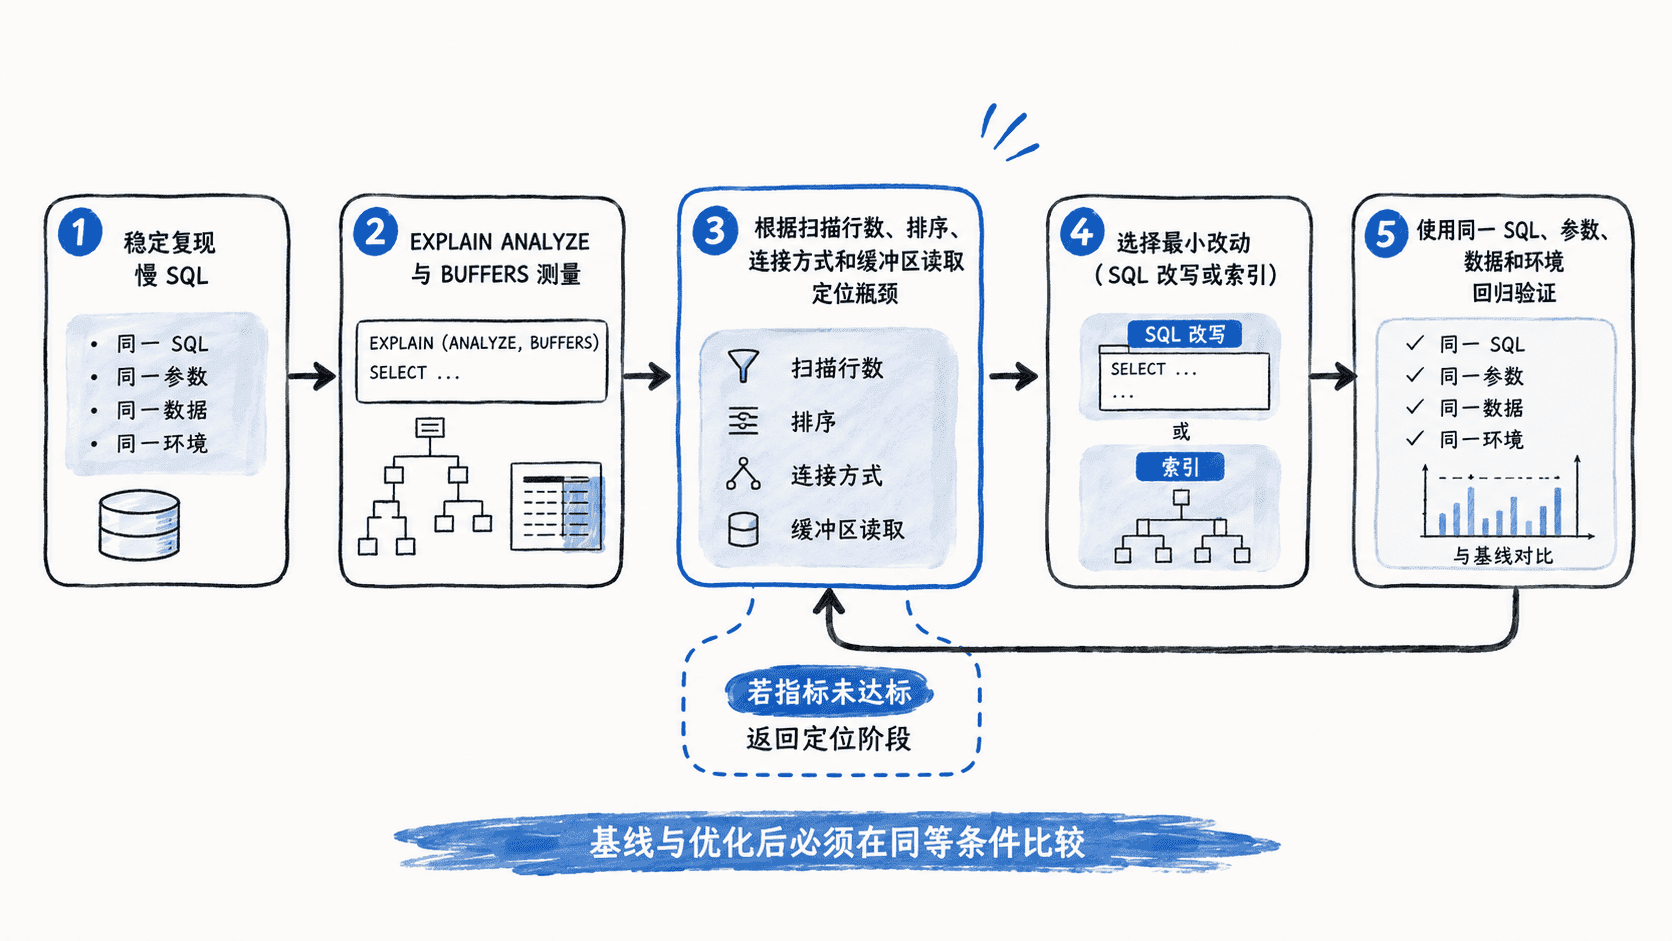
查询优化不是看到慢 SQL 就立即加索引,而是先稳定复现并量化瓶颈,再针对执行计划做最小改动,最后用相同条件回归验证。本节建立一套可重复的 PostgreSQL 优化流程,让每次改写或建索引都有证据支持。
学习目标
- 按复现、测量、改写或建索引、验证的顺序处理慢查询
- 使用
EXPLAIN (ANALYZE, BUFFERS)判断时间和数据读取消耗在哪里 - 用基线与回归结果证明优化有效,并避免只优化单次执行
先建立可重复的基线
优化前首先固定 SQL、参数、数据规模和 PostgreSQL 配置。否则第一次在冷缓存运行、第二次在热缓存运行,就可能把缓存收益误认为 SQL 优化收益。
下面创建一个可重复实验表,并观察没有针对性索引时的执行计划。
DROP TABLE IF EXISTS optimization_orders;
CREATE TABLE optimization_orders (
    id bigint PRIMARY KEY,
    customer_id integer NOT NULL,
    created_at date NOT NULL,
    amount numeric(10, 2) NOT NULL
);

INSERT INTO optimization_orders
SELECT g,
       (g % 1000) + 1,
       CURRENT_DATE - (g % 365),
       ((g % 10000) / 100.0)::numeric(10, 2)
FROM generate_series(1, 200000) AS g;

ANALYZE optimization_orders;

EXPLAIN (ANALYZE, BUFFERS)
SELECT id, created_at, amount
FROM optimization_orders
WHERE customer_id = 42
ORDER BY created_at DESC
LIMIT 20;
预期结果
Limit  (actual time=<VALUE> rows=20 loops=1)
  ->  Sort  (actual time=<VALUE> rows=20 loops=1)
        Sort Key: created_at DESC
        ->  Seq Scan on optimization_orders
              Filter: (customer_id = 42)
              Rows Removed by Filter: <VALUE>
              Buffers: shared hit=<VALUE>
Planning Time: <VALUE> ms
Execution Time: <VALUE> ms
具体成本、时间和缓冲区数字会随机器、缓存状态和 PostgreSQL 版本变化,因此用 <VALUE> 表示动态值。此时真正值得关注的是计划形态:为了找到一个客户的少量订单,数据库扫描了大量无关行,并额外执行排序。
从执行计划提出可验证假设
优化动作应来自执行计划,而不是来自“某列出现在 WHERE 中就建索引”的经验规则。当前查询同时需要按 customer_id 过滤,并按 created_at DESC 取前 20 行,因此可以提出一个具体假设:让索引先定位客户,再按所需顺序直接读取,可能同时消除全表扫描和显式排序。
用最小改动验证假设
针对当前访问模式创建复合索引。列顺序不是随意排列:等值过滤列放在前面,随后放置需要有序读取的时间列。
CREATE INDEX idx_optimization_orders_customer_created
ON optimization_orders (customer_id, created_at DESC);

ANALYZE optimization_orders;

EXPLAIN (ANALYZE, BUFFERS)
SELECT id, created_at, amount
FROM optimization_orders
WHERE customer_id = 42
ORDER BY created_at DESC
LIMIT 20;
预期结果
Limit  (actual time=<VALUE> rows=20 loops=1)
  ->  Index Scan using idx_optimization_orders_customer_created on optimization_orders
        Index Cond: (customer_id = 42)
        Buffers: shared hit=<VALUE> read=<VALUE>
Planning Time: <VALUE> ms
Execution Time: <VALUE> ms
理想情况下,新的计划直接沿复合索引读取前 20 条匹配记录,不再扫描大部分表,也不需要单独的 Sort。如果实际仍选择顺序扫描,不应立刻强制使用索引,而要检查统计信息、数据选择性、返回行数和表规模是否使顺序扫描本来就更便宜。
回归验证不能只看执行时间
单次 Execution Time 很容易受到缓存、并发负载和后台任务影响。至少应同时比较计划节点、实际扫描行数、Buffers、排序是否消失以及多次运行的延迟分布。对生产查询还要确认新索引带来的写入成本和磁盘占用可以接受。
完整闭环可以归结为:先保存可重复基线,用执行计划把“慢”转化为可测量的扫描、排序或连接问题,只实施能够验证某个假设的最小改动,再在相同条件下回归。无法证明收益的索引或 SQL 改写,就不应因为看起来合理而保留。