
PostgreSQL / 系统课时
典型生产故障排查
典型生产故障排查
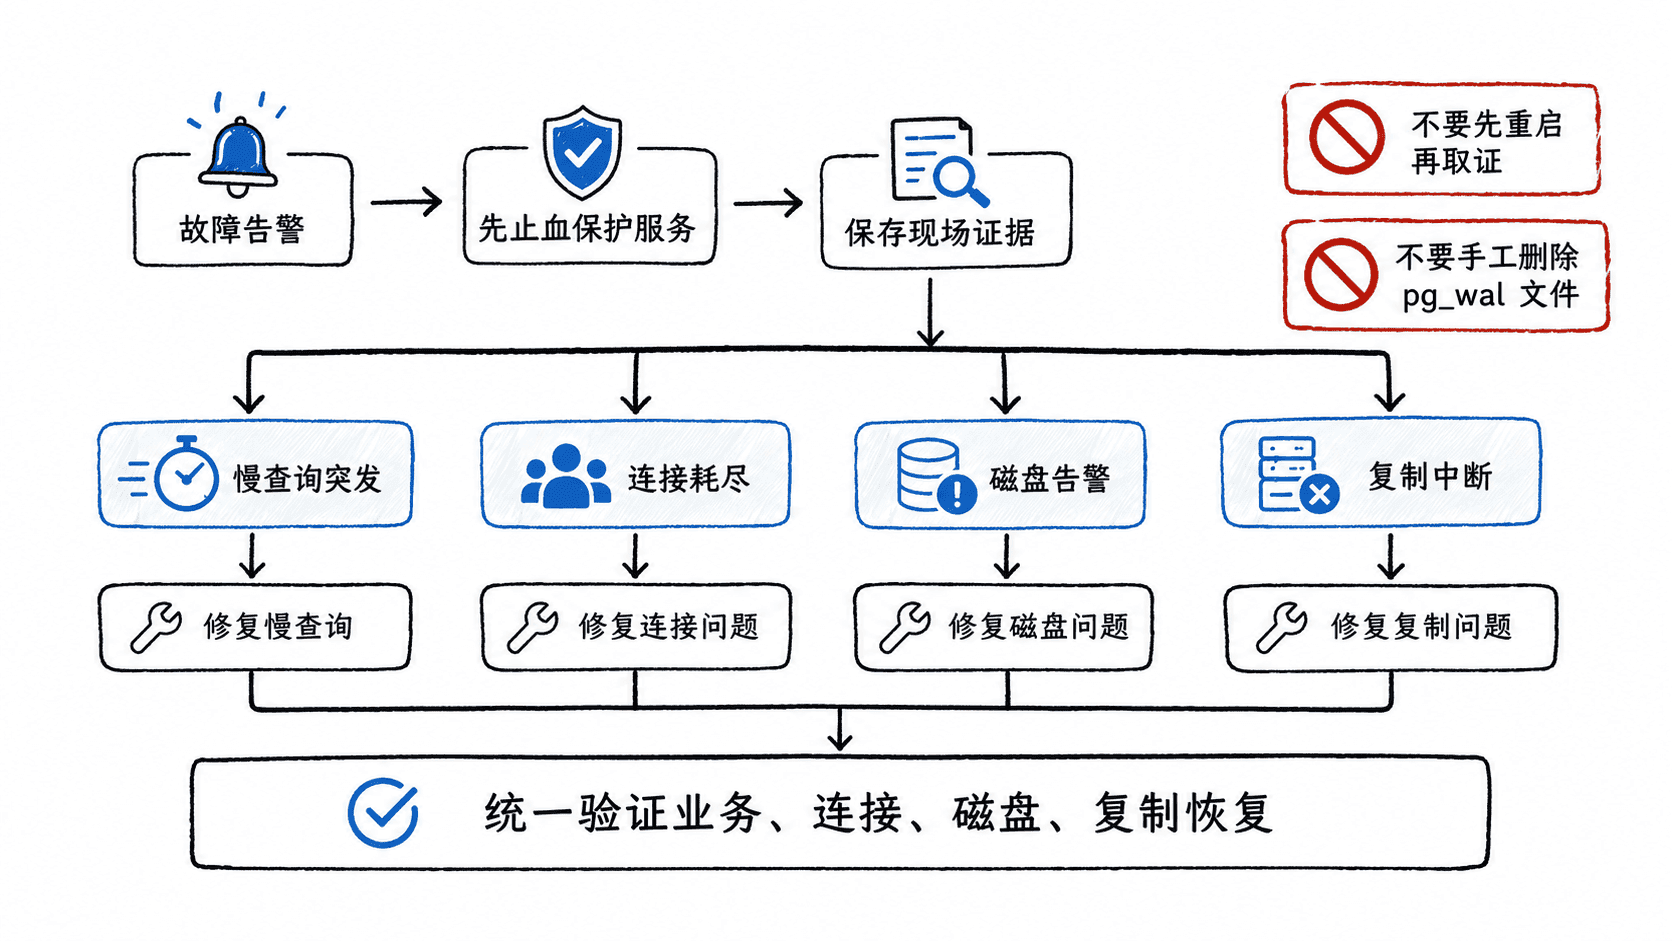
生产数据库出故障时,目标不是立刻“调参数”,而是先恢复可用性并保留证据。本节用统一排查顺序处理四类高频事件:慢查询突发、连接耗尽、磁盘告警和复制中断,最后用同一组指标确认故障确实消失。
学习目标
- 按“止血、取证、定位、修复、验证”的顺序处置数据库故障
- 能用 PostgreSQL 系统视图定位慢查询、连接和复制异常
- 能识别磁盘与 WAL 相关操作中的高风险动作
先固定排查顺序
先判断业务是否仍可读写,再保存当时的连接、活动 SQL、磁盘和复制状态。只要跳过取证直接重启,现场就可能消失;只要跳过止血继续让流量打满,后续诊断也可能失去操作窗口。
第一轮现场采集可以直接在数据库中执行。以下 SQL 不修改数据,适合在主库上快速确认活动会话、连接总量与复制发送端状态。
SELECT
  pid,
  usename,
  state,
  wait_event_type,
  wait_event,
  now() - query_start AS runtime,
  left(query, 120) AS query
FROM pg_stat_activity
WHERE pid <> pg_backend_pid()
  AND state <> 'idle'
ORDER BY query_start NULLS LAST
LIMIT 20;

SELECT
  count(*) AS total_connections,
  count(*) FILTER (WHERE state = 'active') AS active_connections,
  current_setting('max_connections')::int AS max_connections
FROM pg_stat_activity;

SELECT
  application_name,
  state,
  sync_state,
  pg_wal_lsn_diff(pg_current_wal_lsn(), replay_lsn) AS replay_lag_bytes
FROM pg_stat_replication;
预期输出
 pid   | usename | state  | wait_event_type | wait_event | runtime | query
<PID>  | app     | active | <VALUE>         | <VALUE>    | <TIME>  | <SQL>
...
 total_connections | active_connections | max_connections
<VALUE>             | <VALUE>            | <VALUE>
 application_name | state     | sync_state | replay_lag_bytes
standby-1          | streaming | async      | <VALUE>
实际 PID、持续时间、连接数和复制延迟会随现场变化;如果 pg_stat_replication 没有行,表示当前实例看不到任何 WAL 发送端连接,需要继续确认是否在主库执行以及备用库是否已连接。
慢查询突发先区分“慢”与“等”
一条 SQL 运行很久,不代表它一定在消耗 CPU。先看 wait_event_type:如果在等待锁,优先找阻塞链;如果没有等待而持续读取大量数据,再检查执行计划、统计信息、索引与近期数据分布变化。
发现单条异常 SQL 时,优先尝试 pg_cancel_backend(<PID>),让语句取消但保留连接;只有会话失控、事务无法结束或取消无效时,再考虑 pg_terminate_backend(<PID>)。终止后台进程会回滚其未提交事务,生产操作前必须确认 PID 对应的业务会话。
SELECT pg_cancel_backend(<PID>);预期结果
 pg_cancel_backend
-------------------
 t
返回 t 表示已发送取消请求,不等于业务问题已经解决;还要再次查看 pg_stat_activity,确认异常 SQL 消失且请求延迟恢复。
连接耗尽先恢复管理通道
连接接近 max_connections 时,不要把第一反应变成“继续调大”。先限制异常入口、利用可用的管理连接进入数据库,再统计哪些用户、应用和状态占用了连接。大量长期 idle in transaction 往往比普通 idle 更危险,因为它可能长期持有快照或锁。
SELECT
  usename,
  application_name,
  state,
  count(*) AS connections
FROM pg_stat_activity
GROUP BY usename, application_name, state
ORDER BY connections DESC;
预期输出
 usename | application_name | state               | connections
app      | order-api        | idle                | <VALUE>
app      | order-worker     | active              | <VALUE>
app      | order-api        | idle in transaction | <VALUE>
修复重点通常在连接池上:设置合理池大小、借出超时和连接回收策略,并为事务设置明确边界。数据库侧可以用 idle_in_transaction_session_timeout 防止失控事务无限占用资源,但上线前应验证应用能正确处理连接被关闭的情况。
磁盘告警先判断谁在增长
磁盘逼近容量上限时,先区分数据表、索引、临时文件、日志、归档 WAL 和复制槽保留的 WAL。数据库内部可以先找最大的关系,操作系统层再确认哪个目录占用空间。
SELECT
  relname,
  pg_size_pretty(pg_total_relation_size(relid)) AS total_size
FROM pg_catalog.pg_statio_user_tables
ORDER BY pg_total_relation_size(relid) DESC
LIMIT 10;
预期输出
 relname     | total_size
orders       | <VALUE>
order_items  | <VALUE>
...如果增长来自失效复制槽,应先确认对应消费者是否已经废弃,再通过受控方式删除槽;如果来自业务表,则根据保留策略归档或删除旧分区,并给清理动作预留 WAL 与索引维护空间。
复制中断从发送端和接收端两侧定位
主库 pg_stat_replication 无记录时,先检查备用库网络、认证、进程和连接参数;有记录但 replay_lag_bytes 持续扩大时,再判断备用库是否因 I/O、长查询、冲突或资源不足而回放变慢。
备用库可执行以下查询确认 WAL 接收器状态:
SELECT
  status,
  sender_host,
  sender_port,
  written_lsn,
  flushed_lsn,
  latest_end_lsn
FROM pg_stat_wal_receiver;
预期输出
 status    | sender_host | sender_port | written_lsn | flushed_lsn | latest_end_lsn
streaming  | <IP>        | <PORT>      | <LSN>       | <LSN>       | <LSN>
没有行表示 WAL receiver 当前未运行。此时应继续检查备用库日志、primary_conninfo、pg_hba.conf、复制用户权限以及主库是否仍保留备用库需要的 WAL。
完成修复后必须重新看业务错误率、活动 SQL、连接占用、文件系统余量和复制状态。只有告警消失、指标回到稳定区间且持续观察没有再次恶化,才能把事故从“已止血”判断为“已恢复”。