
PostgreSQL / 系统课时
构建基准数据集
构建基准数据集
本节构建一套可重复生成的 PostgreSQL 18 基准数据:订单具有客户热点,明细具有商品热点,同时保留连续时间字段和四表关联。完成后,可用同一数据集稳定复现实验并比较执行计划变化。
学习目标
- 创建包含维度表、事实表和明细表的统一测试模型。
- 用确定性规则制造客户与商品数据倾斜,同时保留时间序列特征。
- 通过统计查询验证行数、热点分布和多表关联结果,为后续优化建立固定基线。
设计可复现的数据模型
数据集使用 customer、product、orders、order_item 四张表。订单指向客户,订单明细同时指向订单与商品;热点客户承载多数订单,热点商品承载多数明细。生成规则只依赖序号运算,不依赖 random(),因此重复构建时分布保持一致。
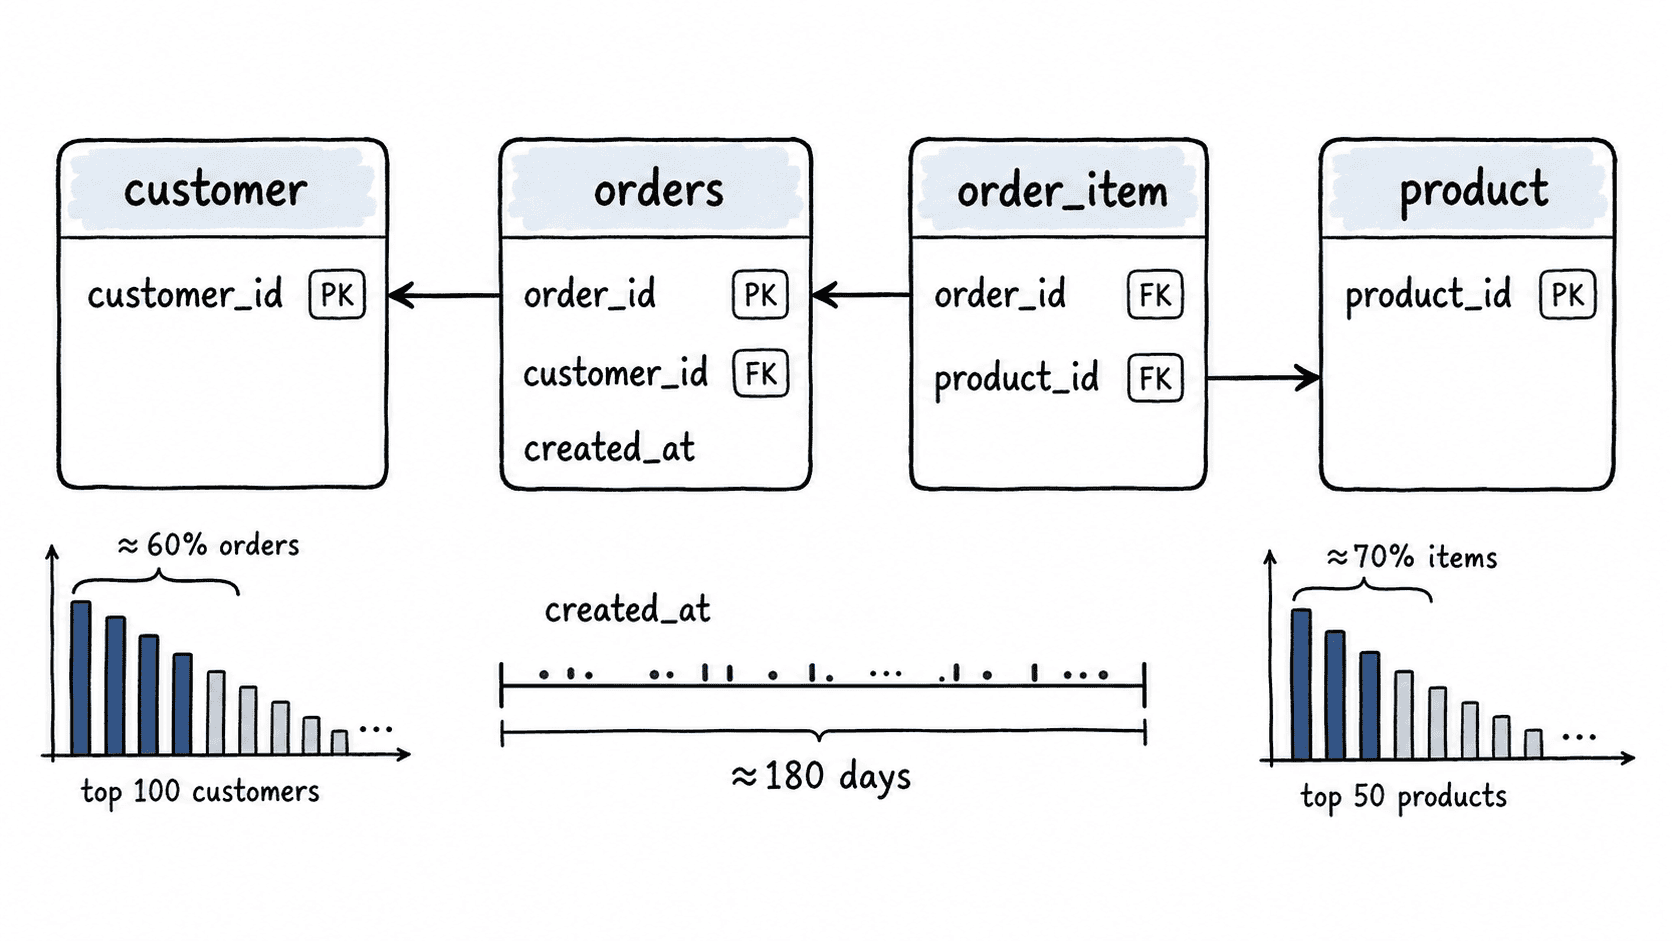
这套结构既能测试时间过滤、聚合,也能测试多表 JOIN 与基数估计。除主键和 order_item 的复合主键外,暂不创建额外业务索引,避免在数据生成阶段提前替后续索引实验做出优化决策。
一次性生成完整数据
下面脚本会重建 bench schema,生成 1 万客户、5000 商品、30 万订单和 75 万订单明细,并在完成后执行 ANALYZE。固定时间锚点让相同脚本在不同日期运行时仍得到同一时间分布。
DROP SCHEMA IF EXISTS bench CASCADE;
CREATE SCHEMA bench;

CREATE TABLE bench.customer (
  customer_id bigint PRIMARY KEY,
  segment text NOT NULL,
  region text NOT NULL
);

CREATE TABLE bench.product (
  product_id bigint PRIMARY KEY,
  category text NOT NULL,
  price numeric(10,2) NOT NULL CHECK (price > 0)
);

CREATE TABLE bench.orders (
  order_id bigint PRIMARY KEY,
  customer_id bigint NOT NULL REFERENCES bench.customer(customer_id),
  created_at timestamptz NOT NULL,
  status text NOT NULL
);

CREATE TABLE bench.order_item (
  order_id bigint NOT NULL REFERENCES bench.orders(order_id),
  line_no smallint NOT NULL,
  product_id bigint NOT NULL REFERENCES bench.product(product_id),
  quantity integer NOT NULL CHECK (quantity > 0),
  unit_price numeric(10,2) NOT NULL CHECK (unit_price > 0),
  PRIMARY KEY (order_id, line_no)
);

INSERT INTO bench.customer (customer_id, segment, region)
SELECT
  g,
  CASE g % 5
    WHEN 0 THEN 'enterprise'
    WHEN 1 THEN 'growth'
    ELSE 'standard'
  END,
  'region-' || (1 + g % 8)
FROM generate_series(1, 10000) AS s(g);

INSERT INTO bench.product (product_id, category, price)
SELECT
  g,
  'category-' || (1 + g % 20),
  round(5 + (g % 5000)::numeric / 10, 2)
FROM generate_series(1, 5000) AS s(g);

INSERT INTO bench.orders (order_id, customer_id, created_at, status)
SELECT
  g,
  CASE
    WHEN g % 10 < 6
      THEN 1 + ((g * 37 + (g / 10) * 13) % 100)
    ELSE 101 + (((g / 10) * 97 + (g % 10) * 53) % 9900)
  END,
  timestamptz '2026-03-01 00:00:00+00'
    + make_interval(days => (g % 180))
    + make_interval(secs => (g * 37 % 86400)),
  CASE
    WHEN g % 20 < 16 THEN 'completed'
    WHEN g % 20 < 19 THEN 'pending'
    ELSE 'cancelled'
  END
FROM generate_series(1, 300000) AS s(g);

INSERT INTO bench.order_item (
  order_id,
  line_no,
  product_id,
  quantity,
  unit_price
)
SELECT
  o.order_id,
  s.line_no::smallint,
  x.product_id,
  1 + ((o.order_id + s.line_no) % 3)::integer,
  p.price
FROM bench.orders AS o
CROSS JOIN LATERAL
  generate_series(1, 1 + (o.order_id % 4)::integer) AS s(line_no)
CROSS JOIN LATERAL (
  SELECT CASE
    WHEN (o.order_id + s.line_no) % 10 < 7
      THEN 1 + ((o.order_id * 31 + s.line_no * 17) % 50)
    ELSE 51 + ((o.order_id * 31 + s.line_no * 17) % 4950)
  END AS product_id
) AS x
JOIN bench.product AS p
  ON p.product_id = x.product_id;

ANALYZE bench.customer;
ANALYZE bench.product;
ANALYZE bench.orders;
ANALYZE bench.order_item;
预期结果
DROP SCHEMA
CREATE SCHEMA
CREATE TABLE
CREATE TABLE
CREATE TABLE
CREATE TABLE
INSERT 0 10000
INSERT 0 5000
INSERT 0 300000
INSERT 0 750000
ANALYZE
ANALYZE
ANALYZE
ANALYZE
首次执行时若 bench 不存在,DROP SCHEMA IF EXISTS 还会产生一条 NOTICE;它不影响结果。实际耗时取决于磁盘、WAL 配置和硬件。
验证规模与数据倾斜
先确认每张表的行数,再检查热点客户。生成规则让 60% 的订单落入前 100 个客户,前 100 个热点客户各有 1800 笔订单;其余订单分散到 9900 个长尾客户。
SELECT 'customer' AS relation, count(*) AS rows FROM bench.customer
UNION ALL
SELECT 'product', count(*) FROM bench.product
UNION ALL
SELECT 'orders', count(*) FROM bench.orders
UNION ALL
SELECT 'order_item', count(*) FROM bench.order_item;

SELECT customer_id, count(*) AS order_count
FROM bench.orders
GROUP BY customer_id
ORDER BY order_count DESC, customer_id
LIMIT 5;
预期结果
  relation  |  rows
------------+--------
 customer   |  10000
 product    |   5000
 orders     | 300000
 order_item | 750000

 customer_id | order_count
-------------+------------
           1 |       1800
           2 |       1800
           3 |       1800
           4 |       1800
           5 |       1800
第二个结果证明分布不是均匀随机数据。这样的热点会直接影响连接基数估计、缓存命中和不同索引策略的收益,因此比“每个键出现次数几乎相同”的测试数据更适合高级优化实验。
验证时间序列与复杂关联
最后执行一个固定时间窗口的四表关联。它同时过滤订单时间和状态,再按客户分群、商品分类聚合收入,可作为后续 EXPLAIN (ANALYZE, BUFFERS)、索引、扩展统计和 JOIN 策略实验的统一查询样本。
SELECT
  c.segment,
  p.category,
  count(*) AS line_count,
  round(sum(oi.quantity * oi.unit_price), 2) AS revenue
FROM bench.orders AS o
JOIN bench.customer AS c
  ON c.customer_id = o.customer_id
JOIN bench.order_item AS oi
  ON oi.order_id = o.order_id
JOIN bench.product AS p
  ON p.product_id = oi.product_id
WHERE o.created_at >= timestamptz '2026-07-01 00:00:00+00'
  AND o.status = 'completed'
GROUP BY c.segment, p.category
ORDER BY revenue DESC
LIMIT 5;
预期结果
 segment  |  category   | line_count |  revenue
----------+-------------+------------+-----------
 standard | category-17 |       8392 | 1657117.40
 standard | category-1  |       8029 | 1632541.00
 standard | category-13 |       4151 | 1611930.00
 standard | category-11 |       6966 | 1610724.00
 standard | category-15 |       5059 | 1607939.20
只要脚本未改动,这些行数与聚合结果就是稳定基线。后续实验可以改变索引、统计对象或查询写法,但应保持数据生成脚本与验证查询不变;否则执行时间变化可能来自数据分布变化,而不是优化本身。