
PostgreSQL / 系统课时
部分、表达式与覆盖索引
部分、表达式与覆盖索引
当普通多列索引仍然过大、函数条件无法命中索引,或查询只差几列就必须回表时,可以分别用部分索引、表达式索引和覆盖索引解决。关键不是“多建三个索引”,而是让索引结构精确匹配查询谓词、表达式和返回列。
学习目标
- 根据热点数据子集设计部分索引,并判断查询谓词是否能匹配它。
- 为函数或计算表达式建立可用索引,避免对整表逐行计算。
- 使用
INCLUDE构造覆盖索引,并理解仅索引扫描仍受可见性映射影响。
先准备可复现的数据
下面创建一张订单表,并让 open 订单只占较小比例。随后一次性建立三类索引,便于比较它们各自解决的问题。
DROP TABLE IF EXISTS orders_idx_demo;

CREATE TABLE orders_idx_demo (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    customer_id bigint NOT NULL,
    email text NOT NULL,
    status text NOT NULL,
    created_at timestamptz NOT NULL,
    total_cents integer NOT NULL
);

INSERT INTO orders_idx_demo (customer_id, email, status, created_at, total_cents)
SELECT
    (g % 5000) + 1,
    'user' || g || '@example.com',
    CASE WHEN g % 20 = 0 THEN 'open' ELSE 'closed' END,
    now() - (g % 120) * interval '1 day',
    1000 + (g % 50000)
FROM generate_series(1, 200000) AS g;

CREATE INDEX idx_orders_open_created
    ON orders_idx_demo (created_at DESC)
    WHERE status = 'open';

CREATE INDEX idx_orders_lower_email
    ON orders_idx_demo (lower(email));

CREATE INDEX idx_orders_customer_created_cover
    ON orders_idx_demo (customer_id, created_at DESC)
    INCLUDE (status, total_cents);

VACUUM (ANALYZE) orders_idx_demo;
预期输出
DROP TABLE
CREATE TABLE
INSERT 0 200000
CREATE INDEX
CREATE INDEX
CREATE INDEX
VACUUM
实际耗时会因机器和 PostgreSQL 配置不同而变化。
部分索引只保存真正需要的子集
部分索引通过 WHERE 把索引限制在满足条件的行上。示例中的 idx_orders_open_created 只保存 status = 'open' 的订单,因此体积和维护成本都低于覆盖整表的同类索引。
它只有在查询条件能够推出索引谓词时才可用。例如查询显式包含 status = 'open' 时,优化器可以利用该索引;如果只写 status IN ('open', 'closed'),就不能假定它仍会命中这个部分索引。参数化条件也要特别留意:规划阶段无法证明参数值满足部分索引谓词时,索引可能不会被选中。
表达式索引让函数条件变成可检索键
普通 email 索引不能直接为 lower(email) = ... 提供同样的查找键。表达式索引把 lower(email) 的结果写进索引,因此查询中的表达式必须与索引定义在语义上匹配。
用于索引表达式的函数必须满足 PostgreSQL 对索引表达式的不可变性要求。表达式索引适合大小写归一化等稳定计算,但会增加写入维护成本,不应为了“可能会查”给大量表达式预建索引。
覆盖索引减少回表
INCLUDE 列不参与 B-tree 排序和定位,只作为叶子项中的附加数据保存。查询按 customer_id, created_at 定位,同时只返回 status、total_cents 等已覆盖列时,PostgreSQL 有机会使用 Index Only Scan。
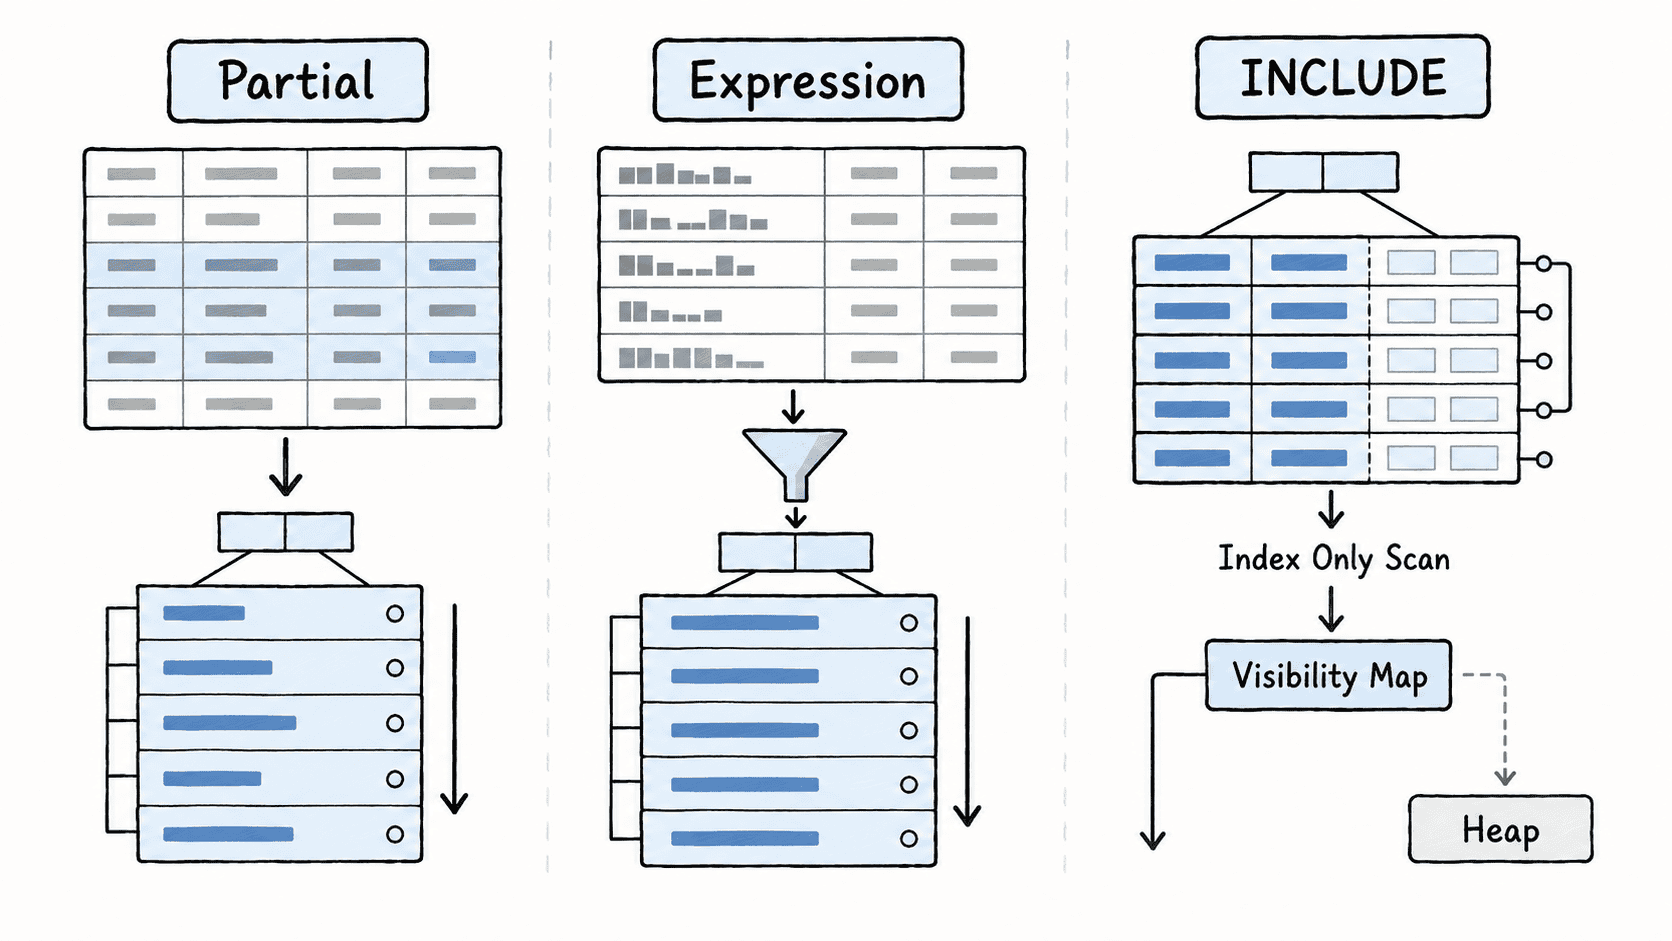
即使所有返回列都在索引中,也只有相关堆页被 visibility map 标记为 all-visible 时,执行器才能完全跳过堆访问。频繁更新的表可能仍出现 Heap Fetches,所以“覆盖”描述的是列集合,不是对物理访问路径的绝对保证。
用执行计划验证三类索引
下面分别验证三个典型查询。不要只根据索引名称判断设计是否成功,最终以执行计划中的扫描节点为准。
EXPLAIN (ANALYZE, BUFFERS)
SELECT id, created_at
FROM orders_idx_demo
WHERE status = 'open'
  AND created_at >= now() - interval '7 days'
ORDER BY created_at DESC
LIMIT 20;

EXPLAIN (ANALYZE, BUFFERS)
SELECT id
FROM orders_idx_demo
WHERE lower(email) = 'user123@example.com';

EXPLAIN (ANALYZE, BUFFERS)
SELECT customer_id, created_at, status, total_cents
FROM orders_idx_demo
WHERE customer_id = 42
ORDER BY created_at DESC
LIMIT 20;
预期结果
第一条计划应出现 idx_orders_open_created 对应的 Index Scan
第二条计划应出现 idx_orders_lower_email 对应的 Index Scan
第三条计划通常会出现 idx_orders_customer_created_cover 对应的 Index Only Scan
Heap Fetches: <VALUE>
<VALUE> 由可见性映射、缓存状态和数据变化决定,实际值可能不同。若第三条没有使用 Index Only Scan,先确认返回列是否全部被索引键或 INCLUDE 覆盖,再检查 VACUUM 后的可见性状态与优化器成本判断。
部分索引优先解决“只查热点子集”,表达式索引解决“条件写在函数或计算表达式上”,覆盖索引解决“定位列已经合适,但频繁回表取少量附加列”。三者可以组合,但每增加一个索引都会增加写入和存储成本,应以真实执行计划和查询频率决定是否保留。